
TRL documentation
OpenEnv統合による環境付きLLMの学習
OpenEnv統合による環境付きLLMの学習
OpenEnvは、強化学習(RL)およびエージェント型ワークフローにおける環境の定義、デプロイ、およびインタラクションを行うためのオープンソースフレームワークです。環境とのインタラクションのための標準化されたAPIを提供し、環境をバックエンドサーバーとして実行することをサポートしています(WebSocketまたはコンテナ化された実行を介して)。すぐに使用できるOpenEnv環境のコレクションは、Hugging Face Hubで確認できます。
このガイドでは、OpenEnvをTRLに統合する方法について説明します。OpenEnv自体の詳細については、OpenEnvのドキュメントを参照してください。
すぐに使える OpenEnv の例:
grpo_echo(最小構成)、grpo_catch、grpo_wordle、grpo_sudoku、grpo_multi_env、grpo_browsergym、grpo_carla、およびasync_grpo_harbor(ローカルおよび HF Jobs)。
環境を使用するタイミング
GRPOTrainerはエージェントの学習に使用できます。エージェントタスクでは、2つのモードをサポートしています。toolsモードでは、モデルが外部関数を呼び出すことができますが、各呼び出しはステートレスかつ独立しています。一方、environmentsモードではターン間で状態を保持するため、エージェントの行動が将来の観測に影響を与える、真のマルチターン対話が可能になります。連続性が重要な場合、例えばゲームのナビゲーション、ウェブページの閲覧、またはエージェントの次の観測がそれまでの行動に依存するタスクなどでは、environmentsを使用してください。
環境統合の選択
OpenEnv は、ここで説明されているネイティブなパスです。さらに、OpenReward と Harbor という2つの統合があり、これらは同じ environment_factory コントラクトに準拠しており、TRL レベルでは相互に交換可能です。タスクに最適なエコシステムを持つものを選択するには、GRPO ガイドの 環境統合の比較 を参照してください。
インストール
OpenEnvの環境はHugging Face Spacesとしてホストされており、これらはpipでインストール可能なGitリポジトリでもあります:
# Echo environment
pip install "openenv-echo-env @ git+https://huggingface.co/spaces/openenv/echo_env"

# Wordle (TextArena) environment
pip install "openenv-textarena @ git+https://huggingface.co/spaces/openenv/wordle"

# Catch (OpenSpiel) environment
pip install "openenv-openspiel-env @ git+https://huggingface.co/spaces/openenv/openspiel_env"
これにより、WebSocket 経由でリモート環境サーバーと通信する環境クライアント(例: EchoEnv)がインストールされます。また、アクション/オブザベーションモデルと、openenv を含むすべての必要な依存関係もインストールされます。
任意の環境のインストールコマンドは、その HF Space のページで確認できます。⋮ (3点リーダー)メニューをクリックし、“Use this Space”を選択すると、インストール手順が表示されます。
pip install "openenv>=0.3.1"を使用して PyPI からコアパッケージをインストールすることもできますが、環境固有の依存関係は別途インストールが必要な場合があります。
開発のために、OpenEnvリポジトリをクローンしてローカルにインストールできます:
git clone https://github.com/openenv/OpenEnv.git
cd OpenEnv/envs/echo_env
pip install -e .
TRLの各環境スクリプトにはインラインの依存関係メタデータ(PEP 723)が含まれており、uvを使用して直接実行することもできます。
uv run examples/grpo_echo/grpo_echo.pyこれにより、必要な環境パッケージが隔離された仮想環境に自動的にインストールされます。
クイックスタート
統合を理解する最速の方法は、完全な例を見ることです。echo.py スクリプトは、Echo environment を使用してモデルを学習します。この環境では、テキストの長さに基づいて補完に報酬が与えられます。
from datasets import Dataset
from echo_env import EchoEnv
from echo_env.models import EchoAction

from trl import GRPOConfig, GRPOTrainer

ENV_URL = "https://huggingface.co/proxy/openenv-echo-env.hf.space"

class EchoToolEnv:
    def __init__(self):
        self.env = EchoEnv(base_url=ENV_URL)
        self.reward = 0.0

    def reset(self, **kwargs) -> str | None:
        self.reward = 0.0
        return None

    def echo(self, message: str) -> str:
        """
        Echo the message back from the environment.

        Args:
            message: The message to echo

        Returns:
            The echoed message.
        """
        observation = self.env.step(EchoAction(message=message))
        self.reward = observation.observation.reward
        return observation.observation.echoed_message

def reward_func(environments, **kwargs):
    return [env.reward for env in environments]

dataset = Dataset.from_dict(
    {"prompt": [[{"role": "user", "content": "Try to echo 'Hello World!' in the environment."}]] * 64}
)

trainer = GRPOTrainer(
    model="Qwen/Qwen3-0.6B",
    train_dataset=dataset,
    reward_funcs=reward_func,
    args=GRPOConfig(
        chat_template_kwargs={"enable_thinking": False},
        log_completions=True,
    ),
    environment_factory=EchoToolEnv,
)
trainer.train()
以上です。内部で何が起きているか見てみましょう:
environment_factory=EchoToolEnv: トレーナーは各生成ごとにEchoToolEnvのインスタンスを1つ作成します(インスタンスではなくクラスを渡します)。reset()は、各エピソードの開始時に呼び出され、状態を初期化します。観測文字列(またはNone)を返します。- ツールの検出: トレーナーは環境インスタンス上のすべての公開メソッド(ここでは
echo())を検出し、それらを関数呼び出しツールとして公開します。各メソッドには型付き引数を持つ適切なドキュメント文字列(docstring)が必要です。トレーナーはこれを使用してツールのスキーマを構築します。 - マルチターンループ: トレーナーは補完を生成し、ツール呼び出しを解析して
echo()を実行し、結果を追加して再び生成します。この処理は、モデルがツール呼び出しを停止するか、max_completion_lengthに達するまで繰り返されます。 - 報酬関数: エピソードの終了後(環境がリセットされる前に)、各環境インスタンスから
env.rewardを読み取ります。
# Run the example
python examples/grpo_echo/grpo_echo.py

# Customize model and environment URL
python examples/grpo_echo/grpo_echo.py --model Qwen/Qwen3-0.6B --env-host https://huggingface.co/proxy/openenv-echo-env.hf.space
以下は、トレーニング中の報酬曲線です:
このページの上部にあるノートで、すぐに使えるOpenEnvのサンプルをさらに確認できます。
environment_factoryの動作
TRLのGRPOTrainerは、environment_factory引数を通じてインタラクティブな環境での学習をサポートしています。この引数が指定されると、トレーナーはマルチターンのツール呼び出しループを自動的に処理します。具体的には、補完を生成し、ツール呼び出しを解析し、環境に対してそれを実行し、その結果をモデルにフィードバックします。これにより、カスタムのロールアウトコードは不要になります。
Environmentクラスの要件
環境クラスは、これらのルールに従う必要があります。
__init__(self)(任意): 指定する場合は、引数を受け取らないようにしてください。状態やクライアントの初期化に使用します。外部設定(URL など)が必要な場合は、エンクロージングスコープまたはモジュールレベルの変数から取得してください。reset(self, **kwargs): エピソードの開始時に呼び出されます。すべてのデータセットの列をキーワード引数として受け取ります。文字列の観測値を返します(初期の観測値がない場合はNoneを返します)。- ツールメソッド:
reset以外の、_で始まらないすべての公開メソッドは、自動的にツールとして公開されます。トレーナーがモデル用のツールスキーマを生成するためにこれらを使用するため、各ツールメソッドにはArgs:説明付きのドキュメント文字列(docstring)が必要です。
環境クラスのヒント
- 報酬の状態: 環境インスタンスに任意の状態(例:
self.reward、self.doneなど)を保存し、environmentsパラメータを介して報酬関数からアクセスできます。このパターンの例については、クイックスタートガイドを参照してください。 - エラー処理: ツールメソッドが例外を送出した場合(例:
ValueError("Game over."))、トレーナーはそれをキャッチし、エラーメッセージをツールレスポンスとしてモデルにフィードバックします。アクションが無効であること、またはエピソードが終了したことを示すための推奨方法です。
ENV_URL = "https://huggingface.co/proxy/my-env.hf.space"

class MyEnv:
    def __init__(self):
        self.client = MyClient(base_url=ENV_URL)  # captured from enclosing scope
        self.reward = 0.0

    def reset(self, **kwargs) -> str | None:
        self.reward = 0.0
        return "Initial observation for the model"

    def my_tool(self, arg1: str, arg2: int) -> str:
        """
        Description of what this tool does.

        Args:
            arg1: Description of arg1
            arg2: Description of arg2

        Returns:
            The result message.
        """
        self.reward = 1.0
return "Tool result"ツールは、記述的な名前と型付きの引数を持つ個別のメソッドである必要があります(例:
guess(word: str)、move(direction: str))。モデルがツール呼び出しを学習するには、意味のあるツール名と引数の説明が必要であるため、step(action)のような汎用的なメソッドの使用は推奨しません。
報酬関数
報酬関数はenvironmentsパラメータ(環境インスタンスのリスト)を受け取るため、エピソード中に保存された任意の状態にアクセスできます。
def reward_func(environments, **kwargs) -> list[float]:
return [env.reward for env in environments]報酬関数に関する詳細については、GRPO - カスタム報酬関数を参照してください。
報酬関数のヒント
OpenEnv環境とGRPOを扱う際に、有用だと感じたポイントをいくつかご紹介します。
- グループが異なることを確認してください。GRPO はグループ内の補完を比較するため、絶対的な値よりも相対的なランキングが重要であり、すべての補完が同じ報酬を得るグループからはシグナルが得られません。モデルが時折成功する場合は、バイナリ報酬(成功時は 1.0、それ以外は 0.0)が明確です。成功が稀な場合は、部分点を追加してください。Sudoku の例では解いた報酬に埋まったセルの割合を、Wordle の例では最良の推測のグリーン数を加算しています。
- 最終的な状態を確認し、経路を確認しない。 可能な場合は、特定のアクションのシーケンスに従ったかどうかを確認するのではなく、環境に結果を判定させる(例:「モデルはパズルを解けたか?」)。これにより、モデルは独自の戦略を発見する自由が得られます。
- 学習前に報酬を検証してください。 数エピソードを手動で実行し(Wordleのサンプルノートブックを参照)、環境が妥当な報酬を返していることを確認してください。能力のあるモデルでもランダムベースラインより高いスコアを出せない場合は、報酬シグナルの調整が必要かもしれません。
マルチターンエピソードにおけるmax_completion_length
max_completion_length パラメータは、単一の生成だけでなく、マルチターン会話全体にわたるトークンの総数(すべてのモデル生成とツール結果の合計)を制限します。ターン数が多い環境(数十手の移動がある Sudoku など)では、この値を大きくする必要がある場合があります:
args = GRPOConfig(
    max_completion_length=4096,  # default is usually 256-1024, increase for long episodes
    # ...
)
エピソードが途中で打ち切られている場合(ゲームの途中でモデルが停止する)、原因はこれである可能性が高いです。
スペースに対する長時間の実行
Space は数時間開いたままの WebSocket を閉じる場合があります(約2時間ごとに発生するのを確認しました)。OpenEnv クライアント 0.11.0 以前では、新しい環境セッションに再接続し、ゲームが進行中だった場合、次の step() がクライアントでリセットされていないゲームで実行され、エラーも発生しません。OpenEnv 0.12.0 以降では、代わりに SessionLostError が発生するため、ゲームは失敗します。学習中に切断が起きないようにするには、reset() で新しいクライアントを開き、各接続が1エピソードに留まるようにし、古いセッションは非同期で解放されるため、同時にプレイされるゲーム数より少し大きくなるように MAX_CONCURRENT_ENVS を設定してください。
def reset(self, **kwargs) -> str | None:
    self.client.close()
    self.client = TextArenaEnv(base_url=env_url).sync()
    result = self.client.reset()
    ...
高度な例: Wordle
TextArena 環境を使用して、Wordle をプレイするモデルを学習しましょう。これにより、マルチターン対話、累積フィードバックの処理、複数の項に分割された報酬、および例外によるエピソード終了がデモされます。
OpenEnv Wordle チュートリアルでは、SFT データ、SFT ウォームアップ、この GRPO ステップ、評価、そしてハードウェアとコストまで、パイプライン全体をカバーしています。この例のノートブック版は
grpo_wordle.ipynbです。
TextArena環境
TextArenaは、Wordle、Snake、Tic-Tac-Toeなどのテキストベースのゲームを用いてLLMの推論能力を評価するために設計された、競合型テキストゲームのオープンソースコレクションです。

なぜWordleなのか
Wordleは、フィードバックについて推論する必要があり、完全にテキストベースであり、10億パラメータのモデルでも性能を向上させることができるため、環境ベースの強化学習にとって優れたベンチマークです。
Wordleはどのように機能しますか? Wordleは、プレイヤーが6回の試行で5文字の単語を当てる単語推測ゲームです。各推測の後、環境は文字ごとのフィードバックを提供します:
G U E S S
X G Y X X
X = 単語に含まれない、G = 正しい位置(緑)、Y = 位置が異なる(黄)。ここでは、“U”は正しく正しい位置にあり、“E”は単語に含まれるが位置が異なります。
SFTウォームアップから開始
Qwen3-1.7B はほとんどゲームに勝てないため、ベースモデルからの GRPO は学習すべきものがほとんどありません。1 回のグループ内で誰も勝てないゲーム群では、シグナルが得られないためです。この例は、同じツール呼び出し形式で、各推測の前に短い推論を行うソルバーがプレイした 1,000 回のゲーム を 1 エポック間学習させた openenv/Qwen3-1.7B-Wordle-SFT から開始します。
Environmentクラス
WordleEnv クラスは TextArena クライアントをラップし、guess() をツールとして公開するとともに、報酬に必要な情報を保持します。
import re

from textarena_env import TextArenaAction, TextArenaEnv

FEEDBACK = re.compile(r"Feedback:\n([A-Z ]+)\n([GYX ]+)")

class WordleEnv:
    def __init__(self):
        self.client = TextArenaEnv(base_url="https://<user>-wordle.hf.space")

    def reset(self, **kwargs) -> str | None:
        result = self.client.reset()
        self._last_full_feedback = result.observation.messages[0].content
        self.done = False
        self.won = False
        self.num_guesses = 0
        self.best_greens = 0
        self.invalid_moves = 0
        return self._last_full_feedback

    def guess(self, guess: str) -> str:
        """
        Make a guess in the Wordle environment.

        Args:
            guess: The guessed word, formatted as '[abcde]'

        Returns:
            The feedback message from the environment.
        """
        if self.done:
            raise ValueError("Game over.")
        result = self.client.step(TextArenaAction(message=guess))
        _full_feedback = result.observation.messages[0].content
        feedback = _full_feedback[len(self._last_full_feedback):]
        self._last_full_feedback = _full_feedback
        if "invalid move" in feedback.lower():
            self.invalid_moves += 1
        else:
            self.num_guesses += 1
            match = FEEDBACK.search(feedback)
            if match:
                self.best_greens = max(self.best_greens, match.group(2).count("G"))
            self.won = result.done and result.reward >= 1.0
        self.done = result.done
        return feedback
主な設計上の選択:
reset()は、モデルが最初に見る観測値として、初期のゲームメッセージを返します。guess()が唯一のツールです。モデルは各ターンで5文字の単語を引数として呼び出します。- 累積フィードバックのスライシング: TextArenaは各ターンでゲームの完全な履歴を返します。コンテキストの重複を避けるため、新しい部分のみを切り出します。
- done 時の例外: ゲーム終了後にモデルが推測を試みると、
guess()はValueErrorを送出します。トレーナーはこの例外を捕捉し、"Game over."をツール応答としてモデルにフィードバックするとともに、tools/failure_frequencyにカウントします。
報酬関数と学習
環境自体の報酬は、推測が1回でも6回でも勝利時に同じ額を支払うため、部分点はゲームの終了時のみ付与されます。思考を有効にすると、エージェントは思考を減らし、6回の推測すべてを使ってゲームの終了に到達することを学習する可能性があります。これを避けるために、報酬には3つの項が含まれます。
from datasets import Dataset
from trl import GRPOConfig, GRPOTrainer

def reward_win(environments, **kwargs) -> list[float]:
    return [1.0 + 0.5 * (1 - env.num_guesses / 6) if env.won else 0.0 for env in environments]

def reward_partial(environments, **kwargs) -> list[float]:
    return [0.0 if env.won else 0.1 * env.best_greens for env in environments]

def reward_invalid(environments, **kwargs) -> list[float]:
    return [-0.1 * env.invalid_moves for env in environments]

prompt = """You are an expert Wordle solver with deep knowledge of English vocabulary...
Use the tool `guess` to make a guess."""

dataset = Dataset.from_dict({"prompt": [[{"role": "user", "content": prompt}]] * 600})

trainer = GRPOTrainer(
    model="openenv/Qwen3-1.7B-Wordle-SFT",
    reward_funcs=[reward_win, reward_partial, reward_invalid],
    train_dataset=dataset,
    args=GRPOConfig(
        use_vllm=True,
        vllm_mode="colocate",
        chat_template_kwargs={"enable_thinking": True},
        max_completion_length=4096,
        max_tool_calling_iterations=12,
        vllm_importance_sampling_mode="token_truncate",
        num_generations=16,
        per_device_train_batch_size=8,
        gradient_accumulation_steps=8,
        learning_rate=1e-6,
        lr_scheduler_type="constant",
        max_steps=150,
    ),
    environment_factory=WordleEnv,
)
trainer.train()勝利の報酬は、勝利が早くなるほど高くなります(1回の推測で1.42、6回で1.0)。敗北の報酬は、ゲームが終了したかどうかに関わらず、そのゲームにおける最良の推測に基づいて支払われます。また、各無効な操作は0.1のコストを発生させます。TRLは各用語を個別にログに記録するため、rewards/reward_win/meanは勝利率の上昇に伴って増加します。
例の実行
各ステップでは、1つの環境セッションずつ、合計64ゲームがプレイされます。openenv/wordle Spaceを複製し、複製したコピーでMAX_CONCURRENT_ENVS=64変数を設定してください。
Colocateモード(1 GPU、推奨)
python examples/grpo_wordle/grpo_wordle.py --vllm-mode colocate --env-url https://<user>-wordle.hf.space
これは、vLLMをトレーニングと同じプロセスで実行するもので、GPUは1枚のみで済みます。今回の実行では、A100 80GB 1枚で150ステップに約2時間15分かかりました。
サーバーモード(2以上のGPU、スケーラブル)
# Terminal 1: Start vLLM inference server
CUDA_VISIBLE_DEVICES=0 VLLM_SERVER_DEV_MODE=1 vllm serve openenv/Qwen3-1.7B-Wordle-SFT --host 0.0.0.0 --port 8000 \
    --weight-transfer-config '{"backend": "nccl"}' \
    --logprobs-mode processed_logprobs \
    --max-logprobs -1

# Terminal 2: Run GRPO training with OpenEnv
CUDA_VISIBLE_DEVICES=1 python examples/grpo_wordle/grpo_wordle.py --vllm-mode server --vllm-server-url http://localhost:8000 \
    --env-url https://<user>-wordle.hf.space
結果
モデルごとに1回のトレーニング実行を行い、同じ30語をグリーディにプレイした当社の実行結果から:
| モデル | 勝利 | 勝利あたりの推測回数 | 無効な推測 |
|---|---|---|---|
| Qwen3-1.7B | 0/30 | - | 24 |
| + SFT | 10/30 | 3.2 | 41 |
| + SFT + GRPO (モデル) | 20/30 | 4.1 | 3 |
GRPOは、繰り返しや捏造された単語をほぼ排除し、勝利数を増加させました。新規の勝利の多くは4〜6回の推測で達成されたため、勝利あたりの推測数は増加しました。30の単語は、TextArenaが秘密の単語として使用する156の名詞から選ばれており、モデルは学習段階でもこれらを目にしています。新しい実行では、勝利数がわずかに異なる結果になる可能性があります(同じレシピでSFTを2回実行した場合、勝利数はそれぞれ10回と13回でした)。3つのモデルのプレイをWordle Arenaで視聴し、学習曲線はTrackioで確認できます。
マルチ環境トレーニング
複数の環境で同時に1つのモデルを学習させることができます。これは、モデルに異なるスキルを並行して学習させたい場合に便利です。例えば、Wordle(言語推論)とCatch(空間推論)を同じ学習実行でプレイさせることです。
重要なアイデアは、複数の環境をラップし、データセットの列を使用して各サンプルを正しい環境にルーティングするメタ環境クラスを作成することです。
仕組み
- データセットに、各サンプルがどの環境に属するかを識別する
"env"列(または同様のもの)を追加します。 reset(**kwargs)内で、kwargs["env"]を読み取り、そのエピソードで使用するアクティブな環境を選択します。- すべての環境からツールを公開します。トレーナーはすべての公開メソッドを検出します。
- 環境ごとに個別の報酬関数を使用し、その環境に属さないサンプルには
Noneを返します。TRLはNoneの値をnansum/nanmeanで処理します。
例: Wordle + Catch
grpo_multi_env.py スクリプトは、Wordle と Catch を同時に学習します。
class MultiEnv:
    def __init__(self):
        self._wordle_client = None
        self._catch_client = None
        self.active = None
        self.reward = 0.0
        self.done = False

    def reset(self, **kwargs) -> str | None:
        self.active = kwargs.get("env", "wordle")
        self.reward = 0.0
        self.done = False

        if self.active == "wordle":
            if self._wordle_client is not None:
                try:
                    self._wordle_client.close()
                except Exception:
                    pass
            self._wordle_client = TextArenaEnv(base_url=WORDLE_URL)
            result = self._wordle_client.reset()
            self._last_full_feedback = result.observation.messages[0].content
            self.reward = 0.0
            return self._last_full_feedback
        elif self.active == "catch":
            if self._catch_client is not None:
                try:
                    self._catch_client.close()
                except Exception:
                    pass
            self._catch_client = OpenSpielEnv(base_url=CATCH_URL)
            result = self._catch_client.reset()
            self.done = result.observation.done
            return _format_catch_obs(result.observation.info_state)

    # Wordle tool
    def guess(self, guess: str) -> str:
        """Make a guess in the Wordle environment. ..."""
        ...

    # Catch tools
    def move(self, direction: str) -> str:
        """Move the paddle left or right. ..."""
        ...

    def stay(self) -> str:
        """Do nothing and let the ball fall one step. ..."""
        ...
主要なパターン:
- クライアントの遅延初期化: 不要な WebSocket 接続を避けるため、クライアントは
__init__()ではなくreset()内で作成してください。 - 再オープン前にクローズ: サーバー容量エラーを回避するために、新しいクライアントを作成する前に、以前のクライアントをクローズします。
kwargsルーティング: データセットの"env"列は、reset()にキーワード引数として渡されます。- すべてのツールが同時に公開されます: アクティブな環境に関わらず、モデルは
guess、move、stayを利用可能なツールとして認識します。誤ったツールを呼び出した場合(例: Wordle 中にmoveを呼び出す)、このメソッドはValueErrorを発生させますが、トレーナーはこれを適切にキャッチします。実際には、モデルはシステムプロンプトに基づいて正しいツールを使用することを学習します。
環境ごとの報酬関数
各報酬関数は、他の環境からのサンプルに対してNoneを返します:
def wordle_reward(environments, **kwargs) -> list[float | None]:
    return [env.reward if env.active == "wordle" else None for env in environments]

def catch_reward(environments, **kwargs) -> list[float | None]:
    rewards = []
    for env in environments:
        if env.active != "catch":
            rewards.append(None)
        elif env.done:
            rewards.append(max(env.reward, 0.0))
        else:
            rewards.append(0.0)
    return rewards
TRL は内部的に None を nan に変換し、集約には nansum/nanmean を使用するため、各サンプルは関連する報酬関数によってのみスコアリングされます。
環境ルーティング付きのDataset
n = 500
dataset = Dataset.from_dict({
    "prompt": (
        [[{"role": "user", "content": wordle_prompt}]] * n
        + [[{"role": "user", "content": catch_prompt}]] * n
    ),
    "env": ["wordle"] * n + ["catch"] * n,
})
マルチ環境の例の実行
python examples/grpo_multi_env/grpo_multi_env.py \
    --wordle-url https://huggingface.co/proxy/openenv-wordle.hf.space \
    --catch-url https://huggingface.co/proxy/openenv-openspiel-env.hf.space \
    --vllm-mode colocate \
    --gradient-accumulation-steps 4 \
    --num-generations 8
複数の環境にまたがって学習を行う場合、統合された
train/rewardではなく、報酬関数ごとのメトリクス(train/reward_func_0、train/reward_func_1など)を監視してください。統合メトリクスは環境間で交互に切り替わるため、ノイズが多く見えることがあります。
環境の実行
environment_factoryを使用する場合、トレーナーは環境サーバーに自動的に接続します。サーバーが実行されていることのみが必要です。OpenEnv環境サーバーを実行する方法は3つあります。
リモートの Hugging Face Space に接続する (最も簡単)
ほとんどのサンプルスクリプトは、ホストされたSpaceをデフォルトとして使用します(セットアップは不要です):
env = EchoEnv(base_url="https://huggingface.co/proxy/openenv-echo-env.hf.space")学習には、並行処理の問題を避けるために、Space を自分のアカウントに複製してください。トレーナーは N 本の WebSocket 接続を同時に開きます(1 生成あたり 1 本)が、共有 Space ではこれがサポートされない場合があります。詳細は Server concurrency を参照してください。
Docker コンテナ (本番環境に推奨)
docker run -d -p 8001:8000 --platform linux/amd64 registry.hf.space/openenv-echo-env:latest
次に接続します:
env = EchoEnv(base_url="http://0.0.0.0:8001")ポート 8001 を 8000 にマッピングすることで、vLLM サーバー用にポート 8000 を空けておきます。
コンテナをプログラムから起動することもできます:
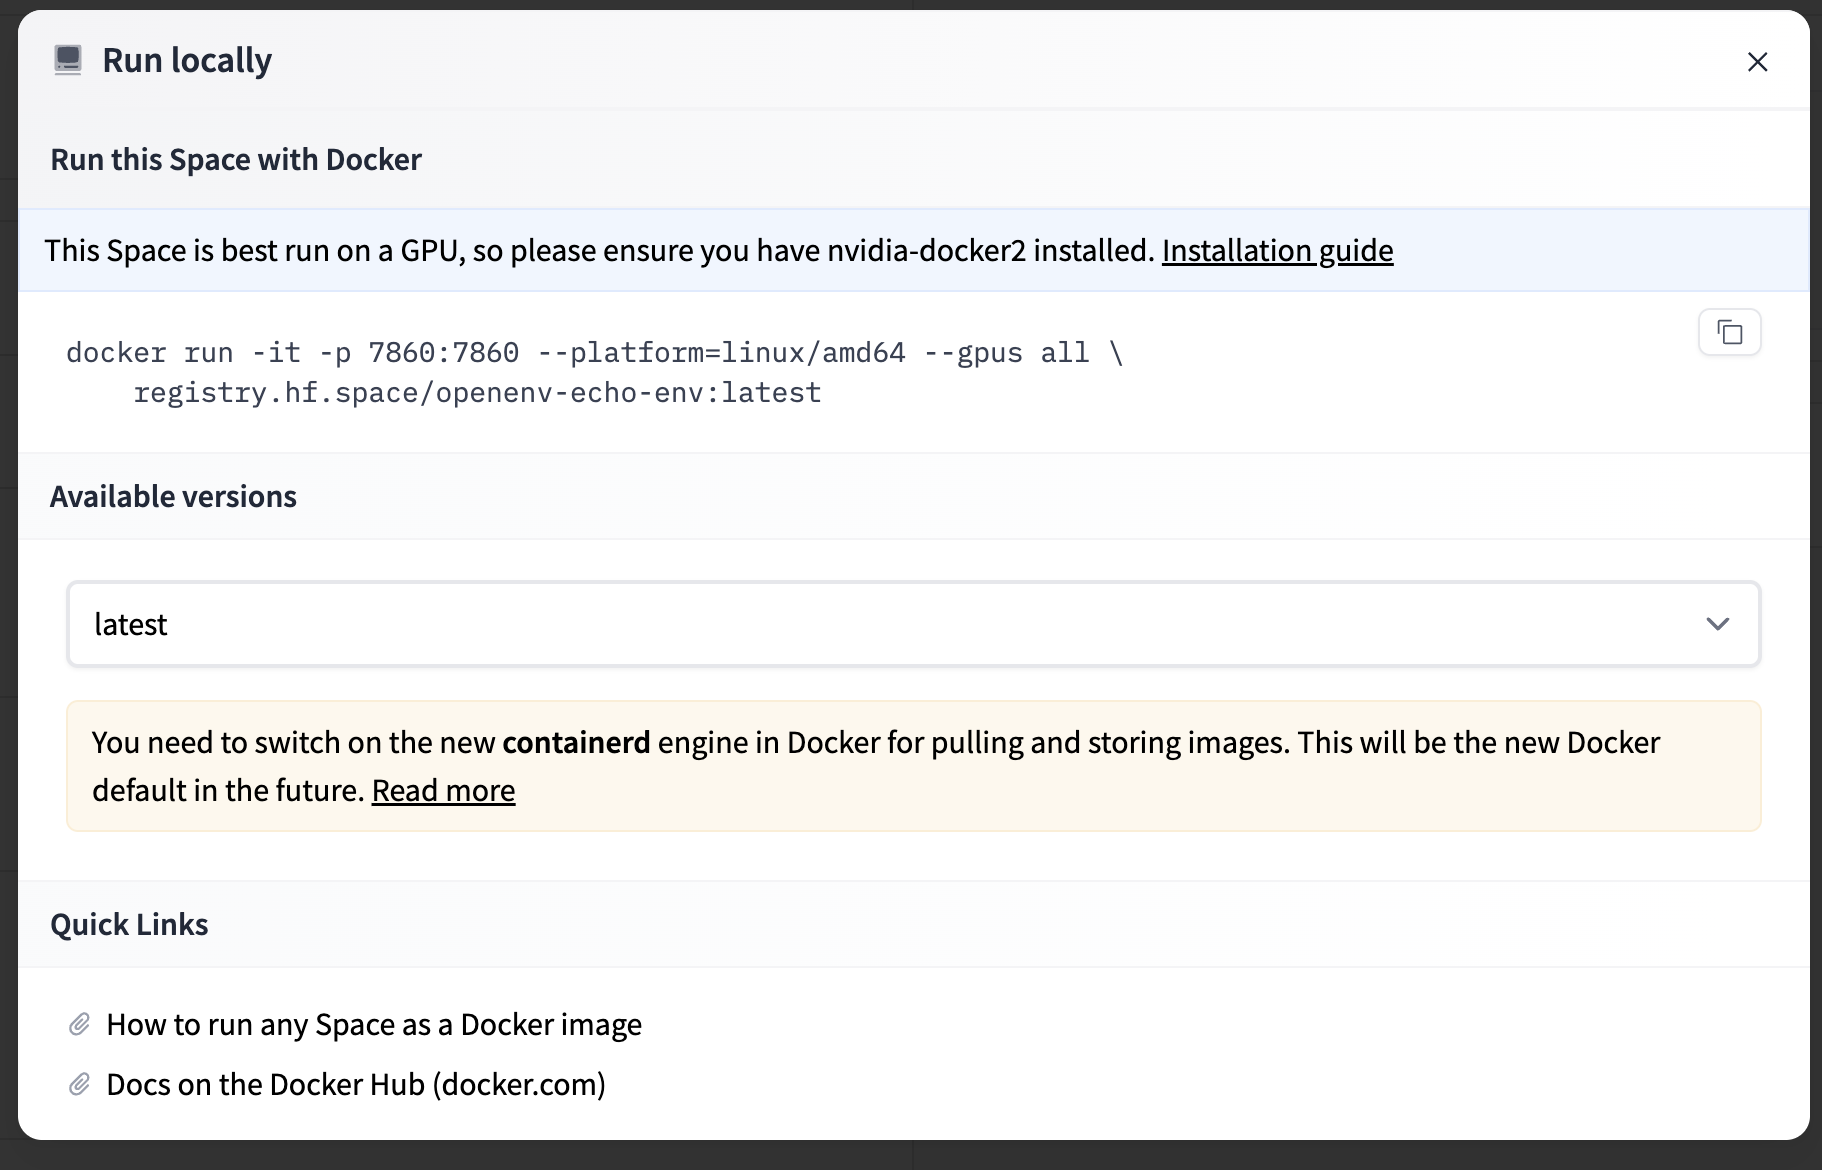
env = EchoEnv.from_docker_image("registry.hf.space/openenv-echo-env:latest")Hub上の任意のSpaceのDockerイメージを見つけることができます。Spaceのページを開き、⋮ (3点リーダー) → “Run locally.” の順に選択してください。
ローカル Python プロセス (開発用)
hf download openenv/echo_env --repo-type=space --local-dir=echo_env
python -m uvicorn echo_env.src.envs.echo_env.server.app:app --host 0.0.0.0 --port 8001
次に接続します:
env = EchoEnv(base_url="http://0.0.0.0:8001")詳細については、OpenEnvカタログを参照してください。
環境カタログ
メンテナンスされている現在の環境カタログを調べる最善の方法は、公式のOpenEnvカタログを参照することです。
独自の環境を作成するには、OpenEnv による独自の環境の構築のガイドを参照してください。環境は Hub と密接に統合されているため、コミュニティが再利用できるように新しい環境をプッシュできます。
サーバーの並行性
environment_factoryを使用する場合、トレーナーはN個の環境インスタンス(生成ごとに1個)を作成し、それぞれがサーバーへのWebSocket接続を開きます。デフォルトでは、OpenEnvサーバーは同時セッションを1つしか許可しないため、トレーニング中に失敗が発生します。
並列トレーニングをサポートするために、サーバーを並行処理用に設定します:
- 環境ファイルで、並行セッションのサポートを宣言します:
SUPPORTS_CONCURRENT_SESSIONS: bool = True- サーバーアプリで、同時実行数の上限を設定します:
app = create_app(
    create_my_environment,
    MyAction,
    MyObservation,
    max_concurrent_envs=64,  # match or exceed generation_batch_size
)
max_concurrent_envsはgeneration_batch_size(デフォルトはper_device_train_batch_size × gradient_accumulation_steps)以上である必要があります。例えば、gradient_accumulation_steps=64かつバッチサイズが 1 の場合、少なくとも 64 個の同時セッションが必要です。
environment_factory と rollout_func
GRPOTrainerは、環境ベースの学習に2つのアプローチをサポートしています:
environment_factory(推奨):ツールメソッドを含む環境クラスを定義し、生成、ツール呼び出しの解析、マルチターンループをトレーナーが自動的に処理します。このガイド全体でこのアプローチを使用しています。rollout_func: 生成と環境との相互作用ループ全体を自分で記述します。これにより、補完の生成方法、ツールの実行方法、報酬の計算方法について完全な制御が可能になります。
environment_factory が使用ケースに合わない場合は、rollout_func を使用してください。例えば、生成ループを外部サーバーが所有し、独自のエージェントと環境の相互作用プロトコルを管理する外部エージェントサーバーなどが該当します。
ハーネスでのトレーニング: 実際のコーディングエージェントのトレーニング (Harbor)
上記の統合はホワイトボックスです。TRLがマルチターンループを直接制御します。各ターンでサンプリングを行い、ツール呼び出しを解析して実行し、その結果をフィードバックします。
一部のエージェントは、独自のループを所有しているため、この方法では駆動できません。opencode や claude-code といった本番環境向けのコーディングエージェントハーネスは、独自のプランナー、ツールセット、コンテキスト管理、停止条件を備えています。再実装ではなく、そのエージェントそのものを学習させたいはずです。
これを実現するために、TRLはAsyncGRPOTrainerを基盤とした実験的なブラックボックス(ループ所有)パスを提供しています。HarnessAsyncGRPOTrainerはOpenEnvのセッションファクトリを駆動します。エージェントとそのサンドボックスはHarborから提供され、openenv harbor serveを通じてOpenEnvで配信されるため、Harborがインストールするすべてのエージェントを同じ方法で学習できます。--harnessで1つを選択します。完全な例(Hugging Face Jobsのランチャーを含む)は、examples/async_grpo_harborを参照してください。
このパスには、
TrainingTraceキャプチャAPIを初めて搭載したリリースであるopenenv>=0.7.0が必要です:pip install "openenv>=0.7.0"。
仕組み
TRL はここでは各ターンをサンプリングしません。エージェントは独自に完了まで実行され、TRL はその実行内容を読み戻します。
- OpenEnv Harbor サーバーは、サンドボックス(E2B など)内で Harbor タスクに対してエージェントを起動します。エージェントが実行するすべてのモデル呼び出しは、サーバーのキャプチャプロキシを介して vLLM サーバーに送信され、エンジン自体のプロンプトおよび補完のトークン ID、サンプリングされた logprobs、トークンごとのロスマスクが記録されます。
- エージェントが停止すると、タスク自身の検証器が結果をスコアリングし、TRL は OpenEnv から検証済みの
TrainingTraceを受け取り、そのトークン ID とマスクからトレーニング行を構築します。TRL はキャプチャされたプロンプトを再トークナイズしません。 - GRPOはこれらの行で学習を行います。報酬はグループ相対アドバンテージを通じて、学習されたすべてのトークンに伝播され、新しい重みは同じvLLMサーバーに同期されます。
各ロールアウトは、独自のサンドボックスとキャプチャセッションを備えた、独立したセッション内で実行されます。この分離は2つの理由で重要です。プロキシが対象のロールアウトのトークンを正確にキャプチャする必要があること、そしてあるロールアウトが他のロールアウトに干渉してはならないことです。max_concurrent_rolloutsの設定は、同時に実行されるロールアウトの数を制御します。サーバーのMAX_CONCURRENT_ENVSは、少なくともmax_concurrent_rollouts + 1以上である必要があります(ファクトリはタスクメタデータ用に1つの追加の接続を保持するためです)。
配線
HarnessAsyncGRPOTrainer は、AsyncGRPOTrainer と同様にモデル、設定、データセットを受け取りますが、reward_funcs、tools、environment_factory の代わりにセッションファクトリを使用します。harness_adapter が指定されていない場合、エージェントがループを所有します。トレーナーは独自のサンプリングポリシーでセッションファクトリを構築するため、ビルド済みのファクトリではなく、partial(HarborSessionFactory, ...) のような呼び出し可能オブジェクトを渡します。各セッションは、正確なエンジントークン、行動ログ確率、プリフィルドマスクを含む OpenEnv の TrainingTrace を返します。rollout_reward_fn は任意です。指定しない場合、TRL はセッションの検証器報酬を使用します。
from functools import partial

from harbor_env.harness import HarborSessionFactory

from trl import AsyncGRPOConfig
from trl.experimental.async_grpo.openenv_harness import HarnessAsyncGRPOTrainer

factory = partial(
    HarborSessionFactory,
    "http://localhost:8200",       # the OpenEnv Harbor server
    split="<hf-dataset>",          # a Harbor task dataset the server serves
    harness="mini-swe-agent",      # or "opencode", "claude-code", ...
    sandbox="e2b",
    llm_url=vllm_url,
    model=model,
)
config = AsyncGRPOConfig(num_generations=8, max_concurrent_rollouts=8, vllm_server_base_url=vllm_url)
trainer = HarnessAsyncGRPOTrainer(
    model=model,
    harness_session_factory=factory,  # called by the trainer with its sampling policy
    args=config,
    train_dataset=dataset,
    rollout_reward_fn=my_reward,      # outcome -> float | None
)
trainer.train()
定義する必要があるもの
OpenEnv はキャプチャの検証とトークンの選択を担当します。TRL はプロデューサーのフルシーケンスマスクを内部の補完マスクに変換し、結果として得られた行をパッキングして GRPO を適用します。トークンの再構築や、どの呼び出しがエージェントに属するかを推測することはありません。
rollout_reward_fn : ロールアウトのスコアリング方法
Callable[[HarnessRolloutOutcome], float | None]
TRLは、タスクにおける成功の定義を把握していません。そのため、完了した各ロールアウトをスカラー報酬に変換します。この関数は、エージェントが実行した内容を記述するHarnessRolloutOutcomeを受け取ります。
env_reward(float | None): タスクの検証器からの報酬。ロールアウトがスコアリングできなかった場合はNone。completion(list[dict]): 最終的なメッセージのトランスクリプト。trace(list[TraceEntry]): 選択された OpenEnv のキャプチャ記録です。ゼロマスクされたターンも含まれます。tool_call_countとtool_failure_count(int): エージェントが実行したツール呼び出しの回数と、失敗と判断された回数を示します。tool_calls_by_name(dict[str, int]): ツールごとの呼び出し回数。例:{"bash": 3, "edit": 2}timed_out(bool): エージェントが時間予算を使い切ったかどうかを示します。
floatを返すか、ロールアウトを採点不能としてマークし、グループベースラインから除外されるようにNoneを返します。ゼロとしてカウントされるのを防ぐためです。この関数を渡さない場合、生のenv_rewardがそのまま使用されます。Harborの例では、検証器の正解性を主なシグナルとし、タスクが解決された場合のみ、ツール効率の小さなボーナスを追加しています。
なぜ検証器をそのまま使わないのか 検証器は環境側の責務であり、「結果はどの程度正しかったか」という1つの質問に答えることで、評価用途でもクリーンかつ再利用可能に保たれます。学習に使用する報酬は、学習時の判断として別途設計されるもの(スコアの二値化、退化した行動へのペナルティ、スコアリング不能なロールアウトの除外)です。また、検証器は最終結果のみを参照するため、
rollout_reward_fnは検証器が見ることのないシグナル(ツール使用回数、timed_out、トレース)も受け取ります。例えば、あるロールアウトが一部のテストに合格してもbashを一度も実行しない場合がありますが、これを検知してペナルティを課すことができるのはrollout_reward_fnのみです。
トークンの適格性はOpenEnvから得られます
session.fetch_training_trace() は検証済みのTrainingTraceを返します。各ターンには一意のnode_id、prompt_token_ids、completion_token_ids、per_token_logps、およびプロンプトと補完全体に対する必須のloss_maskが含まれます。プロンプトの位置はゼロです。アシスタントの応答内のゼロを含む部分補完マスクは保持されます。
例えば、プロンプト[10, 11]、補完[20, 21, 22]、マスク[0, 0, 1, 0, 1]の場合、トークン20と22で学習が行われます。トークン21はコンテキストとして保持されます。完全にマスクされた補完は、コンテキストおよび使用量のカウントのために保持されます。
プロデューサーは補助的な呼び出しと破棄されたリトライを除外します。この API には train_turn_fn や agent_turn_fn パラメータはありません。既存の統合では、選択処理を OpenEnv のマスクに移行する必要があります。タスクの検証器は、トークンの適格性から独立したままです。
不正なキャプチャはOpenEnvの境界で失敗し、トレーニングを停止します。トランスポートの失敗はスコアリング不能のままです。書き換えられた履歴は別の行から始まり、サンプリングされたトークンとlogprobsが保持されます。複数の行は依然としてロールアウトの報酬を共有します。このAPIはGRPOの重み付けを変更しません。
メトリクス
harness trainerは、AsyncGRPOTrainerのツールメトリクスを同じ名前で記録しますが、以下の点で異なります:
- エージェントがループを所有している場合(
harness_adapterがない場合)、失敗は最後のリクエストのツール結果から推定されます。結果のテキストにerror、failed、traceback、またはexception(大文字小文字を区別しない)が含まれている場合、その結果は失敗とカウントされます。また、ツール名と最初の200文字が同じ結果は1回のみカウントされます。tools/latency_sおよびtools/<name>/latency_sは記録されません。OpenEnvのトレースにはタイムスタンプがないためです。 harness_adapterを使用する場合、ハーネスがエラーを報告したツール呼び出しは失敗とカウントされます。1回のモデル応答と次のリクエストの間の時間は、そのターン内のツール呼び出しに均等に分割され、tools/latency_sとして記録されるため、ハーネス自体のオーバーヘッドも含まれます。最後のターンは計時されません。tools/unknown_name_count、tools/parallel_calls_mean、tools/loop_exhausted_fracは組み込みのツールループから由来するもので、ログには記録されません。- トレーナー自体にはツールがないため、
tools/call_frequencyとtools/failure_frequencyは、少なくとも1つのロールアウトがツールを呼び出したグループのみをカウントします。 rollout/correctness_meanは、rollout_reward_fnが指定された場合のみ記録されます。これは、検証器のenv_rewardを、報酬を持つロールアウト全体で平均したものです。
要件
OpenEnv Harbor サーバーはデータセットとサンドボックスを管理します。サンドボックスバックエンドの認証情報(例: E2B_API_KEY)が必要です:
MAX_CONCURRENT_ENVS=9 openenv harbor serve --dataset <hf-dataset> --port 8200 --capture-port 8300 --expose gradio
vLLMサーバーはツール呼び出しと実際のトークンIDを公開し、NCCLによる重みの同期を有効にする必要があります。これにより、エージェントは常に最新のポリシーにアクセスできます。ロールアウトと重みの更新には、同じvLLMサーバーを使用する必要があります。
vllm serve <model> \
    --enable-auto-tool-choice --tool-call-parser <parser> \
    --logprobs-mode processed_logprobs \
    --return-tokens-as-token-ids \
--weight-transfer-config '{"backend":"nccl"}'Update on GitHubLoop-owning training は
trl.experimental配下にあり、その API は変更される可能性があります。この例では、テストに使用した OpenEnv のリビジョンが固定されています。正確なセットアップについては、その README を参照してください。