
TRL documentation
Kernels Hubの統合と使用方法
Kernels Hubの統合と使用方法
kernels ライブラリを使用すると、最適化された計算カーネルを Hub から直接読み込むことができます。
kernels は、専用の組織 で、または Hub 内で kernel タグ を検索することで見つけることができます。
Kernelsは、モデルの開発、学習、推論を支援する最適化されたコードの断片です。ここでは、TRLとの統合に焦点を当てますが、それ以上の詳細については上記のリソースを参照してください。
インストール
TRLでカーネルを使用するには、Python環境にライブラリをインストールする必要があります:
pip install kernels
TRLでHubのKernelsを使用する
Kernelsはアテンションの実装を直接置き換えることができ、Flash Attentionのようなアテンションバックエンドを手動でコンパイルする必要がなくなります。Hubから対応するアテンションカーネルを取得するだけで、トレーニング速度を向上させることができます。
モデルの読み込み時にカーネルを指定できます:
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained(
    "your-model-name",
    attn_implementation="kernels-community/flash-attn2"  # other options: kernels-community/vllm-flash-attn3, kernels-community/paged-attention
)
または、TRLの学習スクリプトを実行する際:
python sft.py ... --attn_implementation kernels-community/flash-attn2
または、TRL CLI を使用します:
trl sft ... --attn_implementation kernels-community/flash-attn2
これにより、Hubからハードウェア構成に最適化された事前最適化カーネルを利用し、より高速なアテンションバックエンドを活用できるようになり、開発とトレーニングの両方が高速化されます。
カーネルバージョンの選択と固定
Hub 上のカーネルリポジトリはブランチとしてバージョン管理されています(v1、v2、v3、…)。Transformers は各リポジトリに対してデフォルトのバージョンを選択します。このデフォルトは Transformers のリリースごとに変わる可能性があるため、同じ attn_implementation の値が常に同じビルドに解決されるとは限りません。
読み込むビルドを制御するには、リポジトリIDにバージョンブランチまたはコミットSHAの形式でリビジョンを付加します:
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained(
    "your-model-name",
    attn_implementation="kernels-community/flash-attn2@v2",  # or a commit SHA to pin an exact build
)
Pinningは、トレーニングの実行を再現可能にするため、また、新しいビルドでリグレッションが発生した場合に既知の正常なビルドにとどまるために有用です。ただし、各バージョンはTorchとCUDAの特定のバージョン範囲に対してのみビルドを提供するため、ピン留めしたバージョンにあなたの環境に対応するバリアントが存在しない場合があります。
attn_implementation="flash_attention_2"は、flash-attnパッケージがインストールされていない場合、kernels-community/flash-attn2の Hub カーネルにフォールバックします。そのため、明示的に指定していないにもかかわらず、Hub カーネルを使用している可能性があります。
CUDA 12.8 向けの
v3ビルドは、グループクエリアテンションを使用するモデルにおいて、バックワードパスで現在失敗しています。お使いの環境がその CUDA バージョンを使用している場合は、huggingface/kernels-community#1085 がクローズされるまで@v2に固定してください。
Attention実装の比較
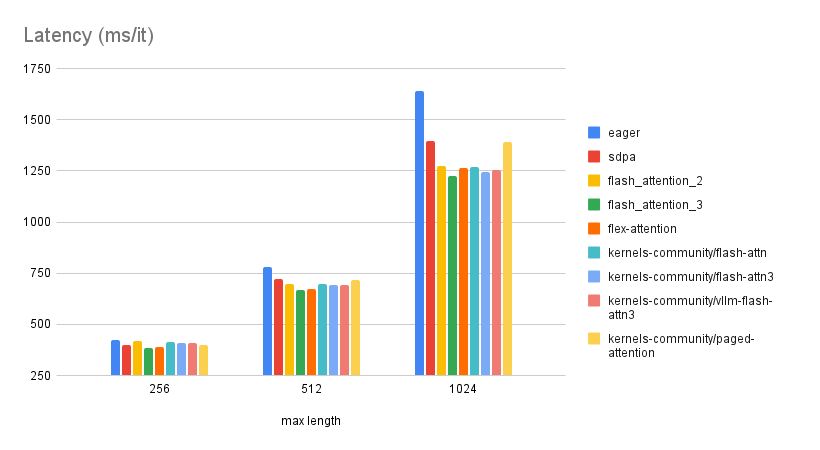
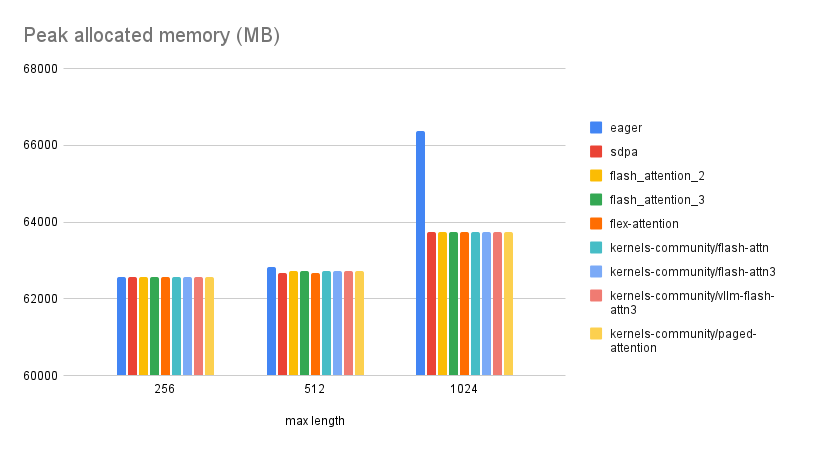
transformersで利用可能なさまざまなattention実装と、異なるカーネルバックエンドを、TRLとSFTを用いて評価しました。
実験は、CUDA 12.9を備えた単一のH100 GPU上で実行され、Qwen3-8Bを使用し、バッチサイズ8、勾配蓄積1、bfloat16精度を設定しました。
ここに示す結果はこの構成に固有のものであり、異なるトレーニング構成では結果が異なる可能性があります。
次の図は、異なるアテンション実装とカーネルバックエンドにおけるレイテンシ(1ステップあたりの学習時間)とピーク時の割り当てメモリを示しています。
カーネルベースの実装は、カスタムインストールされたアテンションと同等のパフォーマンスを発揮し、モデルのmax_lengthを大きくすることでパフォーマンスがさらに向上します。メモリ消費量はすべての実装で類似しており、有意な差は見られません。次のセクションで説明するように、より少ない手間ですべて同じパフォーマンスを得ることができます。
Flash Attention と Hub Kernels
Flash Attentionをソースからビルドするには時間がかかることが多く、ハードウェア、CUDA/PyTorchの構成、事前コンパイル済みホイールの有無によって、数分から数時間かかる場合があります。
一方、Hugging Face Kernels ははるかに高速かつ信頼性の高いワークフローを提供します。開発者は複雑なセットアップを心配する必要はなく、すべてが自動的に処理されます。当社のベンチマークでは、コンパイル不要で約2.5秒でカーネルが使用可能な状態になりました。これにより、ほぼ即座にトレーニングを開始でき、開発が大幅に加速します。望むバージョンを指定するだけで、kernels が残りの処理をすべて行います。