
TRL documentation
GRPO Trainer
GRPO Trainer

Tổng quan
TRL hỗ trợ GRPO Trainer để huấn luyện các mô hình ngôn ngữ, như được mô tả trong bài báo DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models của Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Mingchuan Zhang, Y. K. Li, Y. Wu, Daya Guo.
Tóm tắt từ bài báo như sau:
Suy luận toán học đặt ra thách thức đáng kể cho các mô hình ngôn ngữ do bản chất phức tạp và có cấu trúc của nó. Trong bài báo này, chúng tôi giới thiệu DeepSeekMath 7B, mô hình tiếp tục huấn luyện trước DeepSeek-Coder-Base-v1.5 7B với 120B token liên quan đến toán học được lấy từ Common Crawl, cùng với dữ liệu ngôn ngữ tự nhiên và mã. DeepSeekMath 7B đã đạt điểm ấn tượng 51,7% trên bộ đánh giá MATH ở cấp độ thi đấu mà không dựa vào các bộ công cụ bên ngoài và kỹ thuật bỏ phiếu, tiệm cận mức hiệu suất của Gemini-Ultra và GPT-4. Tính nhất quán tự thân trên 64 mẫu từ DeepSeekMath 7B đạt 60,9% trên MATH. Khả năng suy luận toán học của DeepSeekMath được quy cho hai yếu tố chính: Thứ nhất, chúng tôi khai thác tiềm năng đáng kể của dữ liệu web công khai thông qua một quy trình chọn lọc dữ liệu được thiết kế tỉ mỉ. Thứ hai, chúng tôi giới thiệu Group Relative Policy Optimization (GRPO), một biến thể của Proximal Policy Optimization (PPO), giúp tăng cường khả năng suy luận toán học đồng thời tối ưu hóa việc sử dụng bộ nhớ của PPO.
Phương pháp hậu huấn luyện này được đóng góp bởi Quentin Gallouédec.
Bắt đầu nhanh
Ví dụ này minh họa cách huấn luyện một mô hình bằng phương pháp GRPO. Chúng ta huấn luyện mô hình Qwen2.5 0.5B Instruct với các prompt từ dataset DeepMath-103K. Bạn có thể xem dữ liệu trong dataset tại đây:
Dưới đây là script để huấn luyện mô hình. accuracy_reward cần math-verify, bạn có thể cài đặt bằng pip install trl[math_verify].
# train_grpo.py
from datasets import load_dataset
from trl import GRPOTrainer
from trl.rewards import accuracy_reward

dataset = load_dataset("trl-lib/DeepMath-103K", split="train")

trainer = GRPOTrainer(
    model="Qwen/Qwen2.5-0.5B-Instruct",
    reward_funcs=accuracy_reward,
    train_dataset=dataset,
)
trainer.train()
Chạy script bằng lệnh sau:
torchrun --nproc_per_node 8 train_grpo.py
Phân phối trên 8 GPU, quá trình huấn luyện mất khoảng 1 ngày.

Lưu ý: Các đường cong phần thưởng ở trên được tạo bằng
Qwen/Qwen2-0.5B-Instruct. Kết quả vớiQwen/Qwen2.5-0.5B-Instructsẽ tương tự về mặt định tính.
Tìm hiểu sâu hơn về phương pháp GRPO
GRPO là một thuật toán học trực tuyến, nghĩa là nó cải thiện theo từng lần lặp bằng cách sử dụng dữ liệu do chính mô hình đã được huấn luyện tạo ra trong quá trình huấn luyện. Trực giác đằng sau mục tiêu của GRPO là tối đa hóa lợi thế của các phần hoàn thành được tạo ra, đồng thời đảm bảo rằng mô hình vẫn ở gần chính sách tham chiếu. Để hiểu cách GRPO hoạt động, nó có thể được chia thành bốn bước chính: tạo các phần hoàn thành, tính toán lợi thế, ước lượng phân kỳ KL và tính toán tổn thất.
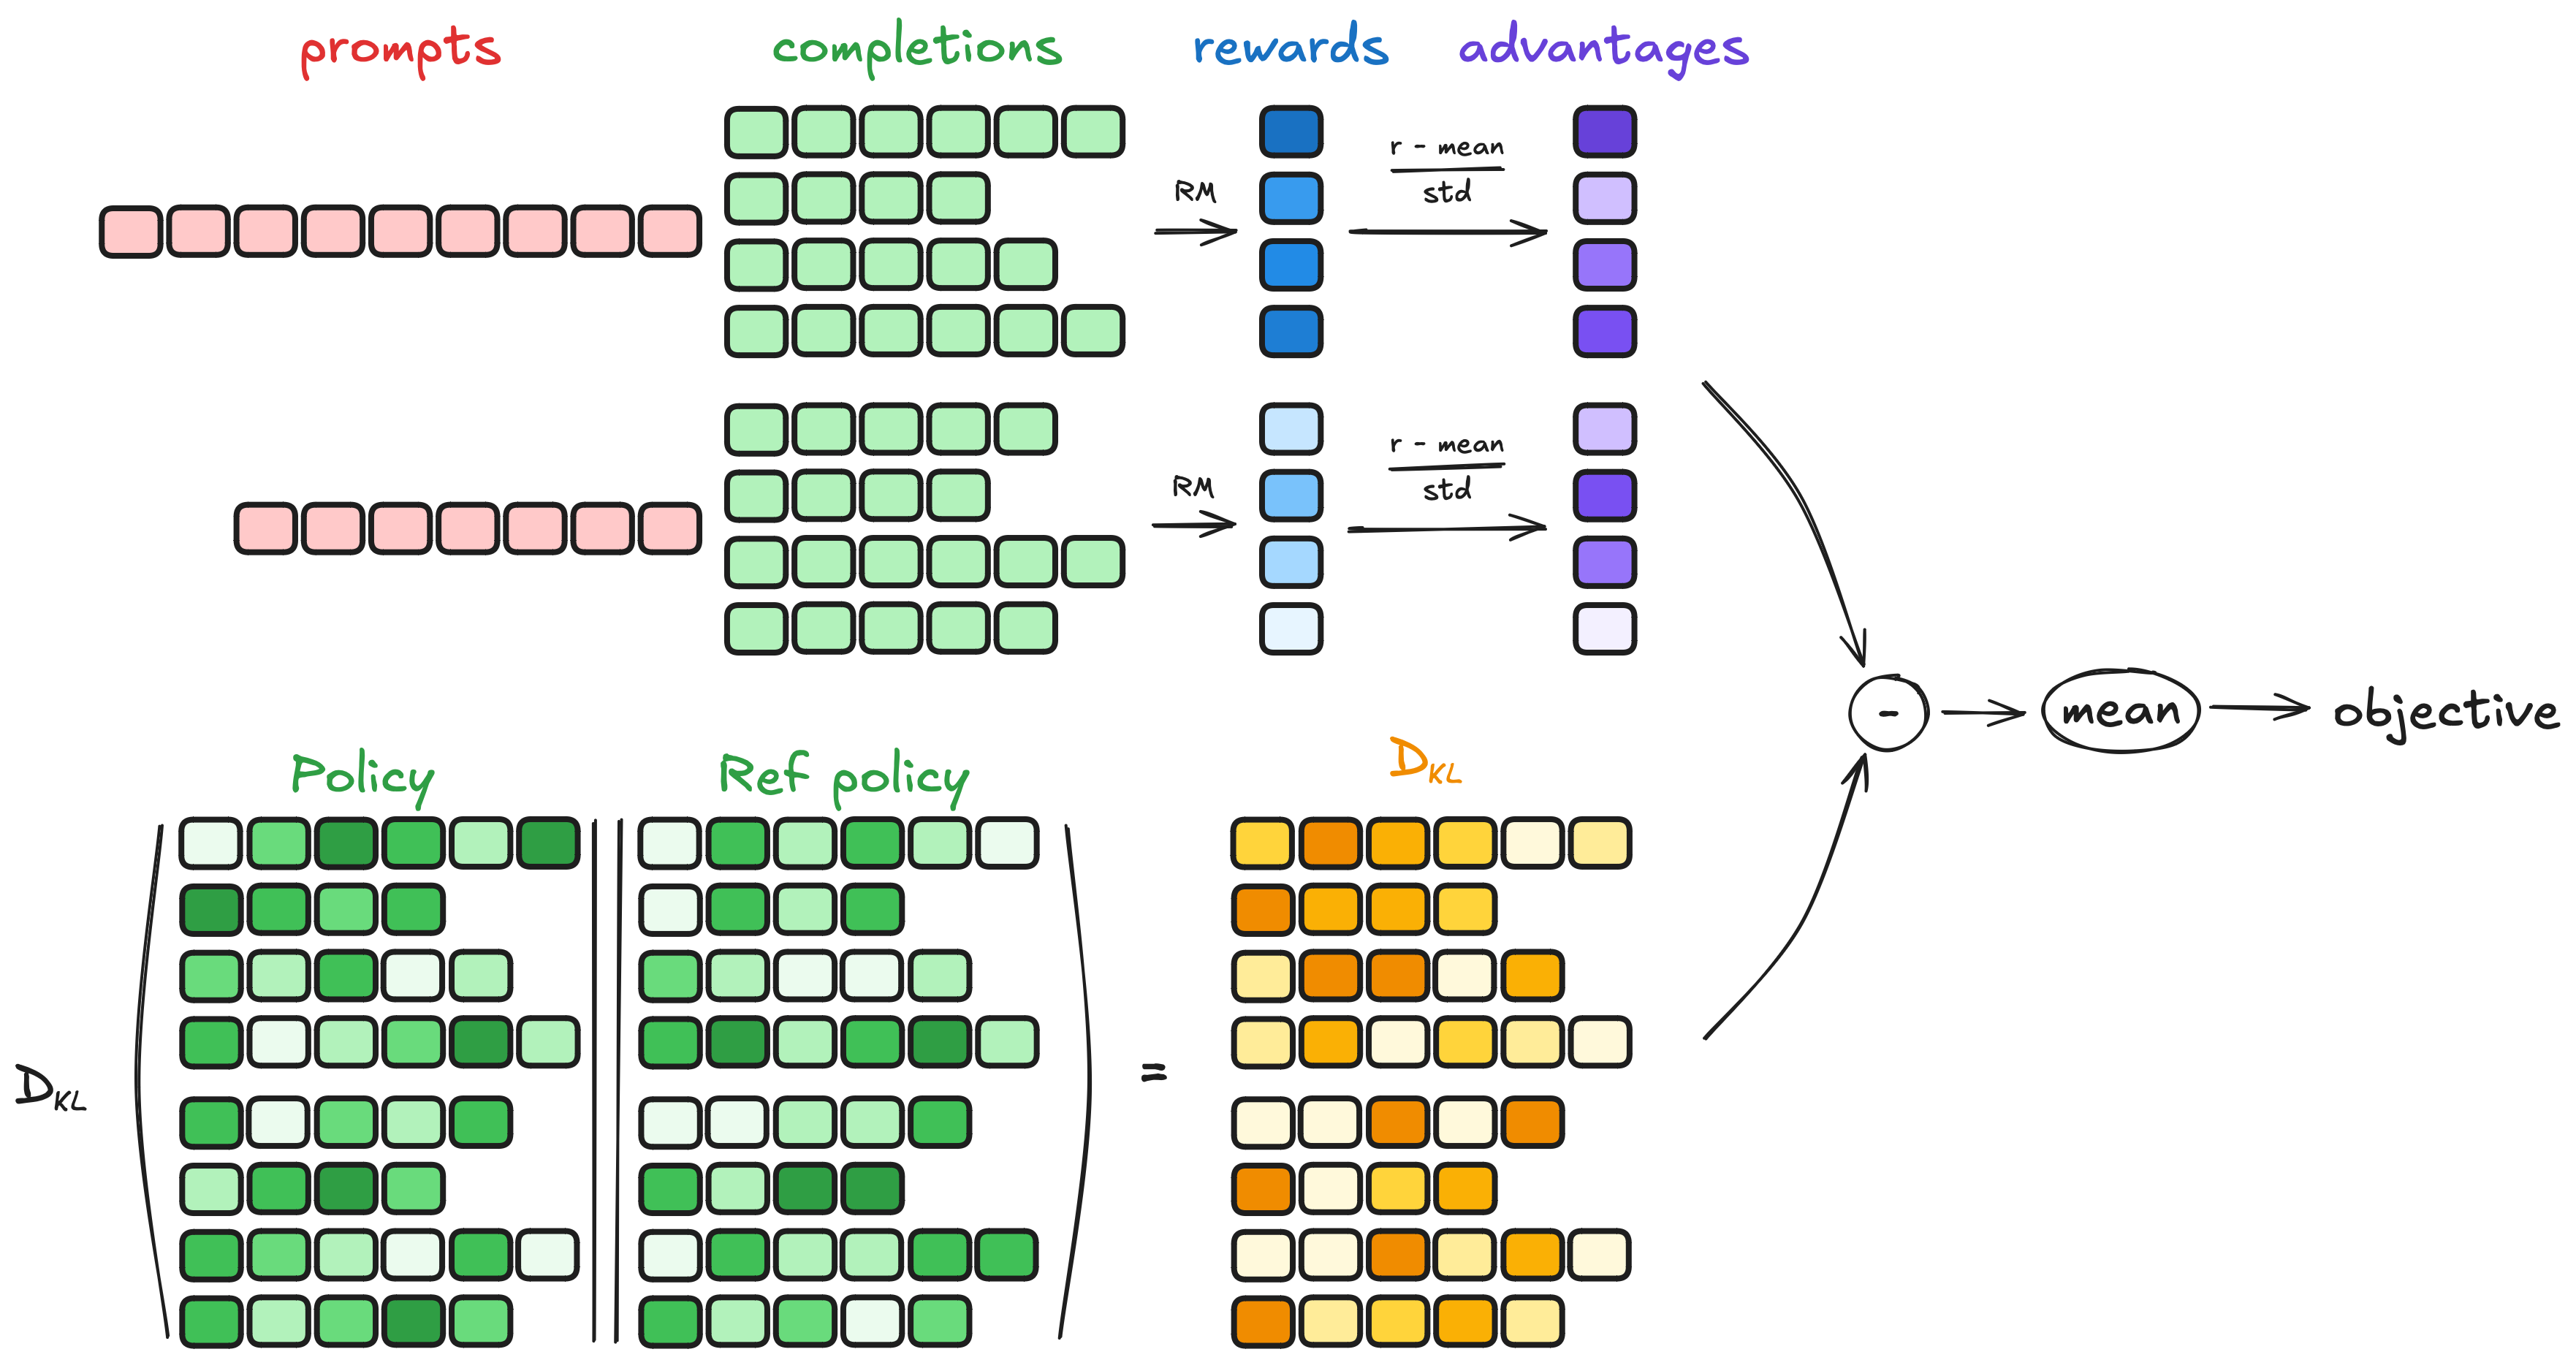
Tạo các câu trả lời hoàn chỉnh
Ở mỗi bước huấn luyện, chúng ta lấy mẫu một lô prompt và tạo ra một tập hợp các completion cho mỗi prompt (ký hiệu là ).
Tính toán lợi thế
Với mỗi trong số các chuỗi, chúng ta tính phần thưởng bằng mô hình phần thưởng hoặc hàm phần thưởng. Để phù hợp với bản chất so sánh của các mô hình phần thưởng—thường được huấn luyện trên các bộ dữ liệu so sánh giữa các đầu ra cho cùng một câu hỏi—lợi thế được tính toán để phản ánh những so sánh tương đối này. Nó được chuẩn hóa như sau:
Cách tiếp cận này đặt tên cho phương pháp: Group Relative Policy Optimization (GRPO).
Bài báo Understanding R1-Zero-Like Training: A Critical Perspective đã chỉ ra rằng việc chia cho có thể gây ra thiên kiến về độ khó ở cấp độ câu hỏi. Bạn có thể tắt việc chia này bằng cách đặt
scale_rewards=Falsetrong GRPOConfig. Lưu ý rằng việc tắt chia dựa trên std cũng loại bỏ việc chuẩn hóa phương sai, do đó độ lớn của các bước cập nhật sẽ phụ thuộc trực tiếp vào thang phần thưởng thô và thành phần của batch.
Như đã trình bày trong Phần I: Mẹo hay Bẫy? Phân tích sâu về RL cho suy luận LLM (Lite PPO), việc tính trung bình ở cấp độ cục bộ (nhóm) và độ lệch chuẩn ở cấp độ toàn cục (batch) cho phép định hình phần thưởng (reward shaping) vững chắc hơn. Bạn có thể sử dụng chiến lược chuẩn hóa này bằng cách đặt
scale_rewards="batch"trong GRPOConfig.
Ước lượng độ phân kỳ KL
Độ phân kỳ KL được ước lượng bằng bộ xấp xỉ do Schulman et al. (2020). Bộ xấp xỉ được định nghĩa như sau:
Tính toán tổn thất
Mục tiêu là tối đa hóa lợi thế trong khi đảm bảo mô hình vẫn gần với chính sách tham chiếu. Do đó, hàm mất mát được định nghĩa như sau:
trong đó số hạng đầu tiên đại diện cho lợi thế đã được chuẩn hóa và số hạng thứ hai phạt các sự sai lệch so với chính sách tham chiếu thông qua phân kỳ KL.
Lưu ý rằng so với công thức gốc trong DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models, chúng tôi không nhân với vì bài báo Understanding R1-Zero-Like Training: A Critical Perspective đã chỉ ra rằng điều này gây ra độ chệch độ dài ở cấp độ phản hồi. Chi tiết thêm trong các loại loss.
Lưu ý rằng so với công thức gốc trong DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models, chúng tôi sử dụng theo mặc định, có nghĩa là số hạng phân kỳ KL không được sử dụng. Lựa chọn này được thúc đẩy bởi một số nghiên cứu gần đây (ví dụ: Open-Reasoner-Zero: An Open Source Approach to Scaling Up Reinforcement Learning on the Base Model) ) đã chỉ ra rằng số hạng phân kỳ KL không phải là thiết yếu cho việc huấn luyện với GRPO. Do đó, việc loại bỏ số hạng này đã trở thành thông lệ phổ biến (ví dụ Understanding R1-Zero-Like Training: A Critical Perspective, DAPO: An Open-Source LLM Reinforcement Learning System at Scale). Nếu bạn muốn bao gồm số hạng phân kỳ KL, bạn có thể đặt
betatrong GRPOConfig thành một giá trị khác không.
Trong bài báo gốc, công thức này được tổng quát hóa để tính đến nhiều lần cập nhật sau mỗi lần sinh (ký hiệu là , có thể được đặt bằng num_iterations trong GRPOConfig) bằng cách tận dụng mục tiêu thay thế bị cắt (clipped surrogate objective):
trong đó đảm bảo rằng các cập nhật không lệch quá xa so với chính sách tham chiếu bằng cách giới hạn tỷ lệ chính sách giữa và . Khi (mặc định trong TRL), hàm mục tiêu thay thế có cắt giảm sẽ rút gọn về hàm mục tiêu ban đầu.
Các loại hàm mất mát
Nhiều công thức của hàm mục tiêu đã được đề xuất trong tài liệu. Ban đầu, hàm mục tiêu của GRPO được định nghĩa như sau:
trong đó
Bài báo DAPO nhấn mạnh những hạn chế của hàm mất mát ở cấp độ mẫu của thuật toán GRPO trong các kịch bản CoT dài, trong đó các phản hồi dài hơn bị phạt ít hơn, dẫn đến chất lượng đầu ra kém hơn. Giải pháp được đề xuất là chuẩn hóa ở cấp độ token, giúp xử lý tốt hơn các chuỗi dài bằng cách gán phần thưởng cân bằng hơn cho từng token, bất kể độ dài của phản hồi:
Để sử dụng công thức này, hãy đặt loss_type="dapo" trong GRPOConfig.
Hơn nữa, bài báo Understanding R1-Zero-Like Training: A Critical Perspective đã chỉ ra rằng công thức GRPO ban đầu gây ra thiên lệch về độ dài phản hồi. Các tác giả cho thấy mặc dù công thức DAPO làm giảm thiên lệch này, nhưng không loại bỏ hoàn toàn. Để loại bỏ hoàn toàn thiên lệch này, họ đề xuất chia cho một hằng số thay vì độ dài chuỗi, dẫn đến công thức sau:
Hằng số này được khuyến nghị là độ dài hoàn thành tối đa. Để sử dụng công thức này, hãy đặt loss_type="dr_grpo" trong GRPOConfig.
Ngoài ra, trong bài báo SAPO, nhóm Qwen đề xuất thay thế cơ chế cắt “cứng” của GRPO bằng một cơ chế cổng mềm (soft gating) mượt mà, được kiểm soát bằng nhiệt độ. Trong khi GRPO đặt gradient bằng không khi chính sách lệch quá xa so với tham chiếu, SAPO sử dụng vùng tin cậy mềm (soft trust region) để làm suy giảm trọng số gradient một cách mượt mà. Điều này cho phép mô hình giữ lại các tín hiệu học tập hữu ích từ các token “gần chính sách” (near-on-policy) trong khi triệt tiêu nhiễu từ các sai lệch cực đoan.
Hàm mất mát được định nghĩa như sau:
Hàm soft-gating được định nghĩa bằng hàm sigmoid như sau:
Nhiệt độ được chọn dựa trên dấu của lợi thế :
Họ khuyến nghị sử dụng nhiệt độ bất đối xứng, (giá trị mặc định là ). Điều này đảm bảo rằng mô hình bị phạt nghiêm ngặt hơn cho các hành động “xấu” để ngăn ngừa mất ổn định, trong khi cho phép linh hoạt hơn với các hành động “tốt”.
Để sử dụng công thức này, hãy đặt loss_type="sapo" trong GRPOConfig.
Các chỉ số được ghi log
Trong quá trình huấn luyện và đánh giá, chúng ta ghi lại các chỉ số sau:
num_tokens: Tổng số token đã được xử lý cho đến hiện tại, bao gồm cả prompt và completion. Khi sử dụng công cụ, chỉ các token không phải của công cụ mới được tính.step_time: Thời gian trung bình (tính bằng giây) cho mỗi bước huấn luyện (bao gồm cả quá trình sinh).completions/mean_length: Độ dài trung bình của các phần hoàn thành được tạo ra. Khi sử dụng công cụ, chỉ các token không phải của công cụ mới được tính.completions/min_length: Độ dài tối thiểu của các phần hoàn thành được tạo ra. Khi sử dụng công cụ, chỉ các token không phải của công cụ mới được tính.completions/max_length: Độ dài tối đa của các phần hoàn thành được tạo ra. Khi sử dụng công cụ, chỉ các token không phải của công cụ mới được tính.completions/mean_terminated_length: Độ dài trung bình của các chuỗi hoàn thành được tạo ra kết thúc bằng EOS. Khi sử dụng công cụ, chỉ các token không phải công cụ được tính.completions/min_terminated_length: Độ dài tối thiểu của các phần hoàn thành được tạo ra kết thúc bằng EOS. Khi sử dụng công cụ, chỉ các token không phải công cụ được tính.completions/max_terminated_length: Độ dài tối đa của các completion được tạo ra kết thúc bằng EOS. Khi sử dụng công cụ, chỉ các token không phải công cụ được tính.completions/clipped_ratio: Tỷ lệ các câu trả lời bị cắt (clipped).tools/call_frequency: Số lần gọi công cụ trung bình cho mỗi lần hoàn thành trong lô sinh. Chỉ được ghi lại khi cótoolsđược cung cấp.tools/failure_frequency: Tỷ lệ các lần gọi công cụ bị thất bại (công cụ không được tìm thấy, gây ra ngoại lệ, hoặc loại gọi không được hỗ trợ). Giá trị là0.0khi không có công cụ nào được gọi. Chỉ được ghi log khitoolsđược cung cấp.rewards/{reward_func_name}/mean: Phần thưởng trung bình từ một hàm phần thưởng cụ thể. Khi môi trường sở hữu phần thưởng thông quaget_reward,{reward_func_name}là tên lớp của môi trường đó.rewards/{reward_func_name}/std: Độ lệch chuẩn của phần thưởng từ một hàm phần thưởng cụ thể.reward: Phần thưởng trung bình tổng thể sau khi cộng phần thưởng giữa các hàm (được trọng số hóa bởireward_weights).reward_std: Độ lệch chuẩn của phần thưởng tổng hợp trên các hàm (được trọng số hóa bởireward_weights), được tính trên toàn bộ lô.frac_reward_zero_std: Tỷ lệ các mẫu trong lô sinh có độ lệch chuẩn phần thưởng bằng 0, cho thấy mức độ đa dạng thấp cho prompt đó (tất cả các câu trả lời đều đúng hoặc đều sai).sampling/sampling_logp_difference/mean: Chênh lệch tuyệt đối trung bình giữa các log xác suất do trình lấy mẫu (vLLM) trả về và các log xác suất được tính lại bởi mô hình huấn luyện, trên các token hoàn thành. Giá trị tăng dần cho thấy sự lệch giữa huấn luyện và suy luận đang mở rộng. Chỉ được ghi log khiuse_vllm=Truevàvllm_importance_sampling_correction=True.sampling/sampling_logp_difference/max: Chênh lệch tuyệt đối lớn nhất như vậy. Chỉ được ghi lại khiuse_vllm=Truevàvllm_importance_sampling_correction=True.sampling/importance_sampling_ratio/min: Tỷ lệ importance sampling nhỏ nhất được sử dụng để hiệu chỉnh sự lệch giữa huấn luyện và suy luận, sau khi ràng buộc được chọn bởivllm_importance_sampling_modeđược áp dụng (được cắt xuống[C_min, C_max]cho các chế độ*_truncate, được đặt bằng không cho các chế độ*_mask). Được tính trên các token completion, hoặc trên các chuỗi cho các chế độsequence_*. Chỉ được ghi log khiuse_vllm=Truevàvllm_importance_sampling_correction=True.sampling/importance_sampling_ratio/mean: Tỷ lệ importance sampling có ràng buộc trung bình. Chỉ được ghi log khiuse_vllm=Truevàvllm_importance_sampling_correction=True.sampling/importance_sampling_ratio/max: Tỷ lệ importance sampling bị ràng buộc lớn nhất. Chỉ được ghi log khiuse_vllm=Truevàvllm_importance_sampling_correction=True.policy_loss: Giá trị tổn thất gradient chính sách (trước khi áp dụng bất kỳ phần thưởng entropy nào). Được ghi lại khientropy_coefkhác không hoặcuse_adaptive_entropy=True.entropy: Entropy trung bình của các dự đoán token trên các chuỗi hoàn thành được tạo ra. (Nếumask_truncated_completions=True, các token của các chuỗi bị mask sẽ được loại trừ.)entropy_coef: Hệ số điều chỉnh entropy hiện tại. Được ghi log khientropy_coefkhác không hoặcuse_adaptive_entropy=True. Được cập nhật một lần mỗi bước tối ưu hóa khiuse_adaptive_entropy=True.aux_loss: Tổn phụ trợ cân bằng tải của mô hình Mixture-of-Experts, trước khi được nhân vớirouter_aux_loss_coefvà cộng vào tổn. Chỉ được ghi log khi mô hình là mô hình MoE vàrouter_aux_loss_coefkhác không.kl: Trung bình của độ phân kỳ KL giữa mô hình và mô hình tham chiếu, được tính trên các phần hoàn thành đã tạo. Chỉ được ghi log nếubetakhác không.clip_ratio/region_mean: Tỷ lệ token (hoặc chuỗi, nếuimportance_sampling_level="sequence") xác suất mà mục tiêu GRPO bị cắt để nằm trong vùng tin cậy: . Giá trị cao hơn có nghĩa là nhiều token bị cắt hơn, điều này hạn chế mức độ thay đổi của chính sách có thể thay đổi.clip_ratio/low_mean: Tỷ lệ trung bình của xác suất token (hoặc chuỗi, nếuimportance_sampling_level="sequence") bị cắt ở cận dưới của vùng tin cậy: .clip_ratio/low_min: Tỷ lệ phần trăm nhỏ nhất trên mỗi completion của các token (hoặc chính chuỗi, nếuimportance_sampling_level="sequence") bị cắt ở cận dưới của vùng tin cậy: .clip_ratio/high_mean: Tỷ lệ trung bình của xác suất token (hoặc chuỗi, nếuimportance_sampling_level="sequence") bị cắt ở cận trên của vùng tin cậy: .clip_ratio/high_max: Tỷ lệ phần token trên mỗi completion lớn nhất (hoặc chính chuỗi, nếuimportance_sampling_level="sequence") bị cắt ở cận trên của vùng tin cậy: .cispo_clip_ratio: Tỷ lệ token (hoặc sequence, nếuimportance_sampling_level="sequence") trọng số importance sampling bị cắt ởepsilon_hightrong khi có lợi thế dương: . Chỉ được ghi log khiloss_type="cispo".vespo/phi_seq_mean: Giá trị trung bình của trọng số Gamma VESPO được áp dụng cho trọng số quan trọng ở cấp độ chuỗi. Các giá trị nhỏ hơn1.0có nghĩa là các chuỗi đang bị giảm trọng số. Chỉ được ghi log khiloss_type="vespo".
Tùy chỉnh
Tăng tốc huấn luyện với sinh nội dung do vLLM hỗ trợ
Việc tạo sinh (generation) thường là nút thắt cổ chai chính khi huấn luyện bằng các phương pháp trực tuyến. Để tăng tốc quá trình tạo sinh, bạn có thể sử dụng vLLM, một bộ máy suy luận (inference engine) có thông lượng cao và độ trễ thấp dành cho LLM. Để bật tính năng này, trước tiên hãy cài đặt gói bằng
pip install trl[vllm]
Chúng tôi hỗ trợ hai cách sử dụng vLLM trong quá trình huấn luyện: chế độ máy chủ và chế độ colocate.
Mặc định, Masked Importance Sampling ở cấp độ chuỗi (
vllm_importance_sampling_mode="sequence_mask") được kích hoạt cho quá trình tạo của vLLM để giải quyết sự không khớp giữa tạo và huấn luyện xảy ra khi sử dụng các framework khác nhau. Tính năng này có thể được tắt bằng cách đặtvllm_importance_sampling_correction=False. Để biết thêm thông tin, xem Masked Importance Sampling và Sequence-level Importance Sampling
Tùy chọn 1: Chế độ Colocate
Trong chế độ này, vLLM chạy bên trong tiến trình trainer và chia sẻ bộ nhớ GPU với mô hình huấn luyện. Điều này giúp tránh việc khởi động một server riêng và có thể cải thiện mức sử dụng GPU, nhưng có thể dẫn đến tranh chấp bộ nhớ trên các GPU huấn luyện. Đây là chế độ mặc định.
from trl import GRPOConfig

training_args = GRPOConfig(
    ...,
    use_vllm=True,  # vllm_mode="colocate" by default
)
Tùy chọn 2: Chế độ máy chủ
Trong chế độ này, vLLM chạy trong một tiến trình riêng (và sử dụng các GPU riêng) và giao tiếp với trainer qua HTTP. Đây là lựa chọn lý tưởng nếu bạn có các GPU dành riêng cho suy luận.
Khởi động máy chủ vLLM:
VLLM_SERVER_DEV_MODE=1 vllm serve <model_name> \
    --weight-transfer-config '{"backend": "nccl"}' \
    --logprobs-mode processed_logprobs \
    --max-logprobs -1
Bật chế độ máy chủ trong script huấn luyện của bạn:
from trl import GRPOConfig

training_args = GRPOConfig(
    ...,
    use_vllm=True,
    vllm_mode="server",
)
Hãy đảm bảo rằng server đang sử dụng các GPU khác với trainer, nếu không bạn có thể gặp lỗi NCCL. Bạn có thể chỉ định các GPU cần sử dụng bằng biến môi trường
CUDA_VISIBLE_DEVICES.
Tùy thuộc vào kích thước mô hình và yêu cầu bộ nhớ GPU tổng thể cho việc huấn luyện, bạn có thể cần điều chỉnh tham số
vllm_gpu_memory_utilizationtrong GRPOConfig để tránh tình trạng khai thác không đủ hoặc lỗi hết bộ nhớ.Chúng tôi cung cấp một HF Space để giúp ước lượng mức sử dụng bộ nhớ GPU được khuyến nghị dựa trên cấu hình mô hình và cài đặt thí nghiệm của bạn. Chỉ cần sử dụng nó như sau để nhận khuyến nghị
vllm_gpu_memory_utilization:Nếu giá trị khuyến nghị không hoạt động trong môi trường của bạn, chúng tôi đề xuất thêm một bộ đệm nhỏ (ví dụ: +0.05 hoặc +0.1) vào giá trị khuyến nghị để đảm bảo tính ổn định.
Nếu bạn vẫn gặp lỗi hết bộ nhớ, hãy đặt
vllm_enable_sleep_modethành True và các tham số cũng như bộ nhớ đệm của vllm sẽ được chuyển ra ngoài trong bước tối ưu hóa. Để biết thêm thông tin, xem Giảm mức sử dụng bộ nhớ với vLLM Sleep Mode.
Mặc định, GRPO sử dụng
MASTER_ADDR=localhostvàMASTER_PORT=12345cho vLLM, nhưng bạn có thể ghi đè các giá trị này bằng cách đặt các biến môi trường tương ứng.
Để biết thêm thông tin, hãy xem Tăng tốc huấn luyện với vLLM.
Xử lý sự không khớp giữa huấn luyện và suy luận
Mặc dù vLLM tăng tốc đáng kể quá trình suy luận, nó cũng tách rời động cơ suy luận khỏi động cơ huấn luyện. Về mặt lý thuyết, hai động cơ này giống hệt nhau về mặt toán học, nhưng trên thực tế, chúng có thể tạo ra các kết quả khác nhau do các hiệu ứng độ chính xác và các tối ưu hóa cụ thể cho phần cứng. Sự khác biệt này phản ánh các mục tiêu tối ưu hóa khác nhau của hai hệ thống. Các động cơ suy luận nhằm mục đích tối đa hóa thông lượng lấy mẫu, thường được đo bằng số token mỗi giây, trong khi vẫn duy trì độ trung thực của việc lấy mẫu ở mức chấp nhận được. Ngược lại, các khung huấn luyện tập trung vào sự ổn định và độ chính xác số cho việc tính toán gradient, thường sử dụng các định dạng độ chính xác cao hơn như FP32 cho trọng số chính và trạng thái của bộ tối ưu hóa. Những ưu tiên và ràng buộc khác nhau này tạo ra một sự không khớp không thể tránh khỏi, dù là tinh tế, giữa huấn luyện và suy luận.
Sự không khớp này dẫn đến việc cập nhật gradient có thiên lệch, vốn đã được quan sát thấy là gây mất ổn định cho quá trình huấn luyện ([1][2][3][4][5]). Để đơn giản hóa, hãy xem xét gradient chính sách REINFORCE:
Ở đây chỉ các prompt được lấy mẫu từ một phân phối dữ liệu nào đó, và là chính sách được triển khai bởi bộ động cơ huấn luyện. Khi có vLLM trong vòng lặp, chúng ta thu được một chính sách suy luận riêng biệt , nên gradient chính sách hiệu dụng trở thành
Điều này biến một bài toán RL on-policy thông thường thành một bài toán off-policy.
Cách chuẩn chỉnh phổ biến cho sự dịch chuyển phân phối này là importance sampling (IS). Chúng tôi cung cấp hai biến thể IS: Truncated Importance Sampling (TIS) và Masked Importance Sampling (MIS). Cả hai biến thể đều có thể được áp dụng ở cấp độ token hoặc cấp độ sequence. Hãy gọi là trọng số importance, ví dụ cho mỗi token hoặc cho mỗi sequence. Trong TIS, các tỷ số nằm ngoài khoảng [vllm_importance_sampling_clip_min, vllm_importance_sampling_clip_max] sẽ bị cắt (clip),
Bài báo gốc TIS đề xuất một cơ chế cắt giới hạn trên đơn lẻ, tức là . Cài đặt trong TRL đã tổng quát hóa điều này bằng cách giới thiệu thêm một giới hạn dưới, tạo ra công thức hai phía như trên, lấy cảm hứng từ phương pháp IcePop .
Lưu ý rằng trong IcePop, các giới hạn được ký hiệu là và còn trong TRL chúng tôi sử dụng và .
Dưới MIS, các tỷ lệ nằm ngoài khoảng này được đặt bằng không, do đó các mẫu đó không đóng góp vào gradient. Nói cách khác, các mẫu ngoại lai bị giảm trọng số dưới TIS và bị loại bỏ dưới MIS. Cờ cấu hình vllm_importance_sampling_mode chọn cả biến thể IS (che hoặc cắt) và độ hạt (cấp độ token hay cấp độ chuỗi).
Importance sampling là phản ứng thuật toán có nguyên tắc đối với sự không khớp giữa huấn luyện và suy luận. Tuy nhiên, cũng có những cách tiếp cận trực tiếp hơn nhằm giảm sự không khớp giữa chính hai engine này. Phần lớn trong số đó là các giải pháp kỹ thuật. Ví dụ, MiniMax M1 sử dụng đầu mô hình ngôn ngữ FP32 trong engine suy luận. Thinking Machines đã khám phá các kernel suy luận tất định, mặc dù điều này đi kèm với chi phí hiệu suất đáng kể. vLLM đã chứng minh các chính sách nhất quán theo từng bit bằng cách xây dựng dựa trên các kernel tất định bất biến theo lô từ Thinking Machines, nhưng tính đến tháng 11 năm 2025 vẫn còn tồn tại mức phạt thông lượng đáng kể so với suy luận vLLM tiêu chuẩn.
Tăng tốc huấn luyện với continuous batching của transformers
Ngoài vLLM, bạn có thể sử dụng động cơ continuous batching tích hợp sẵn của transformers để tạo nội dung nhanh hơn. Continuous batching loại bỏ ngay các chuỗi đã hoàn thành khỏi batch thay vì chờ chuỗi chậm nhất kết thúc. Đối với các tác vụ có độ dài hoàn thành thay đổi (ví dụ: suy luận toán học), phương pháp này cho phép tạo nội dung nhanh hơn và sử dụng ít VRAM hơn so với generate() mặc định ở kích thước batch lớn (N≥32).
Continuous batching là một nâng cấp thay thế trực tiếp, không yêu cầu thiết lập máy chủ hay đồng bộ trọng số. Nó chạy trong tiến trình và phù hợp cho huấn luyện trên một GPU hoặc các môi trường bị giới hạn bộ nhớ. Để đạt thông lượng sinh tối đa ở quy mô lớn, hãy sử dụng vLLM thay thế.
from trl import GRPOConfig

training_args = GRPOConfig(
    ...,
    use_transformers_continuous_batching=True,
    transformers_continuous_batching_config={
        "use_cuda_graph": False,
        "max_memory_percent": 0.4,  # lower values leave more VRAM for the training backward pass
    },
)
TRL đặt mặc định
max_memory_percentlà0.5(thay vì0.9của transformers) để dành đủ VRAM cho bước truyền ngược (backward pass) của quá trình huấn luyện. Hãy giảm giá trị này xuống0.3–0.4cho các lô sinh (generation batches) lớn (N≥32) hoặc nếu bạn gặp lỗi hết bộ nhớ (out-of-memory).
Để xem một ví dụ huấn luyện đầy đủ, hãy xem examples/grpo_continuous_batching/grpo_continuous_batching.py.
GRPO ở quy mô lớn: huấn luyện Mô hình 70B+ trên nhiều nút
Khi huấn luyện các mô hình lớn như Qwen2.5-72B, bạn cần một số tối ưu hóa chính để đảm bảo quá trình huấn luyện hiệu quả và có khả năng mở rộng trên nhiều GPU và node. Những tối ưu hóa này bao gồm:
- DeepSpeed ZeRO Stage 3: ZeRO tận dụng song song hóa dữ liệu để phân phối trạng thái mô hình (trọng số, gradient, trạng thái optimizer) trên nhiều GPU và CPU, giảm thiểu yêu cầu về bộ nhớ và tính toán trên mỗi thiết bị. Vì các mô hình lớn không thể chứa vừa trên một GPU duy nhất, việc sử dụng ZeRO Stage 3 là bắt buộc để huấn luyện các mô hình như vậy. Để biết thêm chi tiết, xem DeepSpeed Integration.
- torchrun: trình khởi chạy của PyTorch sẽ khởi tạo một tiến trình cho mỗi GPU trên mọi nút và kết nối chúng thông qua một điểm hội tụ chung. Để biết thêm chi tiết, hãy xem Phân phối huấn luyện.
- vLLM: Xem phần trước để biết cách sử dụng vLLM để tăng tốc độ sinh.
Dưới đây là một ví dụ về script SLURM để huấn luyện một mô hình 70B với GRPO trên nhiều nút. Script này huấn luyện mô hình trên 4 nút và sử dụng nút thứ 5 cho việc tạo sinh được hỗ trợ bởi vLLM.
#!/bin/bash
#SBATCH --nodes=5
#SBATCH --gres=gpu:8

# Get the list of allocated nodes
NODELIST=($(scontrol show hostnames $SLURM_JOB_NODELIST))

# Assign the first 4 nodes for training and the 5th node for vLLM
TRAIN_NODES="${NODELIST[@]:0:4}"  # Nodes 0, 1, 2, 3 for training
VLLM_NODE="${NODELIST[4]}"  # Node 4 for vLLM

# Run training on the first 4 nodes (Group 1)
srun --nodes=4 --ntasks=4 --nodelist="${NODELIST[@]:0:4}" torchrun \
     --nnodes 4 \
     --nproc_per_node 8 \
     --node_rank $SLURM_PROCID \
     --rdzv_backend c10d \
     --rdzv_endpoint ${NODELIST[0]}:29500 \
     train_grpo.py \
     --server_ip $VLLM_NODE &

# Run vLLM server on the 5th node (Group 2)
srun --nodes=1 --ntasks=1 --nodelist="${NODELIST[4]}" env VLLM_SERVER_DEV_MODE=1 vllm serve Qwen/Qwen2.5-72B --tensor-parallel-size 8 \
    --weight-transfer-config '{"backend": "nccl"}' \
    --logprobs-mode processed_logprobs \
    --max-logprobs -1 &

waitimport argparse
from datasets import load_dataset
from trl import GRPOTrainer, GRPOConfig
from trl.rewards import accuracy_reward
def main():
parser = argparse.ArgumentParser()
parser.add_argument("--vllm_server_host", type=str, default="", help="The server IP")
args = parser.parse_args()
dataset = load_dataset("trl-lib/DeepMath-103K", split="train")
training_args = GRPOConfig(
per_device_train_batch_size=4,
deepspeed="examples/deepspeed_configs/zero3.json",
use_vllm=True,
vllm_mode="server",
vllm_server_host=args.vllm_server_host.replace("ip-", "").replace("-", "."), # from ip-X-X-X-X to X.X.X.X
)
trainer = GRPOTrainer(
model="Qwen/Qwen2.5-72B",
args=training_args,
reward_funcs=accuracy_reward,
train_dataset=dataset
)
trainer.train()
if __name__=="__main__":
main()Sử dụng hàm phần thưởng tùy chỉnh
GRPOTrainer hỗ trợ việc sử dụng các hàm thưởng tùy chỉnh thay vì các mô hình thưởng dày đặc. Để đảm bảo tính tương thích, hàm thưởng của bạn phải đáp ứng các yêu cầu sau:
Các hàm reward có thể là các callable Python đồng bộ hoặc các coroutine async def bất đồng bộ. Khi bạn cung cấp nhiều hàm reward bất đồng bộ, chúng sẽ được chờ đồng thời (chạy song song thông qua asyncio.gather) để độ trễ của chúng chồng lên nhau.
Các đối số đầu vào:
Hàm phải nhận các đối số sau dưới dạng đối số từ khóa:
prompts(chứa các prompts),completions(chứa các phần hoàn thành đã tạo),completion_ids(chứa các completion đã được token hóa),trainer_state(TrainerState): Trạng thái hiện tại của trainer. Có thể sử dụng để triển khai các hàm phần thưởng động, chẳng hạn như curriculum learning, trong đó phần thưởng được điều chỉnh dựa trên tiến độ huấn luyện.log_extra: một callablelog_extra(column: str, values: list)để thêm các cột bổ sung vào bảng completions. Xem Ví dụ 6.log_metric: một hàm có thể gọilog_metric(name: str, value: float)để ghi log các chỉ số vô hướng dưới dạng biểu đồ bên cạnhkl,entropy, v.v. Xem Ví dụ 6.environments: một danh sách các instance môi trường, mỗi completion một instance. Chỉ có mặt khienvironment_factoryđược cung cấp. Dùng để đọc trạng thái tích lũy trong suốt episode (ví dụ:env.counter). Đối với môi trường có trạng thái, hãy ưu tiên để môi trường tự quản lý phần thưởng thông qua phương thứcget_reward— xem Rewards.- Tất cả tên cột (ngoại trừ
prompt) mà bộ dữ liệu có thể có. Ví dụ, nếu bộ dữ liệu chứa một cột có tênground_truth, hàm sẽ được gọi vớiground_truthnhư một đối số từ khóa.
Cách dễ nhất để đáp ứng yêu cầu này là sử dụng
**kwargstrong chữ ký hàm.Tùy thuộc vào định dạng bộ dữ liệu, đầu vào sẽ khác nhau:
- Đối với định dạng chuẩn,
promptsvàcompletionssẽ là các danh sách chuỗi. - Đối với định dạng hội thoại,
promptsvàcompletionssẽ là các danh sách từ điển tin nhắn.
- Đối với định dạng chuẩn,
Giá trị trả về: Hàm phải trả về một danh sách các số float. Mỗi số float đại diện cho phần thưởng tương ứng với một kết quả hoàn thành duy nhất.
Ví dụ 1: Phần thưởng cho các câu trả lời dài hơn
Dưới đây là một ví dụ về hàm phần thưởng cho định dạng chuẩn, phần thưởng cho các câu trả lời dài hơn:
def reward_func(completion_ids, **kwargs):
    """Reward function that assigns higher scores to longer completions (in terms of token count)."""
    return [float(len(ids)) for ids in completion_ids]
Bạn có thể kiểm tra nó như sau:
>>> prompts = ["The sky is", "The sun is"]  # not used in the reward function, but the trainer will pass it
>>> completions = [" blue.", " in the sky."]  # not used in the reward function, but the trainer will pass it
>>> completion_ids = [[6303, 13], [304, 279, 12884, 13]]
>>> reward_func(prompts=prompts, completions=completions, completion_ids=completion_ids)
[2.0, 4.0]
Ví dụ 1.1: Thưởng cho các phần hoàn thành dài hơn (dựa trên số ký tự)
Tương tự như ví dụ trước, nhưng lần này hàm phần thưởng được dựa trên số lượng ký tự thay vì token.
def reward_func(completions, **kwargs):
    """Reward function that assigns higher scores to longer completions (in terms of character count)."""
    return [float(len(completion)) for completion in completions]
Bạn có thể kiểm tra nó như sau:
>>> prompts = ["The sky is", "The sun is"]
>>> completions = [" blue.", " in the sky."]
>>> completion_ids = [[6303, 13], [304, 279, 12884, 13]]  # not used in the reward function, but the trainer will pass it
>>> reward_func(prompts=prompts, completions=completions, completion_ids=completion_ids)
[6.0, 12.0]
Ví dụ 2: Thưởng cho các phần hoàn thành có định dạng cụ thể
Dưới đây là một ví dụ về hàm phần thưởng kiểm tra xem phần hoàn thành có đúng định dạng cụ thể hay không. Ví dụ này được lấy cảm hứng từ hàm phần thưởng định dạng được sử dụng trong bài báo DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. Nó được thiết kế cho định dạng hội thoại, trong đó các prompt và phần hoàn thành bao gồm các tin nhắn có cấu trúc.
import re

def format_reward_func(completions, **kwargs):
    """Reward function that checks if the completion has a specific format."""
    pattern = r"^<think>.*?</think><answer>.*?</answer>$"
    completion_contents = [completion[0]["content"] for completion in completions]
    matches = [re.match(pattern, content) for content in completion_contents]
    return [1.0 if match else 0.0 for match in matches]
Bạn có thể kiểm tra hàm này như sau:
>>> prompts = [
...     [{"role": "user", "content": "What is the result of (1 + 2) * 4?"}],
...     [{"role": "user", "content": "What is the result of (3 + 1) * 2?"}],
... ]
>>> completions = [
...     [{"role": "assistant", "content": "<think>The sum of 1 and 2 is 3, which we multiply by 4 to get 12.</think><answer>(1 + 2) * 4 = 12</answer>"}],
...     [{"role": "assistant", "content": "The sum of 3 and 1 is 4, which we multiply by 2 to get 8. So (3 + 1) * 2 = 8."}],
... ]
>>> format_reward_func(prompts=prompts, completions=completions)
[1.0, 0.0]
Ví dụ 3: Hoàn thành phần thưởng dựa trên một tham chiếu
Dưới đây là một ví dụ về hàm phần thưởng kiểm tra xem câu trả liệu có chính xác hay không. Ví dụ này được lấy cảm hứng từ hàm phần thưởng độ chính xác được sử dụng trong bài báo DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning.
Ví dụ này được thiết kế cho định dạng chuẩn, trong đó tập dữ liệu chứa một cột có tên là ground_truth.
import re

def reward_func(completions, ground_truth, **kwargs):
    # Regular expression to capture content inside \boxed{}
    matches = [re.search(r"\\boxed\{(.*?)\}", completion) for completion in completions]
    contents = [match.group(1) if match else "" for match in matches]
    # Reward 1 if the content is the same as the ground truth, 0 otherwise
    return [1.0 if c == gt else 0.0 for c, gt in zip(contents, ground_truth)]
Bạn có thể kiểm tra hàm này như sau:
>>> prompts = ["Problem: Solve the equation $2x + 3 = 7$. Solution:", "Problem: Solve the equation $3x - 5 = 10$."]
>>> completions = [r" The solution is \boxed{2}.", r" The solution is \boxed{6}."]
>>> ground_truth = ["2", "5"]
>>> reward_func(prompts=prompts, completions=completions, ground_truth=ground_truth)
[1.0, 0.0]
Ví dụ 4: Các hàm phần thưởng đa nhiệm
Dưới đây là một ví dụ về việc sử dụng nhiều hàm phần thưởng trong GRPOTrainer. Trong ví dụ này, chúng ta định nghĩa hai hàm phần thưởng dành riêng cho từng tác vụ: math_reward_func và coding_reward_func. Hàm math_reward_func cấp phần thưởng cho các bài toán dựa trên tính chính xác của chúng, trong khi hàm coding_reward_func cấp phần thưởng cho các bài toán lập trình dựa trên việc giải pháp có chạy được hay không.
from datasets import Dataset
from trl import GRPOTrainer

# Define a dataset that contains both math and coding problems
dataset = Dataset.from_list(
    [
        {"prompt": "What is 2+2?", "task": "math"},
        {"prompt": "Write a function that returns the sum of two numbers.", "task": "code"},
        {"prompt": "What is 3*4?", "task": "math"},
        {"prompt": "Write a function that returns the product of two numbers.", "task": "code"},
    ]
)

# Math-specific reward function
def math_reward_func(prompts, completions, task, **kwargs):
    rewards = []
    for prompt, completion, t in zip(prompts, completions, task):
        if t == "math":
            # Calculate math-specific reward
            correct = check_math_solution(prompt, completion)
            reward = 1.0 if correct else -1.0
            rewards.append(reward)
        else:
            # Return None for non-math tasks
            rewards.append(None)
    return rewards

# Coding-specific reward function
def coding_reward_func(prompts, completions, task, **kwargs):
    rewards = []
    for prompt, completion, t in zip(prompts, completions, task):
        if t == "code":
            # Calculate coding-specific reward
            works = test_code_solution(prompt, completion)
            reward = 1.0 if works else -1.0
            rewards.append(reward)
        else:
            # Return None for non-coding tasks
            rewards.append(None)
    return rewards

# Use both task-specific reward functions
trainer = GRPOTrainer(
    model="Qwen/Qwen2.5-0.5B-Instruct",
    reward_funcs=[math_reward_func, coding_reward_func],
    train_dataset=dataset,
)

trainer.train()
Trong ví dụ này, math_reward_func và coding_reward_func được thiết kế để hoạt động với một tập dữ liệu hỗn hợp chứa cả các bài toán toán học và lập trình. Cột task trong tập dữ liệu được dùng để xác định hàm thưởng nào sẽ được áp dụng cho từng bài toán. Nếu không có hàm thưởng phù hợp cho một mẫu trong tập dữ liệu, hàm thưởng sẽ trả về None, và GRPOTrainer sẽ tiếp tục với các hàm và tác vụ hợp lệ. Điều này cho phép GRPOTrainer xử lý nhiều hàm thưởng với phạm vi áp dụng khác nhau.
Lưu ý rằng GRPOTrainer sẽ bỏ qua các phần thưởng None được trả về bởi các hàm phần thưởng và chỉ xem xét các phần thưởng được trả về bởi các hàm liên quan. Điều này đảm bảo rằng mô hình được huấn luyện trên các tác vụ liên quan và bỏ qua các tác vụ không có hàm phần thưởng liên quan.
Ví dụ 5: Các hàm phần thưởng bất đồng bộ
Các hàm phần thưởng tùy chỉnh cũng có thể được định nghĩa dưới dạng coroutine async def. Điều này hữu ích nếu phần thưởng của bạn phụ thuộc vào I/O chậm (ví dụ: gọi một dịch vụ từ xa). Khi bạn truyền nhiều hàm phần thưởng async, GRPOTrainer sẽ thực thi chúng đồng thời để độ trễ của chúng chồng lên nhau.
Dưới đây là một ví dụ tối giản về một hàm thưởng bất đồng bộ mô phỏng một thao tác bị giới hạn bởi I/O:
import asyncio

async def async_reward_func(prompts, completions, **kwargs):
    # Simulate an I/O-bound call (e.g., HTTP request, database lookup)
    await asyncio.sleep(0.01)
    # Simple toy reward: 1.0 if the completion is non-empty, else 0.0
    return [1.0 if completion else 0.0 for completion in completions]
Ví dụ 6: Ghi log các cột và chỉ số bổ sung
Dưới đây là một ví dụ về hàm phần thưởng ghi log các cột bổ sung vào bảng completions và các chỉ số vô hướng dưới dạng biểu đồ.
import re

def reward_func(completions, ground_truth, log_extra=None, log_metric=None, **kwargs):
    extracted = [re.search(r"\\boxed\{(.*?)\}", c) for c in completions]
    extracted = [m.group(1) if m else None for m in extracted]
    rewards = [1.0 if e == gt else 0.0 for e, gt in zip(extracted, ground_truth)]

    if log_extra:
        log_extra("golden_answer", list(ground_truth))
        log_extra("extracted_answer", [e or "[none]" for e in extracted])

    if log_metric:
        log_metric("accuracy", sum(rewards) / len(rewards))

    return rewards
Truyền hàm phần thưởng cho trình huấn luyện
Để sử dụng hàm phần thưởng tùy chỉnh của bạn, hãy truyền nó vào GRPOTrainer như sau:
from trl import GRPOTrainer

trainer = GRPOTrainer(
    reward_funcs=reward_func,
    ...,
)
Bạn có thể truyền nhiều hàm phần thưởng dưới dạng một danh sách; danh sách này có thể bao gồm cả các hàm đồng bộ và bất đồng bộ:
from trl import GRPOTrainer

trainer = GRPOTrainer(
    reward_funcs=[reward_func, async_reward_func1, async_reward_func2],
    ...,
)
và phần thưởng sẽ được tính là tổng các phần thưởng từ mỗi hàm, hoặc tổng có trọng số nếu reward_weights được cung cấp trong cấu hình.
Lưu ý rằng GRPOTrainer hỗ trợ nhiều hàm phần thưởng có các kiểu khác nhau. Xem tài liệu tham số để biết thêm chi tiết.
Điều chỉnh entropy
Để khuyến khích khám phá và ngăn chặn chính sách sụp đổ thành các đầu ra gần như tất định, bạn có thể thêm một phần thưởng entropy vào mục tiêu huấn luyện. Sự điều chỉnh entropy bổ sung cho tổn thất GRPO như sau:
trong đó là entropy trung bình trên mỗi token của chính sách và là hệ số entropy. Phần thưởng luôn là entropy trung bình trên mỗi token bất kể loss_type; nó không được điều chỉnh lại để khớp với quy chuẩn hóa chính sách của một loại loss (ví dụ: mẫu số batch_size * max_completion_length của Dr. GRPO), do đó entropy_coef có cùng ý nghĩa cho mọi loại loss.
Entropy tĩnh — một hệ số cố định trong suốt quá trình huấn luyện:
from trl import GRPOConfig, GRPOTrainer

training_args = GRPOConfig(entropy_coef=0.05, ...)
Entropy thích ứng — hệ số được cập nhật ở mỗi bước tối ưu hóa dựa trên entropy mục tiêu, như được giới thiệu trong Skywork-OR1. Khi entropy hiện tại bằng hoặc thấp hơn entropy_target, hệ số sẽ được tăng lên entropy_coef_delta; ngược lại, nó sẽ bị giảm đi. Hệ số chỉ được áp dụng (tức là khác không) khi entropy bằng hoặc thấp hơn mục tiêu:
training_args = GRPOConfig(
    entropy_coef=0.01,          # initial coefficient
    use_adaptive_entropy=True,
    entropy_target=5.0,         # target mean per-token entropy (nats); tune for your model
    entropy_coef_delta=0.005,   # step size per optimizer step
    entropy_coef_min=0.0,
    entropy_coef_max=1.0,
    ...
)
Các mô hình ngôn ngữ điển hình có entropy trên mỗi token từ 2–10 nats, do đó giá trị mặc định
entropy_target=0.2hầu như không bao giờ kích hoạt điều hòa — phần thưởng chỉ được áp dụng khi entropy ở mức bằng hoặc thấp hơn mục tiêu, tức là gần như sụp đổ hoàn toàn. Hãy đặt nó thành một giá trị có ý nghĩa đối với mô hình của bạn, ví dụ gần vớientropymà bạn quan sát được ở giai đoạn đầu của quá trình huấn luyện (được ghi lại dưới dạng chỉ sốentropy). Khi sử dụngtop_entropy_quantile < 1.0,entropy_targetđược áp dụng cho tập con các token có entropy cao — entropy của tập con này sẽ cao hơn so vớientropycủa toàn bộ token được ghi lại, vì vậy hãy hiệu chỉnh cho phù hợp.
Khi use_adaptive_entropy=True, hệ số entropy hiện tại entropy_coef được lưu cùng với mỗi checkpoint và được khôi phục khi tiếp tục, do đó quá trình huấn luyện có thể tiếp tục hoàn toàn.
Thử nghiệm nhanh cho GRPO
RapidFire AI là một công cụ thử nghiệm mã nguồn mở nằm trên TRL, cho phép bạn khởi chạy nhiều cấu hình GRPO cùng lúc, ngay cả trên một GPU duy nhất. Thay vì thử các cấu hình theo tuần tự, RapidFire cho phép bạn xem trước các đường cong học tập của tất cả chúng, dừng các lần chạy kém hiệu suất và nhân bản các lần chạy triển vọng với cài đặt mới trong khi đang chạy mà không cần khởi động lại. Để biết thêm thông tin, xem Tích hợp RapidFire AI.
Đào tạo Agent
GRPO hỗ trợ huấn luyện agent: mô hình gọi công cụ trong quá trình sinh và học từ kết quả.
- Một công cụ là một hàm Python thuần túy (đồng bộ hoặc bất đồng bộ) được cung cấp cho mô hình. Sử dụng
toolscho các cuộc gọi không trạng thái (máy tính, tìm kiếm web). - Môi trường là dạng tổng quát hơn: một đối tượng có trạng thái được tạo mới cho mỗi lần rollout, trong đó các phương thức công khai được phơi bày dưới dạng công cụ, kèm theo hook vòng đời
resetvàget_rewardtùy chọn cho phép nó tự quản lý phần thưởng. Sử dụngenvironment_factorykhi bạn cần trạng thái cho từng lần rollout, hook reset, hoặc phần thưởng do môi trường quản lý.
Chúng có thể kết hợp với nhau — bạn có thể truyền các tools độc lập cùng với một environment_factory.
Công cụ
Tham số tools mong đợi một danh sách các hàm Python (đồng bộ hoặc bất đồng bộ) xác định các công cụ có sẵn cho tác tử:
from trl import GRPOTrainer

trainer = GRPOTrainer(
    tools=[tool1, tool2],
    ...,
)
Mỗi công cụ phải là một hàm Python chuẩn với tham số và kiểu trả về có chú thích kiểu (type-hint), cùng với một docstring theo phong cách Google mô tả mục đích, các tham số và giá trị trả về. Để biết thêm chi tiết, hãy xem hướng dẫn Truyền công cụ.
Vòng lặp gọi công cụ của GRPO yêu cầu mẫu chat phải giữ nguyên phần đầu (việc thêm một thông điệp công cụ không được làm thay đổi cách các thông điệp trước đó được hiển thị). Đối với các họ model đã biết (ví dụ: Qwen3, DeepSeek-V3), TRL sẽ tự động thay thế bằng một mẫu huấn luyện đã vá khi công cụ được bật. Xem Mẫu Chat để biết danh sách đầy đủ.
Sử dụng max_tool_calling_iterations trong GRPOConfig để giới hạn số lượt gọi công cụ. Mặc định không có giới hạn, và quá trình sinh sẽ dừng khi mô hình tạo ra lượt phản hồi không có lời gọi công cụ nào, khi phần hoàn thành (tất cả các lượt và kết quả công cụ) đạt max_completion_length token, hoặc khi toàn bộ chuỗi đạt độ dài tối đa của mô hình (vllm_max_model_length với vllm_mode="colocate", còn lại là max_position_embeddings của mô hình).
Ví dụ:
from trl import GRPOTrainer

def multiply(a: int, b: int) -> int:
    """
    Multiplies two integers.

    Args:
        a: The first integer.
        b: The second integer.

    Returns:
        The product of the two integers.
    """
    return a * b

async def async_add(a: int, b: int) -> int:
    """
    Asynchronously adds two integers.

    Args:
        a: The first integer.
        b: The second integer.

    Returns:
        The sum of the two integers.
    """
    return a + b

trainer = GRPOTrainer(
    tools=[multiply, async_add],
    ...,
)
Môi trường
Bạn cũng có thể cung cấp các công cụ thông qua environment_factory. Ở chế độ này, GRPOTrainer tạo một instance môi trường cho mỗi rollout và công khai các phương thức công khai của môi trường dưới dạng các công cụ.
environment_factoryyêu cầutransformers>=5.2.0.
Khi bạn sử dụng environment_factory, môi trường sẽ sở hữu dữ liệu: không có train_dataset bên ngoài. Ở mỗi lượt rollout, reset() tạo ra tác vụ — tự lấy mẫu từ một kho ngữ liệu mà môi trường giữ, hoặc tạo trạng thái theo thủ tục — và trả về prompt. max_steps đặt độ dài huấn luyện. Dưới đây là một ví dụ tối giản về một môi trường tự lấy mẫu một mục tiêu và phơi bày phương thức increment (được phơi bày dưới dạng công cụ).
import random

from trl import GRPOConfig, GRPOTrainer

class IncrementEnv:
    # Reserved methods
    def reset(self, **kwargs) -> str | None:  # required; called at the start of each rollout
        self.counter = 0
        self.target = random.randint(1, 6)  # self-sample the task
        return f"Increment the counter by {self.target}."  # returned string becomes the prompt

    def get_reward(self) -> float:  # optional: the environment scores itself from its own state
        return float(self.counter == self.target)

    # Public methods (exposed as tools)
    def increment(self, step: int) -> int:
        """
        Increment the internal counter.

        Args:
            step: Value to add to the counter.

        Returns:
            The updated counter value.
        """
        self.counter += step
        return self.counter

trainer = GRPOTrainer(
    model="Qwen/Qwen3-0.6B",
    args=GRPOConfig(max_steps=1000, chat_template_kwargs={"enable_thinking": False}),
    environment_factory=IncrementEnv,
)
trainer.train()
Một lớp môi trường có hai phương thức được dành riêng: reset và get_reward. Khác với các phương thức công khai khác, những phương thức này không được phơi bày cho mô hình dưới dạng công cụ.
reset(bắt buộc) được gọi khi rollout bắt đầu. Nó có thể trả vềNonehoặc một chuỗi. Trong GRPO, khi nó trả về một chuỗi, chuỗi đó chính là prompt của người dùng.get_reward(tùy chọn, đồng bộ hoặc bất đồng bộ) không nhận đối số và trả về mộtfloat: môi trường chấm điểm cho episode vừa chạy dựa trên trạng thái nội bộ của chính nó (trò chơi có kết thúc bằng chiến thắng không? từ đã được đoán đúng chưa?). Hàm này được gọi một lần cho mỗi rollout hoàn thành và đóng vai trò là nguồn phần thưởng.
Vì môi trường tự lấy mẫu trên mỗi
reset(),Gthành viên của một nhóm GRPO có thể không chia sẻ cùng một trạng thái ban đầu, khiến đường cơ sở của nhóm hơi nhiễu hơn. Đối với các trạng thái giống nhau trong một nhóm, hãy đểreset()suy ra trạng thái một cách tất định từ một khóa chung.
Cung cấp bộ dữ liệu bên ngoài (tùy chọn)
Thay vì để môi trường tự lấy mẫu, bạn có thể cung cấp một train_dataset bên ngoài. Ví dụ, khi các tác vụ của bạn đã nằm trong một dataset, hoặc để định tuyến giữa nhiều môi trường. Với mỗi rollout, trainer sẽ lấy mẫu một hàng, sử dụng cột "prompt" của hàng đó làm prompt, và truyền các cột còn lại của hàng vào reset() dưới dạng các tham số keyword (để môi trường đọc tác vụ từ dataset).
from datasets import Dataset
from trl import GRPOTrainer

# Each row carries the prompt and the task data (here, the counter target to reach).
dataset = Dataset.from_dict(
    {
        "prompt": [[{"role": "user", "content": f"Increment the counter to {i}."}] for i in range(1, 7)],
        "target": list(range(1, 7)),
    }
)

class IncrementEnv:
    def reset(self, target, **kwargs) -> None:  # the row's `target` column arrives as a keyword argument
        self.counter = 0
        self.target = target

    def get_reward(self) -> float:
        return float(self.counter == self.target)

    def increment(self, step: int) -> int:  # exposed as a tool (see the full docstring above)
        self.counter += step
        return self.counter

trainer = GRPOTrainer(
    model="Qwen/Qwen3-0.6B",
    train_dataset=dataset,  # the dataset owns the task; the "target" column reaches reset(target=...)
    environment_factory=IncrementEnv,
)
trainer.train()
Phần thưởng
Rewards do môi trường và rewards do trainer sở hữu không loại trừ nhau. Truyền reward_funcs cho các rewards tự nhiên để tính từ completion (ví dụ: kiểm tra định dạng trên văn bản) và để môi trường trả về reward phụ thuộc trạng thái của nó thông qua get_reward. Tất cả các nguồn được cộng lại; reward_weights chỉ áp dụng cho reward_funcs (môi trường tự sở hữu thang đo của riêng nó).
def format_reward(completions, **kwargs):  # trainer-owned: scores the completion text
    ...

trainer = GRPOTrainer(
    model="Qwen/Qwen3-0.6B",
    args=GRPOConfig(max_steps=1000),
    reward_funcs=format_reward,          # trainer-owned: scores the completion
    environment_factory=IncrementEnv,    # env-owned: scores its internal state via `get_reward`
)
Một reward_func cũng có thể đọc trực tiếp trạng thái môi trường: khi environment_factory được đặt, trình huấn luyện sẽ truyền một tham số environments (một instance cho mỗi completion). Điều này đôi khi hữu ích, nhưng đối với phần thưởng phụ thuộc vào trạng thái, hãy ưu tiên sử dụng get_reward.
Cách hoạt động này hoàn toàn tương tự với AsyncGRPOTrainer.
Nhiều môi trường
Để huấn luyện trên một hỗn hợp các tác vụ trong một lần chạy (ví dụ: một tác vụ lập trình và một trò chơi), hãy truyền một từ điển ánh xạ tên môi trường đến các nhà máy thay vì một callable duy nhất. Mỗi rollout sẽ chọn môi trường của nó thông qua trường environment trong bộ dữ liệu, và chỉ các công cụ của môi trường đó được phơi bày. Điều này tránh việc rò rỉ các công cụ không liên quan (công cụ move của trò chơi cho một ví dụ lập trình, và ngược lại). Mỗi môi trường vẫn sở hữu dữ liệu của riêng mình và trả về prompt từ reset(), do đó bộ dữ liệu chỉ cần cột environment để định tuyến giữa chúng.
import random

from datasets import Dataset
from trl import GRPOConfig, GRPOTrainer


class CodingEnv:
    def reset(self, **kwargs) -> str:
        n = random.randint(1, 20)
        return f"Compute the {n}th Fibonacci number."

    def run_code(self, code: str) -> str:  # exposed as a tool only for "coding" examples
        """Run the given Python code and return its stdout.

        Args:
            code: The Python source to execute.

        Returns:
            The captured standard output.
        """
        ...

class GameEnv:
    def reset(self, **kwargs) -> str:
        return "Reach the goal tile."

    def move(self, action: str) -> str:  # exposed as a tool only for "game" examples
        """Apply an action to the game and return the new observation.

        Args:
            action: One of "up", "down", "left", "right".

        Returns:
            The observation after the move.
        """
        ...

# The dataset only routes: each row picks the environment for that rollout
dataset = Dataset.from_dict({"environment": ["coding", "game"] * 500})

trainer = GRPOTrainer(
    model="Qwen/Qwen3-0.6B",
    args=GRPOConfig(chat_template_kwargs={"enable_thinking": False}),
    train_dataset=dataset,
    reward_funcs=reward_func,
    environment_factory={"coding": CodingEnv, "game": GameEnv},
)
trainer.train()
Hàm thưởng vẫn nhận môi trường của mọi ví dụ thông qua reward_kwargs["environments"], do đó nó có thể phân nhánh dựa trên loại môi trường (ví dụ: isinstance(env, CodingEnv)). Các instance môi trường được tái sử dụng qua các bước (reset giữa các episode), nên một __init__ đắt đỏ chỉ được trả giá một lần thay vì ở mỗi bước. Trường environment được trainer tiêu thụ và không được chuyển tiếp đến reset.
Phản hồi công cụ đa phương thức
Công cụ có thể trả về hình ảnh cùng với văn bản bằng cách trả về một danh sách các khối nội dung. Điều này hữu ích cho việc huấn luyện tác tử VLM, nơi công cụ cung cấp phản hồi trực quan (ví dụ: ảnh chụp màn hình, biểu đồ, hình ảnh từ camera).
from PIL import Image

def take_screenshot() -> list:
    """
    Takes a screenshot of the current screen.

    Returns:
        The screenshot image with a description.
    """
    img = Image.open("screenshot.png")
    return [{"type": "image", "image": img}, {"type": "text", "text": "Here is the screenshot."}]
Các hình ảnh được trả về sẽ tự động được chèn vào cuộc trò chuyện và truyền cho VLM cho các lượt sinh tiếp theo.
Các Mô hình Được hỗ trợ
Đã kiểm tra với:
- Beam — ví dụ:
reflection/Beam-1.0-501B-A23B - DeepSeek-R1 — ví dụ:
deepseek-ai/DeepSeek-R1 - Gemma4 — ví dụ:
google/gemma-4-E2B-it - GLM-4-MoE (4.5, 4.6 hoặc 4.7) — ví dụ:
zai-org/GLM-4.7 - GPT-OSS — ví dụ:
openai/gpt-oss-20b - Llama 3.1 — ví dụ:
meta-llama/Llama-3.1-8B-Instruct - Llama 3.2 — ví dụ:
meta-llama/Llama-3.2-3B-Instruct - Qwen2.5 — ví dụ:
Qwen/Qwen2.5-0.5B-Instruct - Qwen3 — ví dụ:
Qwen/Qwen3-0.6B - Qwen3-VL — ví dụ:
Qwen/Qwen3-VL-2B-Instruct - Qwen3.5 — ví dụ:
Qwen/Qwen3.5-2B - Qwen3.6 — ví dụ:
Qwen/Qwen3.6-35B-A3B
Không đảm bảo tương thích với tất cả các LLM. Nếu bạn cho rằng một model nên được hỗ trợ, hãy mở một issue trên GitHub — hoặc tốt hơn nữa, gửi một pull request kèm theo các thay đổi cần thiết.
Tích hợp Môi trường
Tất cả các môi trường đều được tích hợp vào cùng một vị trí environment_factory, do đó chúng có thể thay thế cho nhau ở cấp độ TRL — hãy chọn môi trường có hệ sinh thái phù hợp với tác vụ của bạn:
| Tích hợp | Nó là gì | Sử dụng khi |
|---|---|---|
| OpenEnv | Tiêu chuẩn môi trường mở (API kiểu Gymnasium, được cung cấp qua WebSocket hoặc thực thi trong container), do Hugging Face và cộng đồng hỗ trợ. | Bạn đang sử dụng một môi trường OpenEnv có sẵn từ Hub, hoặc tự định nghĩa môi trường của mình theo tiêu chuẩn mở (ví dụ: Wordle, Sudoku, Catch). |
| OpenReward | Tích hợp với các môi trường nói ngôn ngữ ORS (catalog openreward.ai hoặc máy chủ ORS của bạn); các tác vụ và phần thưởng được cung cấp qua HTTP. | Bạn muốn huấn luyện đối với một môi trường ORS: danh mục (ví dụ Eigent/SETA), một môi trường do bạn tự lưu trữ trên hạ tầng của mình, hoặc một máy chủ cục bộ mà bạn đang phát triển. |
| Harbor | Tích hợp với các bộ nhiệm vụ Harbor: mỗi nhiệm vụ là một chỉ thị, một hình ảnh sandbox thực (docker, e2b, …) và một trình xác minh trong sandbox. | Bạn muốn huấn luyện dựa trên một bộ bài tập Harbor: một cây các bài tập, mỗi bài tập là một sandbox tự chứa kèm bộ xác minh (ví dụ: một agent phân tích dữ liệu khám phá các tệp trong sandbox và viết ra câu trả lời để bộ chấm điểm kiểm tra). |
Huấn luyện Mô hình Ngôn ngữ Thị giác
GRPO hỗ trợ huấn luyện các Mô hình Ngôn ngữ - Thị giác (VLM) trên các bộ dữ liệu đa phương thức chứa cả văn bản và hình ảnh.
Các Mô hình Được hỗ trợ
Đã kiểm tra với:
- Gemma3 — ví dụ:
google/gemma-3-4b-it - LLaVA-NeXT — ví dụ:
llava-hf/llava-v1.6-mistral-7b-hf - Qwen2-VL — ví dụ:
Qwen/Qwen2-VL-2B-Instruct - Qwen2.5-VL — ví dụ:
Qwen/Qwen2.5-VL-3B-Instruct - SmolVLM2 — ví dụ:
HuggingFaceTB/SmolVLM2-2.2B-Instruct
Không đảm bảo tương thích với tất cả các VLM. Nếu bạn cho rằng một model nên được hỗ trợ, hãy mở một issue trên GitHub — hoặc tốt hơn nữa, gửi một pull request kèm theo các thay đổi cần thiết.
Bắt đầu nhanh
Sử dụng grpo_vlm.py để tinh chỉnh một VLM. Lệnh ví dụ để huấn luyện trên lmms-lab/multimodal-open-r1-8k-verified:
torchrun --nproc_per_node 8 examples/grpo_visual_math/grpo_visual_math.py \
  --deepspeed examples/deepspeed_configs/zero3.json \
  --model_name_or_path Qwen/Qwen2.5-VL-3B-Instruct \
  --output_dir grpo-Qwen2.5-VL-3B-Instruct \
  --learning_rate 1e-5 \
  --dtype bfloat16 \
  --max_completion_length 1024 \
  --use_vllm \
  --vllm_mode colocate \
  --use_peft \
  --lora_target_modules "q_proj", "v_proj" \
  --log_completions
Mẹo cấu hình
- Sử dụng LoRA trên các lớp chiếu ngôn ngữ-thị giác
- Bật lượng tử hóa 4-bit để giảm mức sử dụng bộ nhớ
- VLMs đòi hỏi nhiều bộ nhớ — hãy bắt đầu với kích thước batch nhỏ hơn
- Hầu hết các model đều tương thích với vLLM (chế độ
servervàcolocate)
Định dạng Dữ liệu
Mỗi mẫu huấn luyện nên bao gồm:
prompt: Văn bản được định dạng qua chat template của processorimage/images: Ảnh PIL hoặc danh sách các ảnh PIL
Trainer tự động xử lý việc chuyển đổi ảnh sang tensor thông qua bộ xử lý ảnh của model.
GRPOTrainer
lớp trl.GRPOTrainer
< source >( model: str | PreTrainedModel | PeftModelreward_funcs: str | transformers.modeling_utils.PreTrainedModel | collections.abc.Callable[..., list[float | None]] | list[str | transformers.modeling_utils.PreTrainedModel | collections.abc.Callable[..., list[float | None]]] | None = Noneargs: trl.trainer.grpo_config.GRPOConfig | None = Nonetrain_dataset: datasets.arrow_dataset.Dataset | datasets.iterable_dataset.IterableDataset | None = Noneeval_dataset: datasets.arrow_dataset.Dataset | datasets.iterable_dataset.IterableDataset | datasets.dataset_dict.DatasetDict | datasets.dataset_dict.IterableDatasetDict | dict[str, datasets.arrow_dataset.Dataset | datasets.iterable_dataset.IterableDataset] | None = Noneprocessing_class: transformers.tokenization_utils_base.PreTrainedTokenizerBase | transformers.processing_utils.ProcessorMixin | None = Nonereward_processing_classes: transformers.tokenization_utils_base.PreTrainedTokenizerBase | list[transformers.tokenization_utils_base.PreTrainedTokenizerBase] | None = Nonecallbacks: list[transformers.trainer_callback.TrainerCallback] | None = Noneoptimizers: tuple[typing.Optional[torch.optim.Optimizer], typing.Optional[torch.optim.lr_scheduler.LambdaLR]] = (None, None)quantization_config: BitsAndBytesConfig | None = Nonepeft_config: PeftConfig | None = Nonetools: list[collections.abc.Callable] | None = Nonerollout_func: collections.abc.Callable[[list[str], 'GRPOTrainer'], dict[str, typing.Any]] | None = Noneenvironment_factory: collections.abc.Callable[[], trl.trainer.grpo_trainer._SupportsReset] | dict[str, collections.abc.Callable[[], trl.trainer.grpo_trainer._SupportsReset]] | None = None )
Tham số
- model (
strhoặc PreTrainedModel hoặcPeftModel) — Mô hình cần huấn luyện. Có thể là:- Một chuỗi, là model id của một model được huấn luyện trước lưu trữ trong một model repo trên huggingface.co, hoặc một
đường dẫn đến một thư mục chứa các trọng số model được lưu bằng
save_pretrained, ví dụ:
'./my_model_directory/'. Model được nạp bằng<ModelArchitecture>.from_pretrained(trong đó<ModelArchitecture>được suy ra từ cấu hình model) với các tham số từ khóa trongargs.model_init_kwargs. Nếudtypekhông được chỉ định trongargs.model_init_kwargs, giá trị mặc định sẽ làfloat32. Điều này khác với from_pretrained, nơi mà (từ Transformers v5) dtype được suy ra từ cấu hình model. - Một đối tượng PreTrainedModel. Chỉ hỗ trợ các mô hình ngôn ngữ nhân quả.
- Một đối tượng
PeftModel. Chỉ hỗ trợ các mô hình ngôn ngữ nhân quả.
- Một chuỗi, là model id của một model được huấn luyện trước lưu trữ trong một model repo trên huggingface.co, hoặc một
đường dẫn đến một thư mục chứa các trọng số model được lưu bằng
save_pretrained, ví dụ:
- reward_funcs (
RewardFunc | list[RewardFunc], tùy chọn) — Các hàm phần thưởng được sử dụng để tính toán phần thưởng. Để tính toán phần thưởng, chúng tôi gọi tất cả các hàm phần thưởng với các prompt và completions, sau đó cộng tổng các phần thưởng. Có thể bỏ qua khi phần thưởng được cung cấp bởi môi trường thông quaenvironment_factory(xem bên dưới). Có thể là:-
Một hàm phần thưởng duy nhất, chẳng hạn như:
-
Một chuỗi: ID của model của một model được huấn luyện trước được lưu trữ trong một kho model trên huggingface.co, hoặc một đường dẫn đến một thư mục chứa các trọng số model được lưu bằng save_pretrained, ví dụ:
'./my_model_directory/'. Model được nạp bằng from_pretrained vớinum_labels=1và các tham số từ khóa trongargs.model_init_kwargs. -
Một đối tượng PreTrainedModel: Chỉ hỗ trợ các mô hình phân loại chuỗi.
-
Hàm phần thưởng tùy chỉnh: Hàm này nhận các prompt và các câu trả lời được tạo ra, cùng với bất kỳ cột bổ sung nào trong bộ dữ liệu. Nó phải trả về một danh sách các phần thưởng. Các hàm phần thưởng tùy chỉnh có thể đồng bộ hoặc bất đồng bộ và cũng có thể trả về
Nonekhi phần thưởng không áp dụng cho các mẫu đó. Điều này hữu ích cho việc huấn luyện đa nhiệm, nơi các hàm phần thưởng khác nhau áp dụng cho các loại mẫu khác nhau. Khi một hàm phần thưởng trả vềNonecho một mẫu, hàm phần thưởng đó sẽ bị loại khỏi việc tính toán phần thưởng cho mẫu đó. Để biết thêm chi tiết, xem Sử dụng hàm phần thưởng tùy chỉnh.Trạng thái của trainer cũng được truyền vào hàm reward. Trạng thái của trainer là một instance của TrainerState và có thể được truy cập bằng cách truy cập tham số
trainer_statetrong chữ ký của hàm reward.
-
-
Một danh sách các hàm phần thưởng, trong đó mỗi phần tử có thể độc lập là bất kỳ loại nào trong các loại ở trên. Việc trộn lẫn các loại khác nhau trong danh sách (ví dụ: một ID mô hình dạng chuỗi và một hàm phần thưởng tùy chỉnh) là được phép.
-
- args (GRPOConfig, tùy chọn) —
Cấu hình cho trainer này. Nếu là
None, một cấu hình mặc định sẽ được sử dụng. - train_dataset (Dataset hoặc IterableDataset, tùy chọn) —
Dataset để sử dụng cho huấn luyện. Nó phải bao gồm một cột
"prompt". Bất kỳ cột bổ sung nào trong dataset sẽ bị bỏ qua. Định dạng của các mẫu có thể là:- Chuẩn: Mỗi mẫu chứa văn bản thuần túy.
- Conversational: Mỗi mẫu chứa các tin nhắn có cấu trúc (ví dụ: role và content).
Chỉ có thể được bỏ qua khi một
environment_factoryđược cung cấp và môi trường sở hữu (hoặc tạo ra theo thủ tục) dữ liệu, trả về prompt từ phương thứcreset()của nó. Trong trường hợp đó,max_stepsphải được đặt để xác định độ dài huấn luyện.Khi
train_datasetlà một IterableDataset (ví dụ: một dataset dạng streaming),max_stepsphải được cài đặt trong các đối số huấn luyện, vì độ dài của nó không thể suy ra được và tổng số bước huấn luyện là cần thiết để giới hạn vòng lặp huấn luyện và cấu hình trình lập lịch tốc độ học. - eval_dataset (Dataset, IterableDataset, DatasetDict, IterableDatasetDict hoặc
dict[str, Dataset | IterableDataset]) — Dataset được sử dụng để đánh giá. Nó phải đáp ứng các yêu cầu tương tự nhưtrain_dataset. - processing_class (PreTrainedTokenizerBase, ProcessorMixin, tùy chọn) —
Lớp xử lý được dùng để xử lý dữ liệu. Bên đệm (padding side) phải được đặt là “left”. Nếu
None, lớp xử lý sẽ được nạp từ tên mô hình bằng from_pretrained. Một token đệm,tokenizer.pad_token, phải được đặt. Nếu lớp xử lý chưa đặt token đệm,tokenizer.eos_tokensẽ được dùng làm mặc định. - reward_processing_classes (PreTrainedTokenizerBase hoặc
list[PreTrainedTokenizerBase], tùy chọn) — Các lớp xử lý tương ứng với các hàm phần thưởng được chỉ định trongreward_funcs. Có thể là:- Một lớp xử lý duy nhất: Được sử dụng khi
reward_funcschỉ chứa một hàm phần thưởng. - Một danh sách các lớp xử lý: Phải khớp với thứ tự và độ dài của các hàm phần thưởng trong
reward_funcs. Nếu được đặt thànhNone, hoặc nếu một phần tử của danh sách tương ứng với một PreTrainedModel làNone, bộ mã hóa cho mô hình sẽ được tải tự động bằng cách sử dụng from_pretrained. Đối với các phần tử trongreward_funcslà các hàm phần thưởng tùy chỉnh (không phải PreTrainedModel), các mục tương ứng trongreward_processing_classessẽ bị bỏ qua.
- Một lớp xử lý duy nhất: Được sử dụng khi
- callbacks (danh sách TrainerCallback, tùy chọn) —
Danh sách các callback để tùy chỉnh vòng lặp huấn luyện. Những callback này sẽ được thêm vào danh sách các callback mặc định được mô tả chi tiết tại đây.
Nếu bạn muốn xóa một trong các callback mặc định đang được sử dụng, hãy dùng phương thức remove_callback.
- optimizers (
tuple[torch.optim.Optimizer | None, torch.optim.lr_scheduler.LambdaLR | None], tùy chọn, mặc định là(None, None)) — Một tuple chứa optimizer và scheduler cần sử dụng. Mặc định sẽ là một instance củaAdamWtrên model của bạn và một scheduler được cung cấp bởi get_linear_schedule_with_warmup được điều khiển bởiargs. - quantization_config (BitsAndBytesConfig, tuỳ chọn) —
Cấu hình lượng tử hóa được sử dụng khi tải mô hình từ một định danh mô hình. Kết hợp với
peft_configcho huấn luyện QLoRA. Bị bỏ qua nếu mô hình đã được khởi tạo. - peft_config (
PeftConfig, tùy chọn) — Cấu hình PEFT được sử dụng để bọc model. Nếu làNone, model sẽ không được bọc. - tools (list of
Callable, optional) — Một danh sách các hàm công cụ callable (đồng bộ hoặc bất đồng bộ) mà mô hình có thể gọi trong quá trình sinh. Mỗi công cụ phải là một hàm Python chuẩn với các đối số và giá trị trả về được chú thích kiểu (type-hint) đúng cách, cùng một docstring theo phong cách Google mô tả mục đích, các đối số và giá trị trả về. Để biết thêm chi tiết, xem: https://huggingface.co/docs/transformers/en/chat_extras#passing-tools. Mô hình sử dụng tên hàm, type hints và docstring để xác định cách gọi nó. Đảm bảo rằng chat template của mô hình hỗ trợ việc sử dụng công cụ và rằng nó đã được fine-tune cho việc gọi công cụ. - rollout_func (
RolloutFunc, tùy chọn) — Hàm được sử dụng để tạo các câu trả lời hoàn chỉnh. Hàm này nhận vào danh sách các prompt được phân bổ cho tiến trình hiện tại và instance của trainer. Nó phải trả về một dict chứa các trường"prompt_ids","completion_ids"và"logprobs", và có thể tùy chọn trả về"logprob_token_ids"(cùng shape với"logprobs"). Mọi trường khác sẽ được chuyển tiếp đến các hàm reward. Hàm này nhận vào phần prompt thô của từng tiến trình mà không có sự nhân bản; nó chịu trách nhiệm trả về số lượng câu trả lời hoàn chỉnh chính xác cho mỗi prompt (xemnum_generations/num_generations_evaltrên trainer). Tính năng này mang tính thử nghiệm và có thể thay đổi hoặc bị loại bỏ vào bất kỳ lúc nào mà không cần thông báo trước. - environment_factory (
EnvironmentFactoryhoặcdict[str, EnvironmentFactory], tùy chọn) — Một callable tạo và trả về một instance môi trường, hoặc một dictionary ánh xạ tên môi trường đến các callable như vậy. Lớp môi trường nên định nghĩa các phương thức có thể được gọi như công cụ trong quá trình sinh. Mỗi phương thức nên tuân thủ cùng các yêu cầu nhưtoolsđược mô tả ở trên. Môi trường cũng phải triển khai một callableresetphương thức có thể được sử dụng để đặt lại trạng thái giữa các lần sinh. Phương thứcresetnên trả vềNonehoặc một chuỗi: khi trả về một chuỗi, chuỗi đó được thêm vào cuối thông điệp người dùng trước khi sinh. Môi trường cũng có thể định nghĩa mộtget_rewardphương thức không nhận đối số và trả về mộtfloat: khi có mặt, môi trường sở hữu phần thưởng, vàget_rewardđược gọi một lần cho mỗi rollout hoàn thành để chấm điểm nó từ trạng thái nội bộ của môi trường. Nó hoạt động như một nguồn phần thưởng bổ sung (với trọng số 1, được ghi log dưới tên lớp của môi trường) bên cạnhreward_funcs, sau đó trở thành tùy chọn.Với một callable duy nhất, mọi ví dụ đều sử dụng cùng một môi trường, với một instance cho mỗi rollout để các tương tác của chúng được cách ly. Với một dictionary, mỗi ví dụ phải có trường
environmentđể chọn môi trường của nó theo tên, và chỉ các công cụ của môi trường đó được hiển thị trong prompt của nó — cho phép một lần chạy kết hợp các tác vụ (ví dụ: một môi trường lập trình và một trò chơi). Tính năng này đang ở giai đoạn thử nghiệm và có thể thay đổi hoặc bị loại bỏ vào bất kỳ lúc nào mà không cần thông báo trước.
Trainer cho phương pháp Tối ưu hóa Chính sách Tương đối Nhóm (Group Relative Policy Optimization - GRPO). Thuật toán này ban đầu được đề xuất trong bài báo DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models.
Ví dụ:
>>> from trl import GRPOTrainer
>>> from trl.rewards import accuracy_reward
>>> from datasets import load_dataset

>>> dataset = load_dataset("trl-lib/DeepMath-103K", split="train")

>>> trainer = GRPOTrainer(
...     model="Qwen/Qwen2.5-0.5B-Instruct",
...     reward_funcs=accuracy_reward,
...     train_dataset=dataset,
... )
>>> trainer.train()
train
< source >( resume_from_checkpoint: str | bool | None = Nonetrial: optuna.Trial | dict[str, Any] | None = Noneignore_keys_for_eval: list[str] | None = None ) → ~trainer_utils.TrainOutput
Tham số
- resume_from_checkpoint (
strhoặcbool, tùy chọn) — Nếu làstr, đường dẫn cục bộ đến một checkpoint đã lưu bởi một phiênTrainertrước đó. Nếu làboolvà bằngTrue, tải checkpoint cuối cùng trong args.output_dir do một phiênTrainertrước đó lưu lại. Nếu có, quá trình huấn luyện sẽ tiếp tục từ trạng thái model/optimizer/scheduler được tải ở đây. - trial (
optuna.Trialhoặcdict[str, Any], tùy chọn) — Lần chạy thử nghiệm hoặc từ điển siêu tham số cho việc tìm kiếm siêu tham số. - ignore_keys_for_eval (
list[str], tùy chọn) — Một danh sách các khóa trong đầu ra của mô hình của bạn (nếu đó là một từ điển) cần được bỏ qua khi thu thập các dự đoán để đánh giá trong quá trình huấn luyện.
Trả về
~trainer_utils.TrainOutput
Đối tượng chứa số bước toàn cục, tổn thất huấn luyện và các chỉ số.
Điểm vào chính cho quá trình huấn luyện.
Sẽ lưu mô hình, để bạn có thể tải lại bằng from_pretrained().
Chỉ lưu từ tiến trình chính.
push_to_hub
< source >( commit_message: str | None = 'End of training'blocking: bool = Truetoken: str | None = Nonerevision: str | None = Noneprivate: bool | None = None**kwargs )
Tham số
- commit_message (
str, tùy chọn, mặc định là"End of training") — Thông điệp để commit khi đẩy lên. - blocking (
bool, tùy chọn, mặc định làTrue) — Xác định xem hàm có chỉ trả về khigit pushđã hoàn tất hay không. - token (
str, tùy chọn, mặc định làNone) — Token có quyền ghi để ghi đè lên các args gốc của Trainer. - revision (
str, tùy chọn) — Phiên bản git để commit từ. Mặc định là đầu của nhánh “main”. - private (
bool, tuỳ chọn) — Xác định xem có đặt kho thành riêng tư khi tạo hay không. Mặc định làargs.hub_private_repo. Không có tác dụng nếu kho đã tồn tại. - kwargs (
dict[str, Any], tùy chọn) — Các đối số từ khóa bổ sung được truyền đến~Trainer.create_model_card.
Tải self.model và self.processing_class lên 🤗 model hub tại repo self.args.hub_model_id.
GRPOConfig
lớp trl.GRPOConfig
< source >( output_dir: str | None = Noneper_device_train_batch_size: int = 8num_train_epochs: float = 3.0max_steps: int = -1learning_rate: float = 1e-06lr_scheduler_type: transformers.trainer_utils.SchedulerType | str = 'linear'lr_scheduler_kwargs: dict | str | None = Nonewarmup_steps: float = 0optim: transformers.training_args.OptimizerNames | str = 'adamw_torch_fused'optim_args: str | None = Noneweight_decay: float = 0.0adam_beta1: float = 0.9adam_beta2: float = 0.999adam_epsilon: float = 1e-08optim_target_modules: None | str | list[str] = Nonegradient_accumulation_steps: int = 1average_tokens_across_devices: bool = Truemax_grad_norm: float = 1.0label_smoothing_factor: float = 0.0bf16: bool | None = Nonefp16: bool = Falsebf16_full_eval: bool = Falsefp16_full_eval: bool = Falsetf32: bool | None = Noneactivation_checkpointing: bool | None = Noneactivation_checkpointing_kwargs: dict[str, typing.Any] | str | None = Nonegradient_checkpointing: bool = Truegradient_checkpointing_kwargs: dict[str, typing.Any] | str | None = Nonetorch_compile: bool = Falsetorch_compile_backend: str | None = Nonetorch_compile_mode: str | None = Noneuse_liger_kernel: bool = Falseliger_kernel_config: dict[str, bool] | None = Noneuse_cache: bool = Falseneftune_noise_alpha: float | None = Nonetorch_empty_cache_steps: int | None = Noneauto_find_batch_size: bool = Falselogging_strategy: transformers.trainer_utils.IntervalStrategy | str = 'steps'logging_steps: float = 10logging_first_step: bool = Falselog_on_each_node: bool = Truelogging_nan_inf_filter: bool = Trueinclude_num_input_tokens_seen: str | bool = 'no'log_level: str = 'passive'log_level_replica: str = 'warning'disable_tqdm: bool | None = Nonereport_to: None | str | list[str] = 'none'run_name: str | None = Noneproject: str = 'huggingface'trackio_space_id: str | None = Nonetrackio_bucket_id: str | None = Nonetrackio_static_space_id: typing.Union[str, NoneType, typing.Literal[False]] = Noneeval_strategy: transformers.trainer_utils.IntervalStrategy | str = 'no'eval_steps: float | None = Noneeval_delay: float = 0per_device_eval_batch_size: int = 8prediction_loss_only: bool = Falseeval_on_start: bool = Falseeval_do_concat_batches: bool = Trueeval_use_gather_object: bool = Falseeval_accumulation_steps: int | None = Noneinclude_for_metrics: list[str] = <factory>batch_eval_metrics: bool = Falsesave_only_model: bool = Falsesave_strategy: transformers.trainer_utils.SaveStrategy | str = 'steps'save_steps: float = 500save_on_each_node: bool = Falsesave_total_limit: int | None = Noneenable_jit_checkpoint: bool = Falsepush_to_hub: bool = Falsehub_token: str | None = Nonehub_private_repo: bool | None = Nonehub_model_id: str | None = Nonehub_strategy: transformers.trainer_utils.HubStrategy | str = 'every_save'hub_always_push: bool = Falsehub_revision: str | None = Noneload_best_model_at_end: bool = Falsemetric_for_best_model: str | None = Nonegreater_is_better: bool | None = Noneignore_data_skip: bool = Falserestore_callback_states_from_checkpoint: bool = Falsefull_determinism: bool = Falseseed: int = 42data_seed: int | None = Noneuse_cpu: bool = Falseaccelerator_config: dict | str | None = Noneparallelism_config: accelerate.parallelism_config.ParallelismConfig | None = Nonedataloader_drop_last: bool = Falsedataloader_num_workers: int = 0dataloader_pin_memory: bool = Truedataloader_persistent_workers: bool = Falsedataloader_prefetch_factor: int | None = Nonedataloader_multiprocessing_context: str | None = Nonedataloader_in_order: bool = Trueremove_unused_columns: bool | None = Falselabel_names: list[str] | None = Nonetrain_sampling_strategy: str = 'random'length_column_name: str = 'length'ddp_find_unused_parameters: bool | None = Noneddp_bucket_cap_mb: int | None = Noneddp_broadcast_buffers: bool | None = Noneddp_static_graph: bool | None = Noneddp_backend: str | None = Noneddp_timeout: int = 1800fsdp: str | None = Nonefsdp_config: dict[str, typing.Any] | str | None = Nonedeepspeed: dict | str | None = Nonedebug: str | list[transformers.debug_utils.DebugOption] = ''skip_memory_metrics: bool = Truedo_train: bool = Falsedo_eval: bool = Falsedo_predict: bool = Falseresume_from_checkpoint: str | None = Nonelocal_rank: int = -1model_init_kwargs: dict[str, typing.Any] | str | None = Nonetrust_remote_code: bool = Falserouter_aux_loss_coef: float | None = Nonedisable_dropout: bool = Falsecast_lm_head_to_fp32: bool = Falsenum_generations: int | None = 8num_generations_eval: int | None = Nonemax_completion_length: int | None = 512ds3_gather_for_generation: bool = Trueshuffle_dataset: bool | None = Truepad_to_multiple_of: int | str | None = 'auto'generation_batch_size: int | None = Nonesteps_per_generation: int | None = Nonetemperature: float = 1.0top_p: float = 1.0top_k: int = 0min_p: float | None = Nonegeneration_kwargs: dict | str | None = Nonechat_template_kwargs: dict | str | None = Nonerepetition_penalty: float = 1.0cache_implementation: str | None = Noneuse_vllm: bool = Falsevllm_mode: str = 'colocate'vllm_model_impl: str = 'vllm'vllm_enable_sleep_mode: bool = Falsevllm_structured_outputs_regex: str | None = Nonevllm_server_base_url: str | None = Nonevllm_server_host: str = '0.0.0.0'vllm_server_port: int = 8000vllm_server_timeout: float = 240.0vllm_group_port: int = 51216vllm_gpu_memory_utilization: float = 0.3vllm_max_model_length: int | None = Nonevllm_tensor_parallel_size: int = 1beta: float = 0.0num_iterations: int = 1epsilon: float = 0.2delta: float | None = Noneepsilon_high: float | None = Nonesapo_temperature_neg: float = 1.05sapo_temperature_pos: float = 1.0vespo_k_pos: float = 2.0vespo_lambda_pos: float = 3.0vespo_k_neg: float = 3.0vespo_lambda_neg: float = 2.0importance_sampling_level: str = 'token'reward_weights: list[float] | None = Nonemulti_objective_aggregation: str = 'sum_then_normalize'scale_rewards: str = 'group'loss_type: str = 'dapo'mask_truncated_completions: bool = Falsesync_ref_model: bool = Falseref_model_mixup_alpha: float = 0.6ref_model_sync_steps: int = 512top_entropy_quantile: float = 1.0entropy_coef: float = 0.0use_adaptive_entropy: bool = Falseentropy_coef_min: float = 0.0entropy_coef_max: float = 1.0entropy_coef_delta: float = 0.005entropy_target: float = 0.2max_tool_calling_iterations: int | None = Nonevllm_importance_sampling_correction: bool = Truevllm_importance_sampling_mode: str = 'sequence_mask'vllm_importance_sampling_clip_max: float | None = 3.0vllm_importance_sampling_clip_min: float | None = Noneoff_policy_mask_threshold: float | None = Noneuse_bias_correction_kl: bool = Truelog_completions: bool = Falselog_multimodal: bool = Truenum_completions_to_print: int | None = Nonelog_unique_prompts: bool = Falselog_completions_hub_repo: str | None = Noneuse_transformers_continuous_batching: bool = Falsetransformers_continuous_batching_config: dict | str | None = Noneuse_transformers_paged: bool = Falsevllm_importance_sampling_cap: float | None = None )
Các tham số kiểm soát mô hình và mô hình tham chiếu
- model_init_kwargs (
strhoặcdict[str, Any], tùy chọn) — Các đối số dạng từ khóa cho from_pretrained, được sử dụng khi đối sốmodelcủa GRPOTrainer được cung cấp dưới dạng chuỗi. Giá trịrevisioncũng được sử dụng khi nạp các lớp xử lý. - trust_remote_code (
bool, tùy chọn, mặc định làFalse) — Có cho phép tải các model và tokenizer có kèm theo mã Python tùy chỉnh từ Hub hay không. Tham số này được chuyển tiếp đến from_pretrained và from_pretrained. Cũng được áp dụng cho việc tải reward-model và reward-tokenizer. - router_aux_loss_coef (
float, tùy chọn) — Hệ số của tổn thất phụ cân bằng tải cho các mô hình Mixture-of-Experts (MoE), được cộng vào tổn thất huấn luyện với trọng số này. Khi không được đặt, giá trị được khai báo trong cấu hình mô hình sẽ được sử dụng. Đặt thành0.0để tắt nó. Gặp lỗi khi sử dụng với mô hình không phải MoE. - disable_dropout (
bool, tùy chọn, mặc định làFalse) — Có vô hiệu hóa dropout trong mô hình hay không. Điều này hữu ích khi huấn luyện với một mô hình tham chiếu, vì nó ngăn mô hình tạo ra các logprobs khác nhau cho cùng một đầu vào. - cast_lm_head_to_fp32 (
bool, tùy chọn, mặc định làFalse) — Có nên chuyển (cast) phần đầu mô hình ngôn ngữ (language modeling head) của các mô hình policy và reference sang float32 hay không. Theo khuyến nghị của công thức ScaleRL. Cờ này chỉ được hỗ trợ khi mô hình có các lớp word embedding và language modeling head không liên kết với nhau, tức làtie_word_embeddingstrong cấu hình mô hình là False.
Các tham số kiểm soát tiền xử lý dữ liệu
- remove_unused_columns (
bool, tùy chọn, mặc định làFalse) — Có nên chỉ giữ lại cột"prompt"trong tập dữ liệu hay không. Nếu bạn sử dụng một hàm thưởng tùy chỉnh yêu cầu bất kỳ cột nào khác ngoài"prompts"và"completions", bạn nên giữ giá trị này làFalse. - num_generations (
int, tuỳ chọn, mặc định là8) — Số lượng bản sinh cần lấy mẫu cho mỗi prompt. Kích thước batch hiệu dụng (num_processes * per_device_batch_size- gradient_accumulation_steps) phải chia hết cho giá trị này.
- num_generations_eval (
int, tùy chọn) — Số lượng generation cần lấy mẫu trong quá trình đánh giá. Điều này cho phép sử dụng ít generation hơn trong đánh giá để tiết kiệm tài nguyên tính toán. Nếu làNone, sẽ sử dụng giá trị củanum_generations. - max_completion_length (
inthoặcNone, tùy chọn, mặc định là512) — Độ dài tối đa của phần hoàn thành được tạo ra. - ds3_gather_for_generation (
bool, tùy chọn, mặc định làTrue) — Cài đặt này áp dụng cho DeepSpeed ZeRO-3. Nếu được bật, trọng số của mô hình chính sách sẽ được thu thập (gather) cho quá trình sinh, giúp cải thiện tốc độ sinh. Tuy nhiên, việc tắt tùy chọn này cho phép huấn luyện các mô hình vượt quá dung lượng VRAM của một GPU đơn lẻ, dù phải đánh đổi bằng tốc độ sinh chậm hơn. Việc tắt tùy chọn này không tương thích với sinh bằng vLLM. - shuffle_dataset (
bool, tùy chọn, mặc định làTrue) — Có nên xáo trộn bộ dữ liệu huấn luyện hay không. - pad_to_multiple_of (
inthoặcstr, tùy chọn, mặc định là"auto") — Nếu được đặt, các id của prompts và completions sẽ được đệm (padding) đến một bội số của giá trị này."auto"sẽ đệm đến bội số của 128 trên Neuron (AWS Trainium), nơi chỉ biên dịch một lần cho mỗi hình dạng đầu vào, và không đệm ở các nơi khác.
Các tham số kiểm soát quá trình sinh
- generation_batch_size (
int, tùy chọn) — Kích thước batch dùng cho quá trình sinh. Nếu làNone, giá trị mặc định sẽ là kích thước batch huấn luyện hiệu dụng:per_device_train_batch_size * num_processes * steps_per_generation. Nói cách khác, có một batch sinh được xử lý cho mỗi bước tối ưu hóa. Không thể dùng đồng thời vớisteps_per_generation. - steps_per_generation (
int, tùy chọn) — Số bước cho mỗi lần sinh. Nếu làNone, giá trị mặc định sẽ làgradient_accumulation_steps. Loại trừ lẫn nhau vớigeneration_batch_size. - temperature (
float, tùy chọn, mặc định là1.0) — Nhiệt độ cho quá trình lấy mẫu. Nhiệt độ càng cao, các phần hoàn thành càng ngẫu nhiên. - top_p (
float, tùy chọn, mặc định là1.0) — Kiểm soát xác suất tích lũy của các token hàng đầu cần xem xét. Phải nằm trong khoảng (0, 1]. Đặt thành1.0để xem xét tất cả các token. - top_k (
int, tùy chọn, mặc định là0) — Số lượng token từ vựng có xác suất cao nhất được giữ lại cho lọc top-k. Nếu là0, lọc top-k sẽ bị vô hiệu hóa và tất cả các token đều được xem xét. - min_p (
float, tùy chọn) — Xác suất tối thiểu của token, sẽ được nhân với xác suất của token có khả năng cao nhất. Giá trị này phải nằm trong khoảng từ0.0đến1.0. Các giá trị điển hình nằm trong khoảng0.01-0.2. - generation_kwargs (
dict[str, Any], tùy chọn) — Các đối số từ khóa bổ sung để truyền cho GenerationConfig (nếu dùng transformers) hoặcSamplingParams(nếu dùng vLLM) khi lấy mẫu các câu trả lời hoàn chỉnh. Tham số này có thể được dùng để tùy chỉnh thêm hành vi sinh, chẳng hạn như đặtsuppress_tokens,num_beams, v.v. Nếu nó chứa các khóa xung đột với các tham số sinh khác (nhưmin_p,top_p, v.v.), chúng sẽ ghi đè lên các tham số đó. - chat_template_kwargs (
dict[str, Any], tùy chọn) — Các đối số từ khóa bổ sung để truyền cho hàmapply_chat_templatekhi tạo các câu trả lời hoàn chỉnh. - repetition_penalty (
float, tùy chọn, mặc định là1.0) — Giá trị động áp dụng hình phạt cho các token mới dựa trên việc chúng có xuất hiện trong prompt và văn bản đã tạo ra cho đến hiện tại hay không. Các giá trị >1.0khuyến khích mô hình sử dụng các token mới, trong khi các giá trị <1.0khuyến khích mô hình lặp lại các token. - cache_implementation (
str, tùy chọn) — Cách triển khai phương pháp cache để tạo nhanh hơn khiuse_vllmđược đặt thànhFalse.
Các tham số kiểm soát việc tăng tốc sinh nội dung được hỗ trợ bởi vLLM
- use_vllm (
bool, tùy chọn, mặc định làFalse) — Có sử dụng vLLM để tạo các câu trả lời hoàn chỉnh hay không. Nếu đặt thànhTrue, trình huấn luyện sẽ sử dụng vLLM để tạo nội dung thay vì model.generate() mặc định. Yêu cầuvllmphải được cài đặt. - vllm_mode (
str, tuỳ chọn, mặc định là"colocate") — Chế độ sử dụng cho tích hợp vLLM khiuse_vllmđược đặt thànhTrue. Phải là một trong"server"hoặc"colocate"."server": Trainer sẽ gửi các yêu cầu sinh nội dung đến một server vLLM riêng. Hãy đảm bảo rằng một server vLLM đang chạy (khởi chạy bằngvllm serve)."colocate": vLLM sẽ chạy trong cùng một tiến trình và chia sẻ các GPU huấn luyện. Cách này tránh được nhu cầu về một máy chủ riêng biệt nhưng có thể gây ra xung đột tài nguyên với quá trình huấn luyện.
- vllm_model_impl (
str, không bắt buộc, mặc định là"vllm") — Cài đặt mô hình để sử dụng cho vLLM. Phải là một trong"transformers"hoặc"vllm"."transformers": Sử dụng backendtransformerscho cài đặt mô hình."vllm": Sử dụng thư việnvllmcho cài đặt mô hình. - vllm_enable_sleep_mode (
bool, tùy chọn, mặc định làFalse) — Bật chế độ ngủ của vLLM để chuyển trọng số/bộ đệm ra ngoài trong bước tối ưu hóa. Giữ mức sử dụng bộ nhớ GPU thấp, nhưng việc đánh thức engine sẽ thêm độ trễ chuyển dữ liệu giữa host và thiết bị. - vllm_structured_outputs_regex (
str, tuỳ chọn) — Regex cho structured outputs của vLLM. NếuNone(mặc định), structured outputs sẽ bị tắt.
Các tham số điều khiển máy chủ vLLM (chỉ được sử dụng khi `vllm_mode` là `"server"`)
- vllm_server_base_url (
str, tùy chọn) — URL gốc cho máy chủ vLLM (ví dụ:"http://localhost:8000"). Nếu được cung cấp,vllm_server_hostvàvllm_server_portsẽ bị bỏ qua. - vllm_server_host (
str, tuỳ chọn, mặc định là"0.0.0.0") — Host của máy chủ vLLM cần kết nối. Bỏ qua nếuvllm_server_base_urlđược cung cấp. - vllm_server_port (
int, tuỳ chọn, mặc định là8000) — Cổng của máy chủ vLLM để kết nối. Bỏ qua nếuvllm_server_base_urlđược cung cấp. - vllm_server_timeout (
float, tuỳ chọn, mặc định là240.0) — Tổng thời gian chờ (tính bằng giây) để máy chủ vLLM khởi động. Nếu máy chủ chưa sẵn sàng sau thời gian chờ này, mộtConnectionErrorsẽ được ném ra. - vllm_group_port (
int, tuỳ chọn, mặc định là51216) — Số cổng cho nhóm cập nhật trọng số. Cổng này được dùng để liên lạc với máy chủ vLLM. Trừ khi cổng đang bị chiếm dụng, bạn không cần phải thay đổi nó.
Các tham số điều khiển việc thực thi vLLM colocated (chỉ được sử dụng khi `vllm_mode` là `"colocate"`)
- vllm_gpu_memory_utilization (
float, tuỳ chọn, mặc định là0.3) — Kiểm soát mức sử dụng bộ nhớ GPU cho vLLM. Cài đặt này chỉ áp dụng khivllm_modeđược đặt thành"colocate". Nếu bạn đang sử dụngvllm_mode="server", tham số này phải được truyền riêng khi khởi động máy chủ vLLM thông qua cờ--vllm_gpu_memory_utilization. - vllm_max_model_length (
int, tùy chọn) — Cửa sổ ngữ cảnh cho vLLM. Đặt giá trị này ít nhất bằng độ dài prompt tối đa trong bộ dữ liệu cộng vớimax_completion_length; nếu bỏ qua, giá trị sẽ được suy ra từ cấu hình mô hình. - vllm_tensor_parallel_size (
int, tùy chọn, mặc định là1) — Kiểm soát kích thước song song tensor cho vLLM. Cài đặt này chỉ áp dụng khivllm_modeđược đặt thành"colocate". Nếu bạn đang sử dụngvllm_mode="server", tham số này phải được truyền riêng khi khởi động máy chủ vLLM thông qua cờ--vllm_tensor_parallel_size.
Các tham số kiểm soát quá trình huấn luyện
- beta (
float, tùy chọn, mặc định là0.0) — Hệ số KL. Nếu0.0(mặc định), mô hình tham chiếu sẽ không được nạp, giúp giảm mức sử dụng bộ nhớ và cải thiện tốc độ huấn luyện. DeepSeek-R1 khuyến khích suy luận trong LLM thông qua học tăng cường sử dụng giá trị0.001. - num_iterations (
int, tùy chọn, mặc định là1) — Số lần lặp cho mỗi batch (ký hiệu là μ trong thuật toán). - epsilon (
float, tùy chọn, mặc định là0.2) — Giá trị epsilon cho việc cắt (clipping). - delta (
float, tùy chọn) — Bật ngưỡng cắt trên trong tổn thất GRPO hai phía khi được đặt thành một số float. NếuNone(mặc định), việc cắt GRPO tiêu chuẩn sẽ được sử dụng. Khuyến nghị nên lớn hơn1 + εkhi được bật. Phương pháp này được giới thiệu trong báo cáo kỹ thuật INTELLECT-2. - epsilon_high (
float, tùy chọn) — Giá trị epsilon cận trên để cắt. Nếu không được chỉ định, mặc định sẽ bằng giá trị cận dưới được chỉ định trong tham sốepsilon. Bài báo DAPO khuyến nghị0.28. Khi sử dụng vớiloss_type='cispo', giá trị này tương ứng với tham số ε_max được chỉ định trong bài báo ScaleRL và mặc định là giá trị khuyến nghị5.0. - sapo_temperature_neg (
float, tùy chọn, mặc định là1.05) — Nhiệt độ cho các token có điểm lợi thế không dương, được sử dụng trong hàm mấtsapo. Tham số này được giới thiệu trong bài báo Soft Adaptive Policy Optimization. - sapo_temperature_pos (
float, tùy chọn, mặc định là1.0) — Nhiệt độ cho các token có điểm lợi thế dương được sử dụng trong hàm mấtsapo. Tham số này được giới thiệu trong bài báo Soft Adaptive Policy Optimization. - vespo_k_pos (
float, tuỳ chọn, mặc định là2.0) — tham số k cho các lợi thế dương, đây là số mũ trong hàm mất mát VESPO. Kiểm soát mức độ mà chúng ta giảm trọng số của các mẫu có trọng số quan trọng thấp (khi tỷ lệ lấy mẫu quan trọng < 1). - vespo_lambda_pos (
float, tùy chọn, mặc định là3.0) — tham số lambda cho các lợi thế dương, đây là hệ số suy giảm trong tổn thất VESPO. Kiểm soát mức độ mà chúng ta giảm trọng số của các mẫu có trọng số quan trọng cao (khi tỷ lệ lấy mẫu quan trọng > 1). - vespo_k_neg (
float, tùy chọn, mặc định là3.0) — tham số k cho các lợi thế âm, đây là số mũ trong hàm mất VESPO. Kiểm soát mức độ mà chúng ta giảm trọng số của các mẫu có trọng số quan trọng thấp (khi tỷ lệ lấy mẫu quan trọng < 1). - vespo_lambda_neg (
float, tùy chọn, mặc định là2.0) — tham số lambda cho các lợi thế âm, đây là hệ số suy giảm mũ trong tổn thất VESPO. Kiểm soát mức độ mà chúng ta giảm trọng số của các mẫu có trọng số quan trọng cao (khi tỷ lệ lấy mẫu quan trọng > 1). - importance_sampling_level (
str, tùy chọn, mặc định là"token") — Kiểm soát việc tỷ lệ importance sampling được tính ở mức"token"hay"sequence"."token"giữ nguyên các tỷ lệ log-probability thô cho từng token (một trọng số cho mỗi token)."sequence"lấy trung bình các tỷ lệ log-probability trên các token hợp lệ để tạo ra một tỷ lệ duy nhất cho mỗi sequence. Bài báo GSPO cho thấy việc lấy mẫu ở mức sequence thường mang lại quá trình huấn luyện ổn định hơn và sự phù hợp tốt hơn với phần thưởng ở mức sequence. - reward_weights (
list[float], tùy chọn) — Trọng số cho mỗi hàm phần thưởng. Phải khớp với số lượng các hàm phần thưởng. Nếu làNone, tất cả các phần thưởng sẽ được cân bằng với trọng số1.0. - multi_objective_aggregation (
str, tuỳ chọn, mặc định là"sum_then_normalize") — Phương pháp để tổng hợp nhiều hàm phần thưởng. Các giá trị được hỗ trợ là:"sum_then_normalize"(mặc định): Trước tiên cộng các phần thưởng có trọng số từ mỗi hàm phần thưởng, sau đó áp dụng thang đo/chuẩn hóa phần thưởng như được chỉ định bởiscale_rewards(xemscale_rewardsđể biết chi tiết)."normalize_then_sum": Trước tiên chuẩn hóa/thang đo từng hàm phần thưởng trên các thế hệ (trong mỗi nhóm), sau đó cộng các phần thưởng đã chuẩn hóa bằng các trọng số được chỉ định. Phần thưởng tổng hợp sau đó được chuẩn hóa ở mức lô khi hình thành các lợi thế. Đây là cách tiếp cận được đề xuất từ bài báo GDPO: Group reward-Decoupled Normalization Policy Optimization for Multi-reward RL Optimization.
- scale_rewards (
strhoặcbool, tùy chọn, mặc định là"group") — Chỉ định chiến lược chuẩn hóa cho phần thưởng. Các giá trị được hỗ trợ là:Truehoặc"group"(mặc định): phần thưởng được chuẩn hóa theo độ lệch chuẩn trong từng nhóm, đảm bảo phương sai đơn vị trong mỗi nhóm."batch": phần thưởng được chuẩn hóa theo độ lệch chuẩn trên toàn bộ batch, như được đề xuất trong bài báo PPO Lite.Falsehoặc"none": không áp dụng bất kỳ phép mở rộng nào. Bài báo Dr. GRPO khuyến nghị không mở phần thưởng, vì việc mở theo độ lệch chuẩn sẽ gây ra thiên kiến về độ khó ở cấp độ câu hỏi.
- loss_type (
str, tuỳ chọn, mặc định là"dapo") — Chỉ định công thức loss cần sử dụng. Các giá trị được hỗ trợ là:"grpo": Tổng hợp tổn thất ở cấp độ token bằng cách chuẩn hóa theo độ dài chuỗi. Không được khuyến nghị do thiên lệch về độ dài—cách tiếp cận này có xu hướng ưu tiên các phần hoàn thành ngắn hơn khi có lợi thế dương và dài hơn khi có lợi thế âm."dr_grpo": Tổng hợp tổn thất ở cấp độ token bằng cách chuẩn hóa với một hằng số toàn cục. Phương pháp này được giới thiệu trong bài báo Dr. GRPO để loại bỏ thiên lệch về độ dài. Giá trị của hằng số tương ứng vớimax_completion_length."dapo"(mặc định): Tổng hợp tổn thất ở cấp độ token bằng cách chuẩn hóa với số lượng token hoạt động trong lô tích lũy toàn cục. Phương pháp này được giới thiệu trong bài báo DAPO để loại bỏ thiên lệch về độ dài."bnpo": Tổng hợp tổn thất ở cấp độ token bằng cách chuẩn hóa với số lượng token hoạt động trong batch cục bộ. Lưu ý rằng việc chuẩn hóa chỉ được thực hiện trên batch cục bộ, do đó kết quả có thể thay đổi nhẹ tùy thuộc vào kích thước batch cục bộ, mặc dù kích thước batch hiệu dụng là không đổi. Khi sử dụngper_device_train_batch_size==1, tổn thất tương đương với tổn thất GRPO."cispo": Cắt các trọng số lấy mẫu quan trọng thay vì các trọng số lấy mẫu quan trọng đã được nhân với lợi thế. Các trọng số đã cắt sau đó được nhân với lợi thế và log probs của mô hình chính sách. Tổn thất của từng token được tổng hợp bằng cách chuẩn hóa với số lượng token hoạt động trong lô tích lũy toàn cục. Phương pháp này được giới thiệu trong bài báo MiniMax-M1."sapo": Mất Soft Adaptive Policy Optimization, như được giới thiệu trong bài báo Soft Adaptive Policy Optimization. Thay thế việc cắt cứng bằng một cổng điều khiển nhiệt độ mượt mà, làm suy giảm thích ứng các cập nhật ngoài chính sách trong khi vẫn giữ lại các tín hiệu học tập hữu ích."luspo": Tổn thất Tối ưu hóa Chính sách Chuỗi Không thiên vị về Độ dài. Một tổn thất ở cấp độ chuỗi, trong đó tổn thất của mỗi chuỗi được nhân với độ dài của nó. Đây là một biến thể của GSPO và yêu cầuimportance_sampling_level="sequence". Được giới thiệu trong bài báo LUSPO."vespo": Tối ưu hóa chính sách mềm ở cấp độ chuỗi biến phân. Thay thế việc cắt cứng bằng một hàm trọng số Gamma không đối xứng, mượt, được áp dụng trực tiếp lên các trọng số quan trọng ở cấp độ chuỗi. Được giới thiệu trong bài báo VESPO.
- mask_truncated_completions (
bool, tùy chọn, mặc định làFalse) — Khi được bật, các phần hoàn thành bị cắt ngắn sẽ bị loại khỏi việc tính toán loss, ngăn chúng bị phạt sai và gây nhiễu trong quá trình huấn luyện. Theo bài báo DAPO, đây là một thực hành tốt cho sự ổn định của huấn luyện. - sync_ref_model (
bool, tùy chọn, mặc định làFalse) — Có đồng bộ hóa mô hình tham chiếu với mô hình đang hoạt động mỗiref_model_sync_stepsbước hay không, sử dụng tham sốref_model_mixup_alpha. Việc đồng bộ hóa này bắt nguồn từ bài báo TR-DPO. - ref_model_mixup_alpha (
float, tùy chọn, mặc định là0.6) — tham số α từ bài báo TR-DPO, kiểm soát sự pha trộn giữa chính sách hiện tại và chính sách tham chiếu trước đó trong quá trình cập nhật. Chính sách tham chiếu được cập nhật theo phương trình:π_ref = α * π_θ + (1 - α) * π_ref_prev. Để sử dụng tham số này, bạn phải đặtsync_ref_model=True. - ref_model_sync_steps (
int, tùy chọn, mặc định là512) — tham số τ từ bài báo TR-DPO, xác định tần suất đồng bộ hóa chính sách hiện tại với chính sách tham chiếu. Để sử dụng tham số này, bạn phải đặtsync_ref_model=True. - top_entropy_quantile (
float, tùy chọn, mặc định là1.0) — tham số ρ từ Beyond the 80/20 Rule. Giữ lại trong số hạng loss của policy chỉ các token thuộc phân vị top-ρ theo entropy của phân phối xác suất tại mỗi vị trí trong chuỗi, giúp cải thiện kết quả. Khoảng giá trị:[0.0-1.0]. Giá trị0.0sẽ che đi tất cả các token ngoại trừ token có entropy cao nhất;1.0giữ lại tất cả các token. Bài báo khuyến nghị sử dụng giá trị0.2. Nếu được sử dụng cùng vớimask_truncated_completions=True, chỉ các token từ các completion không bị cắt cụt mới được xem xét. - entropy_coef (
float, tùy chọn, mặc định là0.0) — Hệ số của số hạng điều chỉnh entropy trong hàm mất mát. Một giá trị dương sẽ thêm phần thưởng entropy, khuyến khích khám phá bằng cách ngăn chính sách sụp đổ thành các đầu ra gần như tất định. Phần thưởng luôn là entropy trung bình trên mỗi token bất kểloss_type; nó không được điều chỉnh lại để khớp với sự chuẩn hóa chính sách của một loại mất mát, do đóentropy_coefcó cùng ý nghĩa cho mọi loại mất mát. Khiuse_adaptive_entropy=True, giá trị này đóng vai trò là hệ số ban đầu và được cập nhật ở mỗi bước tối ưu hóa. Không có hiệu lực khi được đặt thành0.0(mặc định). - use_adaptive_entropy (
bool, tuỳ chọn, mặc định làFalse) — Có sử dụng kiểm soát entropy thích ứng hay không, được giới thiệu trong Skywork-OR1. Khi được bật, hệ số entropyentropy_coefsẽ được cập nhật ở mỗi bước tối ưu hóa: tăng lênentropy_coef_deltakhi entropy hiện tại thấp hơnentropy_target, và giảm đi trong trường hợp ngược lại. Hệ số này chỉ được áp dụng khi entropy ở mức bằng hoặc thấp hơnentropy_target. - entropy_coef_min (
float, tùy chọn, mặc định là0.0) — Giới hạn dưới của hệ số entropy khi sử dụng kiểm soát entropy thích ứng. - entropy_coef_max (
float, tùy chọn, mặc định là1.0) — Giới hạn trên của hệ số entropy khi sử dụng kiểm soát entropy thích ứng. - entropy_coef_delta (
float, tùy chọn, mặc định là0.005) — Bước điều chỉnh hệ số entropy tại mỗi bước tối ưu hóa trong quá trình kiểm soát entropy thích ứng. - entropy_target (
float, tuỳ chọn, mặc định là0.2) — Entropy trung bình mục tiêu cho mỗi token (đơn vị nats) được sử dụng bởi cơ chế kiểm soát entropy thích ứng. Hệ số chỉ được áp dụng khi entropy hiện tại bằng hoặc thấp hơn giá trị này. Được đo trên cùng tập token với tổn thất chính sách: mặc định là tất cả các token hoàn thành, hoặc chỉ tập con entropy cao khitop_entropy_quantile < 1.0. Các mô hình ngôn ngữ điển hình có entropy cho mỗi token trong khoảng 2–10 nats, do đó giá trị mặc định0.2hầu như không bao giờ kích hoạt điều chuẩn (chỉ xảy ra khi entropy sụp đổ gần như hoàn toàn); hãy đặt giá trị này gần với entropy mà bạn quan sát được ở giai đoạn đầu của quá trình huấn luyện (được ghi log dưới dạng chỉ sốentropy) để phần thưởng được kích hoạt trước khi chính sách sụp đổ (và cần tính đến tập con token khi sử dụngtop_entropy_quantile). - max_tool_calling_iterations (
int, tùy chọn) — Số lượt gọi công cụ tối đa khi huấn luyện một agent. Nếu làNone, sẽ không có giới hạn và quá trình sinh sẽ dừng lại khi mô hình sinh ra một lượt phản hồi không có lệnh gọi công cụ nào, khi phần hoàn thành (bao gồm tất cả các lượt và kết quả công cụ) đạt đếnmax_completion_lengthtoken, hoặc khi toàn bộ chuỗi đạt đến độ dài tối đa của mô hình (vllm_max_model_lengthvớivllm_mode="colocate", còn lại làmax_position_embeddingscủa mô hình). - vllm_importance_sampling_correction (
bool, tùy chọn, mặc định làTrue) — Xác định có áp dụng Importance Sampling (IS) để hiệu chỉnh sự lệch giữa logprobs của completion từ vLLM và logprobs huấn luyện được tính lại hay không. Nếu đặt thànhFalse, IS sẽ không được áp dụng bất kểvllm_importance_sampling_modelà gì. KhiTrue, chế độ được chọn sẽ quyết định cách tính và ràng buộc các tỷ lệ IS. Vớitop_p < 1,top_k > 0hoặcmin_p > 0, các logprobs được tính lại sẽ được chuẩn hóa trên tập ứng viên mà mỗi token được lấy mẫu từ đó, điều này yêu cầu vLLM 0.28 trở lên và, trong chế độ server, một server được khởi động với--return-sampling-mask(và--enable-scale-outtừ vLLM 0.30); nếu không, các tỷ lệ IS sẽ bị thiên lệch. vLLM giới hạn tập ứng viên đó bằngtop_k, do đótop_p < 1,min_p > 0và các đầu ra có cấu trúc, những thứ hạn chế tập ứng viên xuống các token mà ngữ pháp cho phép, đều yêu cầutop_k > 0(ví dụtop_k=512). Các đầu ra có cấu trúc, nếu không sẽ làm đình trệ quá trình huấn luyện, cũng yêu cầu tập ứng viên đó. vLLM cũng áp dụngrepetition_penaltylên các logprobs mà nó trả về, do đórepetition_penalty != 1.0yêu cầuvllm_importance_sampling_correction=False. - vllm_importance_sampling_mode (
str, tuỳ chọn, mặc định là"sequence_mask") — Chỉ định cách thực hiện Importance Sampling khivllm_importance_sampling_correction=True. Các giá trị khả dụng là:"token_truncate": IS bị cắt cụt ở mức token. Tỷ lệ trên mỗi token bị kẹp trong khoảng [C_min, C_max]."token_mask": IS bị che ở mức token. Các tỷ lệ theo token nằm ngoài khoảng [C_min, C_max] sẽ được đặt bằng không."sequence_truncate": Truncated IS ở cấp độ sequence. Một tỷ lệ sequence duy nhất được cắt (clip) vào khoảng [C_min, C_max] và áp dụng cho tất cả các token trong sequence."sequence_mask": IS bị che ở cấp độ chuỗi. Các chuỗi có tỷ lệ nằm ngoài khoảng [C_min, C_max] sẽ bị che.
- vllm_importance_sampling_clip_max (
float, tuỳ chọn, mặc định là3.0) — Giới hạn trên C_max của importance sampling được sử dụng bởivllm_importance_sampling_mode. Đối với các chế độ*_truncate, các tỉ lệ importance sẽ bị cắt (clip) từ phía trên tại C_max. Đối với các chế độ*_mask, các tỉ lệ lớn hơn C_max sẽ được đặt về không. - vllm_importance_sampling_clip_min (
float, tuỳ chọn) — Giới hạn dưới C_min của importance sampling được sử dụng bởivllm_importance_sampling_mode. Đối với các chế độ*_truncate, các tỷ lệ sẽ bị cắt (clip) từ phía dưới tại C_min. Đối với các chế độ*_mask, các tỷ lệ nhỏ hơn C_min sẽ được đặt bằng không. Để che (mask) nghiêm ngặt các tỷ lệ nhỏ hơn C_min mà không có giới hạn trên, hãy đặtvllm_importance_sampling_clip_max=None. - off_policy_mask_threshold (
float, tùy chọn) — Ngưỡng cho việc che giấu (masking) các chuỗi off-policy. Nếu làNone, việc che giấu chuỗi off-policy sẽ bị tắt. Khi được đặt, các chuỗi có lợi thế âm và độ phân kỳ KL cao sẽ bị che đi để ổn định quá trình huấn luyện. Tham số này tương ứng với ngưỡngdeltatrong Phương trình 9 của bài báo DeepSeek-V3.2. Giá trị mong đợi là một số dương (ví dụ: 0.5). - use_bias_correction_kl (
bool, tùy chọn, mặc định làTrue) — Có nhân số hạng KL với tỷ lệ lấy mẫu quan trọng hay không, để gradient KL trở thành gradient reverse-KL không chệch, như được mô tả trong bài báo DeepSeek-V3.2. Điều này làm thay đổi gradient KL bất cứ khi nàobeta != 0, kể cả trong trường hợp on-policy: tỷ lệ này có thể tính đạo hàm, nên nó ảnh hưởng đến gradient ngay cả khi giá trị của nó chính xác bằng 1. Tính chất reverse-KL không chệch được đảm bảo khiimportance_sampling_level="token"; với"sequence", một trọng số ở cấp độ chuỗi sẽ được phát tán (broadcast) lên KL của từng token.
Các tham số kiểm soát việc ghi log
- log_completions (
bool, tùy chọn, mặc định làFalse) — Có nên ghi nhật ký một mẫu các cặp (prompt, completion) mỗilogging_stepsbước hay không. Nếurichđược cài đặt, nó sẽ in ra mẫu đó. Nếu ghi nhật kýwandbvà/hoặctrackiođược bật, nó sẽ ghi mẫu đó vàowandbvà/hoặctrackio. - log_multimodal (
bool, tuỳ chọn, mặc định làTrue) — Có ghi log nội dung đa phương tiện (ảnh, video, v.v.) cùng với các kết quả hoàn thành hay không. Tắt tính năng này để giảm kích thước log khi sử dụng dữ liệu đa phương tiện độ phân giải cao. - num_completions_to_print (
int, tùy chọn) — Số lượng completions được in ra bằngrich. Nếu làNone, tất cả các completions sẽ được ghi log. - log_unique_prompts (
bool, tùy chọn, mặc định làFalse) — Có ghi log các prompt duy nhất hay không. NếuTrue, chỉ các prompt duy nhất được ghi log. NếuFalse, tất cả các prompt đều được ghi log. - log_completions_hub_repo (
str, tuỳ chọn) — Kho Hugging Face Hub để lưu các completions. Phải là tên kho hoàn chỉnh như'username/reponame'hoặc'orgname/reponame', hoặc chỉ cần'reponame', khi đó kho sẽ được tạo trong namespace của người dùng Hugging Face đang đăng nhập. Lưu ý rằng kho này sẽ là công khai trừ khi bạn đặthub_private_repo=Truehoặc mặc định của tổ chức bạn là tạo kho riêng tư.
Các tham số kiểm soát việc tăng tốc sinh văn bản nhờ continuous batching của transformers
- use_transformers_continuous_batching (
bool, tùy chọn, mặc định làFalse) — Có sử dụng động cơ continuous batching của transformers để tạo các completion hay không. Yêu cầutransformers>=5.8.0. - transformers_continuous_batching_config (
dict, tùy chọn) — Các đối số từ khóa choContinuousBatchingConfig.
Các tham số đã bị ngừng hỗ trợ
- use_transformers_paged —
Tham số
use_transformers_pagedđã bị ngừng hỗ trợ và sẽ bị loại bỏ trong phiên bản v2.0.0. Hãy sử dụnguse_transformers_continuous_batchingthay thế. - vllm_importance_sampling_cap —
Tham số
vllm_importance_sampling_capđã bị ngừng hỗ trợ và sẽ bị loại bỏ trong phiên bản v2.0.0. Hãy sử dụngvllm_importance_sampling_clip_maxthay thế.
Lớp cấu hình cho GRPOTrainer.
Lớp này chỉ bao gồm các tham số đặc thù cho huấn luyện GRPO. Để xem danh sách đầy đủ các đối số huấn luyện, hãy tham khảo tài liệu TrainingArguments. Lưu ý rằng các giá trị mặc định trong lớp này có thể khác với các giá trị trong TrainingArguments.
Sử dụng HfArgumentParser, chúng ta có thể chuyển lớp này thành các đối số argparse có thể được chỉ định trên dòng lệnh.
Các tham số này có giá trị mặc định khác với TrainingArguments:
logging_steps: Mặc định là10thay vì500.gradient_checkpointing: Mặc định làTruethay vìFalse.bf16: Mặc định làTruenếufp16không được đặt, thay vìFalse.learning_rate: Mặc định là1e-6thay vì5e-5.