
TRL documentation
GRPO Trainer
GRPO Trainer

Aperçu
TRL prend en charge le GRPO Trainer pour l’entraînement de modèles de langage, tel que décrit dans l’article DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models de Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Mingchuan Zhang, Y. K. Li, Y. Wu, Daya Guo.
L'abstract de l'article est le suivant :
Le raisonnement mathématique représente un défi majeur pour les modèles de langage en raison de sa nature complexe et structurée. Dans cet article, nous présentons DeepSeekMath 7B, qui poursuit le pré-entraînement de DeepSeek-Coder-Base-v1.5 7B avec 120 milliards de jetons liés aux mathématiques issus de Common Crawl, ainsi que des données de langage naturel et de code. DeepSeekMath 7B a obtenu un score impressionnant de 51,7 % sur le benchmark MATH de niveau compétition, sans recourir à des boîtes à outils externes ni à des techniques de vote, se rapprochant ainsi du niveau de performance de Gemini-Ultra et GPT-4. La cohérence auto sur 64 échantillons de DeepSeekMath 7B atteint 60,9 % sur MATH. La capacité de raisonnement mathématique de DeepSeekMath est attribuée à deux facteurs clés : d'abord, nous exploitons le potentiel considérable des données web disponibles publiquement grâce à un pipeline de sélection de données méticuleusement conçu. Ensuite, nous introduisons Group Relative Policy Optimization (GRPO), une variante de Proximal Policy Optimization (PPO), qui améliore les capacités de raisonnement mathématique tout en optimisant simultanément l'utilisation de la mémoire de PPO.
Cette méthode de post-entraînement a été proposée par Quentin Gallouédec.
Démarrage rapide
Cet exemple montre comment entraîner un modèle à l'aide de la méthode GRPO. Nous entraînons un modèle Qwen2.5 0.5B Instruct avec les prompts du jeu de données DeepMath-103K. Vous pouvez consulter les données du jeu de données ici :
Voici le script pour entraîner le modèle. accuracy_reward nécessite math-verify, que vous pouvez installer avec pip install trl[math_verify].
# train_grpo.py
from datasets import load_dataset
from trl import GRPOTrainer
from trl.rewards import accuracy_reward

dataset = load_dataset("trl-lib/DeepMath-103K", split="train")

trainer = GRPOTrainer(
    model="Qwen/Qwen2.5-0.5B-Instruct",
    reward_funcs=accuracy_reward,
    train_dataset=dataset,
)
trainer.train()
Exécutez le script à l'aide de la commande suivante :
torchrun --nproc_per_node 8 train_grpo.py
Réparti sur 8 GPU, l'entraînement prend environ 1 jour.

Remarque : Les courbes de récompense ci-dessus ont été générées avec
Qwen/Qwen2-0.5B-Instruct. Les résultats avecQwen/Qwen2.5-0.5B-Instructseront qualitativement similaires.
Explorer plus en profondeur la méthode GRPO
GRPO est un algorithme d'apprentissage en ligne, ce qui signifie qu'il s'améliore de manière itérative en utilisant les données générées par le modèle entraîné lui-même pendant l'entraînement. L'intuition derrière l'objectif de GRPO est de maximiser l'avantage des complétions générées, tout en veillant à ce que le modèle reste proche de la politique de référence. Pour comprendre le fonctionnement de GRPO, il peut être décomposé en quatre étapes principales : génération des complétions, calcul de l'avantage, estimation de la divergence KL et calcul de la perte.
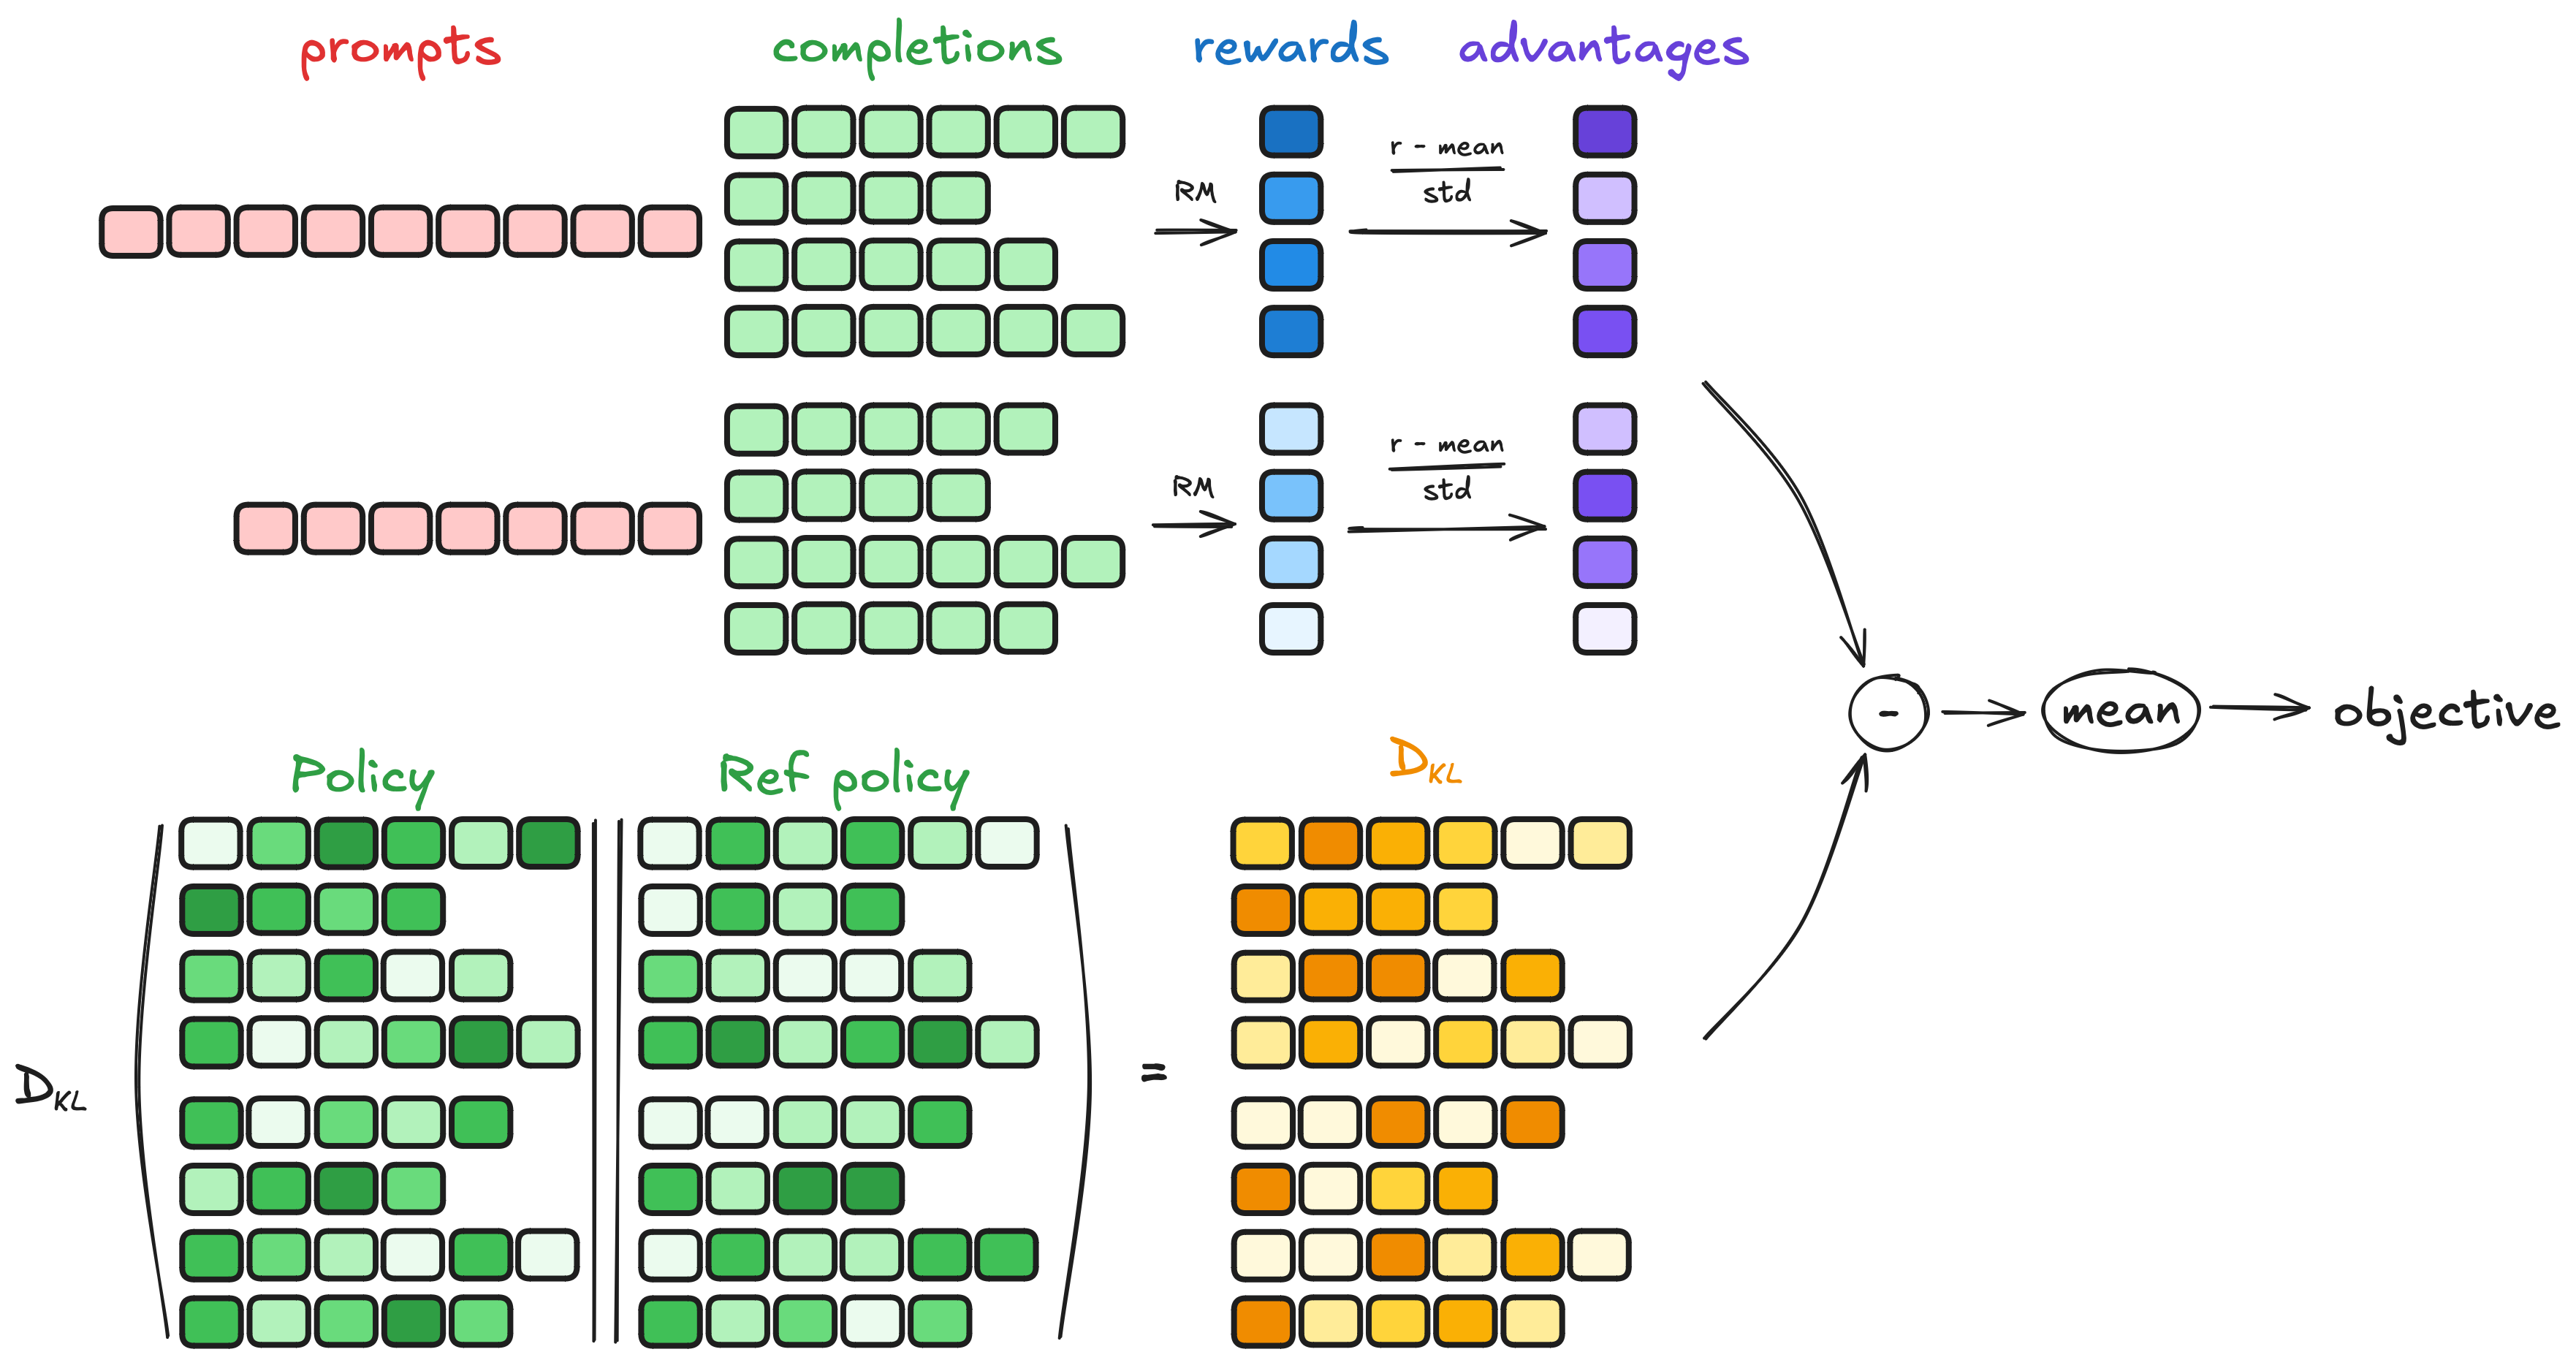
Générer des complétions
À chaque étape d'entraînement, nous échantillonnons un lot de prompts et générons un ensemble de complétions pour chaque prompt (notées ).
Calcul de l'avantage
Pour chacune des séquences, nous calculons la récompense à l'aide d'un modèle de récompense ou d'une fonction de récompense. Pour être cohérent avec la nature comparative des modèles de récompense — généralement entraînés sur des jeux de données de comparaisons entre des sorties pour la même question — l'avantage est calculé pour refléter ces comparaisons relatives. Il est normalisé comme suit :
Cette approche donne son nom à la méthode : Group Relative Policy Optimization (GRPO).
Il a été démontré dans l'article Understanding R1-Zero-Like Training: A Critical Perspective que la mise à l'échelle par peut introduire un biais de difficulté au niveau de la question. Vous pouvez désactiver cette mise à l'échelle en définissant
scale_rewards=Falsedans GRPOConfig. Notez que la désactivation de la mise à l'échelle basée sur std supprime également la normalisation de la variance, de sorte que les amplitudes de mise à jour dépendent directement de l'échelle brute des récompenses et de la composition du lot.
Comme indiqué dans Partie I : Astuces ou pièges ? Analyse approfondie du RL pour le raisonnement des LLM (Lite PPO), le calcul de la moyenne au niveau local (groupe) et de l'écart-type au niveau global (lot) permet un façonnement des récompenses plus robuste. Vous pouvez utiliser cette stratégie de mise à l'échelle en définissant
scale_rewards="batch"dans GRPOConfig.
Estimation de la divergence de KL
La divergence de KL est estimée à l'aide de l'approximateur introduit par Schulman et al. (2020). L'approximateur est défini comme suit :
Calcul de la perte
L'objectif est de maximiser l'avantage tout en veillant à ce que le modèle reste proche de la politique de référence. Par conséquent, la perte est définie comme suit :
où le premier terme représente l'avantage mis à l'échelle et le second terme pénalise les écarts par rapport à la politique de référence par divergence de KL.
Notez que, par rapport à la formulation originale dans DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models, nous n'appliquons pas l'échelle de car il a été démontré dans l'article Understanding R1-Zero-Like Training: A Critical Perspective que cela introduit un biais de longueur au niveau de la réponse. Plus de détails dans les types de perte.
Notez que, par rapport à la formulation originale dans DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models, nous utilisons par défaut, ce qui signifie que le terme de divergence KL n'est pas utilisé. Ce choix est motivé par plusieurs études récentes (par exemple, Open-Reasoner-Zero: An Open Source Approach to Scaling Up Reinforcement Learning on the Base Model) ) qui ont montré que le terme de divergence KL n'est pas essentiel pour l'entraînement avec GRPO. En conséquence, il est devenu courant de l'exclure (par exemple, Understanding R1-Zero-Like Training: A Critical Perspective, DAPO: An Open-Source LLM Reinforcement Learning System at Scale). Si vous souhaitez inclure le terme de divergence KL, vous pouvez définir
betadans GRPOConfig à une valeur non nulle.
Dans l'article original, cette formulation est généralisée pour prendre en compte plusieurs mises à jour après chaque génération (notées , peut être défini avec num_iterations dans GRPOConfig) en exploitant l' objectif de substitution tronqué:
où garantit que les mises à jour ne s'écartent pas excessivement de la politique de référence en bornant le ratio de politique entre et . Lorsque (par défaut dans TRL), l'objectif substitut tronqué se simplifie en l'objectif d'origine.
Types de pertes
Plusieurs formulations de l'objectif ont été proposées dans la littérature. Initialement, l'objectif de GRPO était défini comme suit :
où
Le DAPO paper met en évidence les limites de la perte au niveau de l'échantillon de l'algorithme GRPO dans les scénarios de CoT longs, où les réponses plus longues sont sous-pénalisées, ce qui entraîne des sorties de moindre qualité. La solution proposée est une normalisation au niveau du jeton, qui gère mieux les séquences plus longues en attribuant des récompenses plus équilibrées aux jetons individuels, indépendamment de la longueur de la réponse :
Pour utiliser cette formulation, définissez loss_type="dapo" dans GRPOConfig.
De plus, l'article Understanding R1-Zero-Like Training: A Critical Perspective a démontré que la formulation initiale de GRPO introduit un biais de longueur de réponse. Ils montrent que bien que la formulation DAPO réduise ce biais, elle ne l'élimine pas complètement. Pour éliminer entièrement ce biais, ils proposent de diviser par une constante au lieu de la longueur de la séquence, ce qui donne la formulation suivante :
Cette constante est recommandée comme longueur maximale de complétion. Pour utiliser cette formulation, définissez loss_type="dr_grpo" dans GRPOConfig.
Alternativement, dans l'article SAPO, l'équipe Qwen propose de remplacer le mécanisme de « hard » clipping de GRPO par un mécanisme de soft gating lisse, contrôlé par la température. Alors que GRPO annule les gradients lorsque la politique s'écarte trop de la référence, SAPO utilise une région de confiance douce qui atténue progressivement le poids du gradient. Cela permet au modèle de conserver les signaux d'apprentissage utiles issus des jetons « near-on-policy » tout en supprimant le bruit provenant des écarts extrêmes.
La fonction de perte est définie comme suit :
La fonction de soft-gating est définie à l'aide de la fonction sigmoïde comme suit :
La température est choisie en fonction du signe de l'avantage :
Ils recommandent d'utiliser des températures asymétriques, (les valeurs par défaut sont ). Cela garantit que le modèle est pénalisé plus strictement pour les actions « mauvaises » afin de prévenir l'instabilité, tout en étant plus permissif avec les actions « bonnes ».
Pour utiliser cette formulation, définissez loss_type="sapo" dans GRPOConfig.
Métriques journalisées
Lors de l'entraînement et de l'évaluation, nous enregistrons les métriques suivantes :
num_tokens: le nombre total de jetons traités jusqu'à présent, incluant à la fois les invites et les complétions. Lors de l'utilisation d'outils, seuls les jetons non liés aux outils sont comptés.step_time: le temps moyen (en secondes) par étape d'entraînement (génération incluse).completions/mean_length: La longueur moyenne des complétions générées. Lors de l'utilisation d'outils, seuls les jetons non-outils sont comptés.completions/min_length: La longueur minimale des complétions générées. Lors de l'utilisation d'outils, seuls les jetons non-outils sont comptés.completions/max_length: La longueur maximale des complétions générées. Lors de l'utilisation d'outils, seuls les jetons non-outils sont comptés.completions/mean_terminated_length: La longueur moyenne des complétions générées qui se terminent par EOS. Lors de l'utilisation d'outils, seuls les jetons non-outils sont comptés.completions/min_terminated_length: La longueur minimale des complétions générées qui se terminent par EOS. Lors de l'utilisation d'outils, seuls les jetons non-outils sont comptés.completions/max_terminated_length: La longueur maximale des complétions générées qui se terminent par EOS. Lors de l'utilisation d'outils, seuls les jetons non-outils sont comptés.completions/clipped_ratio: Le ratio des complétions tronquées (clippées).tools/call_frequency: nombre moyen d'appels d'outils par complétion dans le lot de génération. Journalisé uniquement lorsque destoolssont fournis.tools/failure_frequency: La proportion d'appels d'outils qui ont échoué (l'outil n'a pas été trouvé, a levé une exception, ou le type d'appel n'est pas pris en charge). Elle est0.0lorsqu'aucun outil n'a été appelé. Journalisé uniquement lorsque destoolssont fournis.rewards/{reward_func_name}/mean: la récompense moyenne issue d’une fonction de récompense spécifique. Lorsqu’un environnement possède la récompense viaget_reward,{reward_func_name}est le nom de la classe de l’environnement.rewards/{reward_func_name}/std: l'écart-type de la récompense issue d'une fonction de récompense spécifique.reward: La récompense moyenne globale après avoir additionné les récompenses sur l'ensemble des fonctions (pondérées parreward_weights).reward_std: l'écart-type des récompenses cumulées sur l'ensemble des fonctions (pondérées parreward_weights), calculé sur le lot complet.frac_reward_zero_std: La proportion d'échantillons du lot de génération dont l'écart-type de la récompense est nul, ce qui implique qu'il y a peu de diversité pour ce prompt (toutes les réponses sont correctes ou incorrectes).sampling/sampling_logp_difference/mean: Différence absolue moyenne entre les probabilités logarithmiques renvoyées par le module d'échantillonnage (vLLM) et celles recalculées par le modèle d'entraînement, sur les jetons de complétion. Une valeur croissante indique un écart croissant entre l'entraînement et l'inférence. Journalisé uniquement lorsqueuse_vllm=Trueetvllm_importance_sampling_correction=True.sampling/sampling_logp_difference/max: La plus grande différence absolue de ce type. Journalisé uniquement lorsqueuse_vllm=Trueetvllm_importance_sampling_correction=True.sampling/importance_sampling_ratio/min: le plus petit ratio d’échantillonnage d’importance utilisé pour corriger l’écart entre l’entraînement et l’inférence, après l’application de la contrainte sélectionnée parvllm_importance_sampling_mode(borné à[C_min, C_max]pour les modes*_truncate, mis à zéro pour les modes*_mask). Calculé sur les jetons de complétion, ou sur les séquences pour les modessequence_*. Journalisé uniquement lorsqueuse_vllm=Trueetvllm_importance_sampling_correction=True.sampling/importance_sampling_ratio/mean: le ratio moyen d'échantillonnage d'importance contraint. Journalisé uniquement lorsqueuse_vllm=Trueetvllm_importance_sampling_correction=True.sampling/importance_sampling_ratio/max: le plus grand ratio d'échantillonnage d'importance contraint. Journalisé uniquement lorsqueuse_vllm=Trueetvllm_importance_sampling_correction=True.policy_loss: valeur de la perte de gradient de politique (avant tout bonus d'entropie). Enregistrée lorsqueentropy_coefest non nul ouuse_adaptive_entropy=True.entropy: Entropie moyenne des prédictions de jetons sur l’ensemble des complétions générées. (Simask_truncated_completions=True, les jetons des séquences masquées sont exclus.)entropy_coef: le coefficient de régularisation par entropie actuel. Journalisé lorsqueentropy_coefest non nul ouuse_adaptive_entropy=True. Mis à jour une fois par étape de l’optimiseur lorsqueuse_adaptive_entropy=True.aux_loss: perte auxiliaire d'équilibrage de charge d'un modèle Mixture-of-Experts, avant d'être mise à l'échelle parrouter_aux_loss_coefet ajoutée à la perte. Journalisée uniquement lorsque le modèle est un modèle MoE et querouter_aux_loss_coefest non nul.kl: divergence KL moyenne entre le modèle et le modèle de référence, calculée sur les complétions générées. Journalisé uniquement sibetaest non nul.clip_ratio/region_mean: Le ratio de probabilités de jeton (ou de séquence, siimportance_sampling_level="sequence") ) où l'objectif GRPO est tronqué pour rester dans la région de confiance : . Une valeur plus élevée signifie que plus de jetons sont tronqués, ce qui limite l'ampleur des modifications de la politique .clip_ratio/low_mean: Le ratio moyen des probabilités de jeton (ou de séquence, siimportance_sampling_level="sequence") ) qui ont été rognées sur la borne inférieure de la région de confiance : .clip_ratio/low_min: La plus petite fraction de jetons par complétion (ou de la séquence elle-même, siimportance_sampling_level="sequence") est rognée sur la borne inférieure de la région de confiance : .clip_ratio/high_mean: Le ratio moyen des probabilités de jeton (ou de séquence, siimportance_sampling_level="sequence") ) qui ont été rognées sur la borne supérieure de la région de confiance : .clip_ratio/high_max: La plus grande fraction de jetons par complétion (ou la séquence elle-même, siimportance_sampling_level="sequence") est rognée sur la borne supérieure de la région de confiance : .cispo_clip_ratio: Le ratio de poids d'échantillonnage par importance de jeton (ou de séquence, siimportance_sampling_level="sequence") ) qui ont été rognés àepsilon_hightout en ayant un avantage positif : . Journalisé uniquement lorsqueloss_type="cispo".vespo/phi_seq_mean: La valeur moyenne du pondération Gamma de VESPO appliquée aux poids d'importance au niveau de la séquence. Les valeurs inférieures à1.0indiquent que les séquences sont sous-pondérées. Journalisé uniquement lorsqueloss_type="vespo".
Personnalisation
Accélérer l'entraînement avec la génération propulsée par vLLM
La génération est souvent le principal goulot d'étranglement lors de l'entraînement avec des méthodes en ligne. Pour accélérer la génération, vous pouvez utiliser vLLM, un moteur d'inférence à haut débit et faible latence pour les LLM. Pour l'activer, installez d'abord le package avec
pip install trl[vllm]
Nous prenons en charge deux façons d'utiliser vLLM pendant l'entraînement : le mode serveur et le mode colocalisé.
Par défaut, l'échantillonnage d'importance masqué au niveau de la séquence (
vllm_importance_sampling_mode="sequence_mask") est activé pour la génération vLLM afin de remédier au décalage entre la génération et l'entraînement qui survient lors de l'utilisation de frameworks différents. Cette fonction peut être désactivée en définissantvllm_importance_sampling_correction=False. Pour plus d'informations, consultez Masked Importance Sampling et Sequence-level Importance Sampling
Option 1 : Mode Colocate
Dans ce mode, vLLM s’exécute dans le processus d’entraînement et partage la mémoire GPU avec le modèle d’entraînement. Cela évite de démarrer un serveur séparé et peut améliorer l’utilisation des GPU, mais peut entraîner une concurrence mémoire sur les GPU d’entraînement. C’est le mode par défaut.
from trl import GRPOConfig

training_args = GRPOConfig(
    ...,
    use_vllm=True,  # vllm_mode="colocate" by default
)
Option 2 : Mode serveur
Dans ce mode, vLLM s’exécute dans un processus distinct (et utilise des GPU séparés) et communique avec l’entraîneur via HTTP. C’est idéal si vous disposez de GPU dédiés à l’inférence.
Démarrer le serveur vLLM :
VLLM_SERVER_DEV_MODE=1 vllm serve <model_name> \
    --weight-transfer-config '{"backend": "nccl"}' \
    --logprobs-mode processed_logprobs \
    --max-logprobs -1
Activer le mode serveur dans votre script d’entraînement :
from trl import GRPOConfig

training_args = GRPOConfig(
    ...,
    use_vllm=True,
    vllm_mode="server",
)
Assurez-vous que le serveur utilise des GPU différents de ceux du formateur, sinon vous risquez de rencontrer des erreurs NCCL. Vous pouvez spécifier les GPU à utiliser avec la variable d’environnement
CUDA_VISIBLE_DEVICES.
En fonction de la taille du modèle et des besoins globaux en mémoire GPU pour l’entraînement, vous devrez peut-être ajuster le paramètre
vllm_gpu_memory_utilizationdans GRPOConfig afin d’éviter une sous-utilisation ou des erreurs de mémoire insuffisante.Nous mettons à disposition un HF Space pour vous aider à estimer l'utilisation recommandée de la mémoire GPU en fonction de la configuration de votre modèle et des paramètres de votre expérience. Utilisez-le simplement comme suit pour obtenir la recommandation de
vllm_gpu_memory_utilization:Si la valeur recommandée ne fonctionne pas dans votre environnement, nous suggérons d'ajouter une petite marge (par exemple, +0.05 ou +0.1) à la valeur recommandée pour garantir la stabilité.
Si vous rencontrez toujours des erreurs de mémoire insuffisante, définissez
vllm_enable_sleep_modesur True et les paramètres vllm ainsi que le cache seront déchargés pendant l'étape d'optimisation. Pour plus d'informations, consultez Réduire l'utilisation de la mémoire avec le mode veille de vLLM.
Par défaut, GRPO utilise
MASTER_ADDR=localhostetMASTER_PORT=12345pour vLLM, mais vous pouvez remplacer ces valeurs en définissant les variables d’environnement en conséquence.
Pour plus d'informations, consultez Accélérer l'entraînement avec vLLM.
Gérer le décalage entre l’entraînement et l’inférence
Bien que vLLM accélère considérablement l'inférence, il découple également le moteur d'inférence du moteur d'entraînement. En théorie, ces moteurs sont mathématiquement identiques, mais en pratique, ils peuvent produire des sorties différentes en raison des effets de précision et des optimisations spécifiques au matériel. Cette divergence reflète les objectifs d'optimisation distincts des deux systèmes. Les moteurs d'inférence visent à maximiser le débit d'échantillonnage, généralement mesuré en jetons par seconde, tout en maintenant une fidélité d'échantillonnage acceptable. Les cadres d'entraînement, en revanche, se concentrent sur la stabilité numérique et la précision pour le calcul des gradients, en utilisant souvent des formats de précision plus élevés comme FP32 pour les poids maîtres et les états de l'optimiseur. Ces priorités et contraintes différentes introduisent un décalage inévitable, bien que subtil, entre l'entraînement et l'inférence.
Cette incohérence entraîne une mise à jour du gradient biaisée, qui a été observée pour déstabiliser l'entraînement ([1][2][3][4][5]). Pour simplifier, considérons le gradient de politique REINFORCE :
Ici désigne des prompts échantillonnés à partir d'une certaine distribution de données, et est la politique implémentée par le moteur d'entraînement. Avec vLLM dans la boucle, nous obtenons une politique d'inférence distincte , de sorte que le gradient de politique effectif devient
Cela transforme un problème de RL qui serait autrement on policy en un problème off policy.
La méthode standard pour corriger ce décalage de distribution est l'échantillonnage par importance (IS). Nous proposons deux variantes d'IS : l'échantillonnage par importance tronqué (TIS) et l'échantillonnage par importance masqué (MIS). Les deux variantes peuvent être appliquées au niveau du jeton ou au niveau de la séquence. Soit le poids d'importance, par exemple par jeton ou par séquence. Dans le cas de TIS, les ratios hors de l'intervalle [vllm_importance_sampling_clip_min, vllm_importance_sampling_clip_max] sont tronqués,
L'article TIS proposait un mécanisme de rognage à borne supérieure unique, c'est-à-dire . L'implémentation dans TRL a généralisé cela en introduisant également une borne inférieure, aboutissant à la formulation à double limite ci-dessus, inspirée de la méthode IcePop .
Notez que dans IcePop, les bornes sont désignées par et tandis que dans TRL, nous utilisons et .
Sous MIS, les ratios en dehors de cette plage sont mis à zéro, de sorte que ces échantillons ne contribuent pas au gradient. Autrement dit, les échantillons aberrants sont pondérés à la baisse sous TIS et écartés sous MIS. Le drapeau de configuration vllm_importance_sampling_mode sélectionne à la fois la variante de l'échantillonnage d'importance (masquage ou troncature) et la granularité (niveau jeton ou niveau séquence).
L'échantillonnage d'importance est la réponse algorithmique fondée sur des principes au décalage entre l'entraînement et l'inférence. Toutefois, il existe également des approches plus directes qui tentent de réduire le décalage entre les deux moteurs eux-mêmes. La plupart de ces solutions sont d'ordre technique. Par exemple, MiniMax M1 utilise une tête de modèle de langage en FP32 dans le moteur d'inférence. Thinking Machines a exploré les noyaux d'inférence déterministes, bien que cela entraîne un coût d'efficacité important. vLLM a démontré des politiques cohérentes au bit près en s'appuyant sur les noyaux déterministes invariants par lot de Thinking Machines, mais à novembre 2025, un pénalité de débit substantielle persiste par rapport à l'inférence vLLM standard.
Accélérer l'entraînement avec le lotissement continu de transformers
En alternative à vLLM, vous pouvez utiliser le moteur de batch continu intégré à transformers pour une génération plus rapide. Le batch continu retire immédiatement les séquences terminées du lot, au lieu d’attendre que la plus lente soit achevée. Pour les tâches dont la longueur de complétion varie (par exemple, le raisonnement mathématique), cela offre une génération plus rapide et une consommation de VRAM plus faible que la fonction generate() par défaut pour de grandes tailles de lot (N≥32).
Le batch continu est une amélioration intégrée sans configuration de serveur ni synchronisation des poids. Il s’exécute dans le processus et convient bien à l’entraînement sur un seul GPU ou aux environnements à mémoire limitée. Pour un débit de génération maximal à grande échelle, utilisez vLLM à la place.
from trl import GRPOConfig

training_args = GRPOConfig(
    ...,
    use_transformers_continuous_batching=True,
    transformers_continuous_batching_config={
        "use_cuda_graph": False,
        "max_memory_percent": 0.4,  # lower values leave more VRAM for the training backward pass
    },
)
TRL définit
max_memory_percentpar défaut à0.5(au lieu de0.9pour transformers) afin de laisser suffisamment de VRAM pour la passe arrière d’entraînement. Réduisez cette valeur à0.3–0.4pour les lots de génération volumineux (N≥32) ou en cas d’erreurs de mémoire insuffisante.
Pour un exemple complet d’entraînement, voir examples/grpo_continuous_batching/grpo_continuous_batching.py.
GRPO à grande échelle : entraîner un modèle de 70B+ sur plusieurs nœuds
Lors de l'entraînement de grands modèles comme Qwen2.5-72B, plusieurs optimisations clés sont nécessaires pour rendre l'entraînement efficace et scalable sur plusieurs GPU et nœuds. Elles incluent :
- DeepSpeed ZeRO Stage 3 : ZeRO exploite le parallélisme de données pour distribuer les états du modèle (poids, gradients, états de l’optimiseur) sur plusieurs GPU et CPU, réduisant ainsi les besoins en mémoire et en calcul sur chaque appareil. Comme les grands modèles ne peuvent pas tenir sur un seul GPU, l’utilisation de ZeRO Stage 3 est requise pour entraîner ce type de modèles. Pour plus de détails, voir DeepSpeed Integration.
- torchrun : le lanceur de PyTorch démarre un processus par GPU sur chaque nœud et les connecte via un point de rendez-vous commun. Pour plus de détails, voir Distributing Training.
- vLLM : Reportez-vous à la section précédente pour savoir comment utiliser vLLM afin d’accélérer la génération.
Voici un exemple de script SLURM pour entraîner un modèle de 70B avec GRPO sur plusieurs nœuds. Ce script entraîne un modèle sur 4 nœuds et utilise le 5e nœud pour la génération propulsée par vLLM.
#!/bin/bash
#SBATCH --nodes=5
#SBATCH --gres=gpu:8

# Get the list of allocated nodes
NODELIST=($(scontrol show hostnames $SLURM_JOB_NODELIST))

# Assign the first 4 nodes for training and the 5th node for vLLM
TRAIN_NODES="${NODELIST[@]:0:4}"  # Nodes 0, 1, 2, 3 for training
VLLM_NODE="${NODELIST[4]}"  # Node 4 for vLLM

# Run training on the first 4 nodes (Group 1)
srun --nodes=4 --ntasks=4 --nodelist="${NODELIST[@]:0:4}" torchrun \
     --nnodes 4 \
     --nproc_per_node 8 \
     --node_rank $SLURM_PROCID \
     --rdzv_backend c10d \
     --rdzv_endpoint ${NODELIST[0]}:29500 \
     train_grpo.py \
     --server_ip $VLLM_NODE &

# Run vLLM server on the 5th node (Group 2)
srun --nodes=1 --ntasks=1 --nodelist="${NODELIST[4]}" env VLLM_SERVER_DEV_MODE=1 vllm serve Qwen/Qwen2.5-72B --tensor-parallel-size 8 \
    --weight-transfer-config '{"backend": "nccl"}' \
    --logprobs-mode processed_logprobs \
    --max-logprobs -1 &

waitimport argparse
from datasets import load_dataset
from trl import GRPOTrainer, GRPOConfig
from trl.rewards import accuracy_reward
def main():
parser = argparse.ArgumentParser()
parser.add_argument("--vllm_server_host", type=str, default="", help="The server IP")
args = parser.parse_args()
dataset = load_dataset("trl-lib/DeepMath-103K", split="train")
training_args = GRPOConfig(
per_device_train_batch_size=4,
deepspeed="examples/deepspeed_configs/zero3.json",
use_vllm=True,
vllm_mode="server",
vllm_server_host=args.vllm_server_host.replace("ip-", "").replace("-", "."), # from ip-X-X-X-X to X.X.X.X
)
trainer = GRPOTrainer(
model="Qwen/Qwen2.5-72B",
args=training_args,
reward_funcs=accuracy_reward,
train_dataset=dataset
)
trainer.train()
if __name__=="__main__":
main()Utiliser une fonction de récompense personnalisée
Le GRPOTrainer prend en charge l'utilisation de fonctions de récompense personnalisées à la place des modèles de récompense denses. Pour garantir la compatibilité, votre fonction de récompense doit satisfaire aux exigences suivantes :
Les fonctions de récompense peuvent être des fonctions Python synchrones ou des coroutines asynchrones async def. Lorsque vous fournissez plusieurs fonctions de récompense asynchrones, elles sont attendues de manière concurrente (exécutées en parallèle via asyncio.gather) afin que leur latence se superpose.
Arguments d'entrée :
La fonction doit accepter les éléments suivants en tant qu'arguments nommés :
prompts(contient les prompts),completions(contient les complétions générées),completion_ids(contient les complétions tokenisées),trainer_state(TrainerState) : l'état actuel du formateur. Il peut être utilisé pour implémenter des fonctions de récompense dynamiques, comme l'apprentissage par curriculum, où la récompense est ajustée en fonction de la progression de l'entraînement.log_extra: un appelablelog_extra(column: str, values: list)pour ajouter des colonnes supplémentaires au tableau des complétions. Voir l’exemple 6.log_metric: un appelablelog_metric(name: str, value: float)pour journaliser des métriques scalaires sous forme de graphiques aux côtés dekl,entropy, etc. Voir l’exemple 6.environments: une liste d’instances d’environnement, une par complétion. Présente uniquement lorsqueenvironment_factoryest fourni. Utilisez-la pour lire l’état accumulé pendant l’épisode (par ex.env.counter). Pour les environnements à état, préférez de laisser l’environnement posséder la récompense via une méthodeget_reward— voir Récompenses.- Tous les noms de colonnes (sauf
prompt) que le jeu de données peut contenir. Par exemple, si le jeu de données contient une colonne nomméeground_truth, la fonction sera appelée avecground_truthen tant qu'argument par mot-clé.
La façon la plus simple de respecter cette exigence est d'utiliser
**kwargsdans la signature de la fonction.Selon le format du jeu de données, l'entrée variera :
- Pour le format standard,
promptsetcompletionsseront des listes de chaînes de caractères. - Pour le format conversationnel,
promptsetcompletionsseront des listes de dictionnaires de messages.
- Pour le format standard,
Valeur de retour : La fonction doit retourner une liste de flottants. Chaque flottant représente la récompense correspondant à une seule complétion.
Exemple 1 : Récompenser les complétions plus longues
Voici un exemple de fonction de récompense pour un format standard qui récompense les complétions plus longues :
def reward_func(completion_ids, **kwargs):
    """Reward function that assigns higher scores to longer completions (in terms of token count)."""
    return [float(len(ids)) for ids in completion_ids]
Vous pouvez le tester comme suit :
>>> prompts = ["The sky is", "The sun is"]  # not used in the reward function, but the trainer will pass it
>>> completions = [" blue.", " in the sky."]  # not used in the reward function, but the trainer will pass it
>>> completion_ids = [[6303, 13], [304, 279, 12884, 13]]
>>> reward_func(prompts=prompts, completions=completions, completion_ids=completion_ids)
[2.0, 4.0]
Exemple 1.1 : Récompenser les complétions plus longues (en fonction du nombre de caractères)
Identique à l'exemple précédent, mais cette fois la fonction de récompense est basée sur le nombre de caractères plutôt que sur les jetons.
def reward_func(completions, **kwargs):
    """Reward function that assigns higher scores to longer completions (in terms of character count)."""
    return [float(len(completion)) for completion in completions]
Vous pouvez le tester comme suit :
>>> prompts = ["The sky is", "The sun is"]
>>> completions = [" blue.", " in the sky."]
>>> completion_ids = [[6303, 13], [304, 279, 12884, 13]]  # not used in the reward function, but the trainer will pass it
>>> reward_func(prompts=prompts, completions=completions, completion_ids=completion_ids)
[6.0, 12.0]
Exemple 2 : Récompenser les complétions avec un format spécifique
Voici un exemple de fonction de récompense qui vérifie si l’achèvement respecte un format spécifique. Cet exemple s’inspire de la fonction format reward utilisée dans l’article DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. Elle est conçue pour un format conversationnel, où les invites et les achèvements sont constitués de messages structurés.
import re

def format_reward_func(completions, **kwargs):
    """Reward function that checks if the completion has a specific format."""
    pattern = r"^<think>.*?</think><answer>.*?</answer>$"
    completion_contents = [completion[0]["content"] for completion in completions]
    matches = [re.match(pattern, content) for content in completion_contents]
    return [1.0 if match else 0.0 for match in matches]
Vous pouvez tester cette fonction comme suit :
>>> prompts = [
...     [{"role": "user", "content": "What is the result of (1 + 2) * 4?"}],
...     [{"role": "user", "content": "What is the result of (3 + 1) * 2?"}],
... ]
>>> completions = [
...     [{"role": "assistant", "content": "<think>The sum of 1 and 2 is 3, which we multiply by 4 to get 12.</think><answer>(1 + 2) * 4 = 12</answer>"}],
...     [{"role": "assistant", "content": "The sum of 3 and 1 is 4, which we multiply by 2 to get 8. So (3 + 1) * 2 = 8."}],
... ]
>>> format_reward_func(prompts=prompts, completions=completions)
[1.0, 0.0]
Exemple 3 : Récompenser les complétions sur la base d'une référence
Voici un exemple de fonction de récompense qui vérifie si la complétion est correcte. Cet exemple s’inspire de la fonction accuracy reward utilisée dans l’article DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning.
Cet exemple est conçu pour le format standard, où le jeu de données contient une colonne nommée ground_truth.
import re

def reward_func(completions, ground_truth, **kwargs):
    # Regular expression to capture content inside \boxed{}
    matches = [re.search(r"\\boxed\{(.*?)\}", completion) for completion in completions]
    contents = [match.group(1) if match else "" for match in matches]
    # Reward 1 if the content is the same as the ground truth, 0 otherwise
    return [1.0 if c == gt else 0.0 for c, gt in zip(contents, ground_truth)]
Vous pouvez tester cette fonction comme suit :
>>> prompts = ["Problem: Solve the equation $2x + 3 = 7$. Solution:", "Problem: Solve the equation $3x - 5 = 10$."]
>>> completions = [r" The solution is \boxed{2}.", r" The solution is \boxed{6}."]
>>> ground_truth = ["2", "5"]
>>> reward_func(prompts=prompts, completions=completions, ground_truth=ground_truth)
[1.0, 0.0]
Exemple 4 : Fonctions de récompense multi-tâches
Voici un exemple d'utilisation de plusieurs fonctions de récompense dans le GRPOTrainer. Dans cet exemple, nous définissons deux fonctions de récompense spécifiques à la tâche : math_reward_func et coding_reward_func. La fonction math_reward_func attribue une récompense aux problèmes de mathématiques en fonction de leur exactitude, tandis que la fonction coding_reward_func attribue une récompense aux problèmes de codage en fonction du fait que la solution fonctionne.
from datasets import Dataset
from trl import GRPOTrainer

# Define a dataset that contains both math and coding problems
dataset = Dataset.from_list(
    [
        {"prompt": "What is 2+2?", "task": "math"},
        {"prompt": "Write a function that returns the sum of two numbers.", "task": "code"},
        {"prompt": "What is 3*4?", "task": "math"},
        {"prompt": "Write a function that returns the product of two numbers.", "task": "code"},
    ]
)

# Math-specific reward function
def math_reward_func(prompts, completions, task, **kwargs):
    rewards = []
    for prompt, completion, t in zip(prompts, completions, task):
        if t == "math":
            # Calculate math-specific reward
            correct = check_math_solution(prompt, completion)
            reward = 1.0 if correct else -1.0
            rewards.append(reward)
        else:
            # Return None for non-math tasks
            rewards.append(None)
    return rewards

# Coding-specific reward function
def coding_reward_func(prompts, completions, task, **kwargs):
    rewards = []
    for prompt, completion, t in zip(prompts, completions, task):
        if t == "code":
            # Calculate coding-specific reward
            works = test_code_solution(prompt, completion)
            reward = 1.0 if works else -1.0
            rewards.append(reward)
        else:
            # Return None for non-coding tasks
            rewards.append(None)
    return rewards

# Use both task-specific reward functions
trainer = GRPOTrainer(
    model="Qwen/Qwen2.5-0.5B-Instruct",
    reward_funcs=[math_reward_func, coding_reward_func],
    train_dataset=dataset,
)

trainer.train()
Dans cet exemple, math_reward_func et coding_reward_func sont conçus pour fonctionner avec un jeu de données mixte contenant à la fois des problèmes de mathématiques et de codage. La colonne task du jeu de données est utilisée pour déterminer quelle fonction de récompense appliquer à chaque problème. S'il n'existe pas de fonction de récompense pertinente pour un échantillon du jeu de données, la fonction de récompense renvoie None, et le GRPOTrainer poursuit avec les fonctions et tâches valides. Cela permet au GRPOTrainer de gérer plusieurs fonctions de récompense avec des domaines d'application différents.
Notez que le GRPOTrainer ignore les récompenses None renvoyées par les fonctions de récompense et ne prend en compte que les récompenses renvoyées par les fonctions pertinentes. Cela garantit que le modèle est entraîné sur les tâches pertinentes et ignore celles pour lesquelles il n’existe pas de fonction de récompense appropriée.
Exemple 5 : Fonctions de récompense asynchrones
Les fonctions de récompense personnalisées peuvent également être définies sous forme de coroutines async def. Cela est utile si votre récompense dépend d'une E/S lente (par exemple, l'appel d'un service distant). Lorsque vous transmettez plusieurs fonctions de récompense asynchrones, GRPOTrainer les exécute de manière concurrente afin que leur latence se superpose.
Voici un exemple minimal d'une fonction de récompense asynchrone qui simule une opération limitée par l'E/S :
import asyncio

async def async_reward_func(prompts, completions, **kwargs):
    # Simulate an I/O-bound call (e.g., HTTP request, database lookup)
    await asyncio.sleep(0.01)
    # Simple toy reward: 1.0 if the completion is non-empty, else 0.0
    return [1.0 if completion else 0.0 for completion in completions]
Exemple 6 : Journalisation de colonnes et de métriques supplémentaires
Voici un exemple de fonction de récompense qui journalise des colonnes supplémentaires dans le tableau des complétions et des métriques scalaires sous forme de graphiques.
import re

def reward_func(completions, ground_truth, log_extra=None, log_metric=None, **kwargs):
    extracted = [re.search(r"\\boxed\{(.*?)\}", c) for c in completions]
    extracted = [m.group(1) if m else None for m in extracted]
    rewards = [1.0 if e == gt else 0.0 for e, gt in zip(extracted, ground_truth)]

    if log_extra:
        log_extra("golden_answer", list(ground_truth))
        log_extra("extracted_answer", [e or "[none]" for e in extracted])

    if log_metric:
        log_metric("accuracy", sum(rewards) / len(rewards))

    return rewards
Passer la fonction de récompense à l'entraîneur
Pour utiliser votre fonction de récompense personnalisée, transmettez-la à GRPOTrainer comme suit :
from trl import GRPOTrainer

trainer = GRPOTrainer(
    reward_funcs=reward_func,
    ...,
)
Vous pouvez passer plusieurs fonctions de récompense sous forme de liste ; cette liste peut inclure à la fois des fonctions synchrones et asynchrones :
from trl import GRPOTrainer

trainer = GRPOTrainer(
    reward_funcs=[reward_func, async_reward_func1, async_reward_func2],
    ...,
)
et la récompense sera calculée comme la somme des récompenses de chaque fonction, ou comme la somme pondérée si reward_weights est fourni dans la configuration.
Notez que GRPOTrainer prend en charge plusieurs fonctions de récompense de types différents. Consultez la documentation des paramètres pour plus de détails.
Régularisation par entropie
Pour encourager l'exploration et empêcher la politique de converger vers des sorties quasi déterministes, vous pouvez ajouter un bonus d'entropie à l'objectif d'entraînement. La régularisation par entropie modifie la perte GRPO comme suit :
où est l'entropie moyenne par jeton de la politique et est le coefficient d'entropie. La prime est toujours l'entropie moyenne par jeton, indépendamment de loss_type; elle n'est pas rééchelonnée pour correspondre à la normalisation de la politique d'un type de perte (par exemple le dénominateur batch_size * max_completion_length de Dr. GRPO), donc entropy_coef a la même signification pour tous les types de perte.
Entropie statique — un coefficient fixe tout au long de l’entraînement :
from trl import GRPOConfig, GRPOTrainer

training_args = GRPOConfig(entropy_coef=0.05, ...)
Entropie adaptative — le coefficient est mis à jour à chaque étape de l’optimiseur en fonction d’une entropie cible, comme introduit dans Skywork-OR1. Lorsque l’entropie actuelle est inférieure ou égale à entropy_target, le coefficient est incrémenté de entropy_coef_delta ; sinon, il est décrémenté. Le coefficient n’est appliqué (c’est-à-dire non nul) que lorsque l’entropie est inférieure ou égale à la cible :
training_args = GRPOConfig(
    entropy_coef=0.01,          # initial coefficient
    use_adaptive_entropy=True,
    entropy_target=5.0,         # target mean per-token entropy (nats); tune for your model
    entropy_coef_delta=0.005,   # step size per optimizer step
    entropy_coef_min=0.0,
    entropy_coef_max=1.0,
    ...
)
Les modèles de langage typiques présentent des entropies par jeton comprises entre 2 et 10 nats, de sorte que la valeur par défaut
entropy_target=0.2déclenche presque jamais la régularisation — la prime n’est activée que lorsque l’entropie est inférieure ou égale à la cible, c’est-à-dire en cas d’effondrement quasi total. Réglez-la sur une valeur pertinente pour votre modèle, par exemple proche de l’entropie observée en début d’entraînement (journalisée sous la métriqueentropy). Lorsque vous utiliseztop_entropy_quantile < 1.0,entropy_targets’applique au sous-ensemble de jetons à haute entropie — l’entropie de ce sous-ensemble sera supérieure à l’entropie complète des jetons journalisée (entropy), il convient donc de calibrer en conséquence.
Lorsque use_adaptive_entropy=True, le coefficient d'entropie actuel entropy_coef est enregistré avec chaque point de contrôle et restauré lors de la reprise, ce qui permet une reprise complète de l'entraînement.
Expérimentation rapide pour GRPO
RapidFire AI est un moteur d’expérimentation open source qui s’appuie sur TRL et vous permet de lancer plusieurs configurations GRPO simultanément, même sur un seul GPU. Plutôt que d’essayer les configurations séquentiellement, RapidFire vous permet de visualiser plus tôt toutes leurs courbes d’apprentissage, d’arrêter les exécutions sous-performantes et de cloner les prometteuses avec de nouveaux paramètres en cours d’exécution sans redémarrage. Pour plus d’informations, consultez Intégration RapidFire AI.
Entraînement des agents
GRPO prend en charge l'entraînement d'agents : le modèle appelle des outils pendant la génération et apprend à partir du résultat.
- Un outil est une fonction Python simple (synchrone ou asynchrone) exposée au modèle. Utilisez
toolspour les appels sans état (une calculatrice, une recherche web). - Un environnement est la forme plus générale : un objet avec état, créé à neuf pour chaque déroulement, dont les méthodes publiques sont exposées en tant qu’outils, accompagné d’un hook de cycle de vie
resetet d’une méthode optionnelleget_rewardqui lui permet de gérer la récompense. Utilisezenvironment_factorylorsque vous avez besoin d’un état par déroulement, d’un hook de réinitialisation ou d’une récompense gérée par l’environnement.
Ils se composent — vous pouvez passer des tools autonomes aux côtés d'une environment_factory.
Outils
L'argument tools attend une liste de fonctions Python (synchrone ou asynchrone) qui définissent les outils disponibles pour l'agent :
from trl import GRPOTrainer

trainer = GRPOTrainer(
    tools=[tool1, tool2],
    ...,
)
Chaque outil doit être une fonction Python standard avec des arguments et types de retour annotés, accompagnée d'une docstring au style Google décrivant son objectif, ses arguments et sa valeur de retour. Pour plus de détails, consultez le guide sur la transmission d'outils.
La boucle d’appel d’outils GRPO exige que le modèle de chat soit préfixe-préservant (l’ajout d’un message d’outil ne doit pas modifier le rendu des messages précédents). Pour les familles de modèles connues (par ex. Qwen3, DeepSeek-V3), TRL remplace automatiquement le modèle d’entraînement par un modèle corrigé lorsque les outils sont activés. Consultez Chat Templates pour la liste complète.
Utilisez max_tool_calling_iterations dans GRPOConfig pour limiter le nombre de tours d’appel d’outils. Par défaut, il n’y a pas de limite, et la génération s’arrête lorsque le modèle produit un tour de réponse sans appel d’outils, lorsque la complétion (tous les tours et résultats d’outils) atteint max_completion_length jetons, ou lorsque la séquence complète atteint la longueur maximale du modèle (vllm_max_model_length avec vllm_mode="colocate", sinon max_position_embeddings du modèle).
Exemple :
from trl import GRPOTrainer

def multiply(a: int, b: int) -> int:
    """
    Multiplies two integers.

    Args:
        a: The first integer.
        b: The second integer.

    Returns:
        The product of the two integers.
    """
    return a * b

async def async_add(a: int, b: int) -> int:
    """
    Asynchronously adds two integers.

    Args:
        a: The first integer.
        b: The second integer.

    Returns:
        The sum of the two integers.
    """
    return a + b

trainer = GRPOTrainer(
    tools=[multiply, async_add],
    ...,
)
Environnements
Vous pouvez également fournir des outils via environment_factory. Dans ce mode, GRPOTrainer crée une instance d’environnement par rollout et expose les méthodes publiques de l’environnement en tant qu’outils.
environment_factorynécessitetransformers>=5.2.0.
Lorsque vous utilisez une environment_factory, l'environnement possède les données : il n'y a pas de train_dataset externe. À chaque rollout, reset() génère la tâche — par auto-échantillonnage à partir d'un corpus détenu par l'environnement, ou en générant un état de manière procédurale — et renvoie le prompt. max_steps définit la durée de l'entraînement. Voici un exemple minimal d'un environnement qui s'auto-échantillonne une cible et expose une méthode increment (exposée en tant qu'outil).
import random

from trl import GRPOConfig, GRPOTrainer

class IncrementEnv:
    # Reserved methods
    def reset(self, **kwargs) -> str | None:  # required; called at the start of each rollout
        self.counter = 0
        self.target = random.randint(1, 6)  # self-sample the task
        return f"Increment the counter by {self.target}."  # returned string becomes the prompt

    def get_reward(self) -> float:  # optional: the environment scores itself from its own state
        return float(self.counter == self.target)

    # Public methods (exposed as tools)
    def increment(self, step: int) -> int:
        """
        Increment the internal counter.

        Args:
            step: Value to add to the counter.

        Returns:
            The updated counter value.
        """
        self.counter += step
        return self.counter

trainer = GRPOTrainer(
    model="Qwen/Qwen3-0.6B",
    args=GRPOConfig(max_steps=1000, chat_template_kwargs={"enable_thinking": False}),
    environment_factory=IncrementEnv,
)
trainer.train()
Une classe d’environnement possède deux méthodes réservées : reset et get_reward. Contrairement à toute autre méthode publique, celles-ci ne sont pas exposées au modèle en tant qu’outils.
reset(obligatoire) est appelé au démarrage du rollout. Il peut renvoyer soitNone, soit une chaîne de caractères. Dans GRPO, lorsqu’il renvoie une chaîne de caractères, celle-ci correspond au prompt utilisateur.get_reward(facultatif, synchrone ou asynchrone) ne prend aucun argument et renvoie unfloat: l’environnement évalue l’épisode qu’il vient d’exécuter à partir de son état interne (la partie s’est-elle terminée par une victoire ? le mot a-t-il été deviné ?). Il est appelé une fois par déroulement terminé et sert de source de récompense.
Comme l’environnement se rééchantillonne à chaque
reset(), lesGmembres d’un groupe GRPO ne partagent pas nécessairement le même état initial, ce qui rend la référence du groupe légèrement plus bruitée. Pour des états identiques au sein d’un groupe, faites en sorte quereset()dérive l’état de manière déterministe à partir d’une clé partagée.
Fournir un jeu de données externe (facultatif)
Plutôt que de laisser l’environnement s’échantillonner lui-même, vous pouvez fournir un train_dataset externe. Par exemple, lorsque vos tâches sont déjà présentes dans un jeu de données, ou pour router entre plusieurs environnements. À chaque rollout, le formateur échantillonne une ligne, utilise sa colonne "prompt" comme invite, et transmet les autres colonnes de la ligne à reset() en tant qu’arguments nommés (afin que l’environnement lise la tâche depuis le jeu de données).
from datasets import Dataset
from trl import GRPOTrainer

# Each row carries the prompt and the task data (here, the counter target to reach).
dataset = Dataset.from_dict(
    {
        "prompt": [[{"role": "user", "content": f"Increment the counter to {i}."}] for i in range(1, 7)],
        "target": list(range(1, 7)),
    }
)

class IncrementEnv:
    def reset(self, target, **kwargs) -> None:  # the row's `target` column arrives as a keyword argument
        self.counter = 0
        self.target = target

    def get_reward(self) -> float:
        return float(self.counter == self.target)

    def increment(self, step: int) -> int:  # exposed as a tool (see the full docstring above)
        self.counter += step
        return self.counter

trainer = GRPOTrainer(
    model="Qwen/Qwen3-0.6B",
    train_dataset=dataset,  # the dataset owns the task; the "target" column reaches reset(target=...)
    environment_factory=IncrementEnv,
)
trainer.train()
Récompenses
Les récompenses gérées par l’environnement et celles gérées par l’entraîneur ne sont pas mutuellement exclusives. Passez reward_funcs pour les récompenses qui se calculent naturellement à partir de la complétion (par exemple, une vérification du format du texte) et laissez l’environnement retourner sa récompense dépendante de l’état via get_reward. Toutes les sources sont additionnées ; reward_weights ne s’applique qu’aux reward_funcs (l’environnement gère son propre échelle).
def format_reward(completions, **kwargs):  # trainer-owned: scores the completion text
    ...

trainer = GRPOTrainer(
    model="Qwen/Qwen3-0.6B",
    args=GRPOConfig(max_steps=1000),
    reward_funcs=format_reward,          # trainer-owned: scores the completion
    environment_factory=IncrementEnv,    # env-owned: scores its internal state via `get_reward`
)
Une reward_func peut également lire directement l'état de l'environnement : lorsque environment_factory est défini, l'entraîneur transmet un argument environments (une instance par complétion). Cela est parfois utile, mais pour les récompenses dépendantes de l'état, préférez get_reward.
Cela fonctionne de manière identique pour AsyncGRPOTrainer.
Plusieurs environnements
Pour entraîner sur un mélange de tâches dans une seule exécution (par exemple, une tâche de codage et un jeu), passez un dictionnaire associant les noms d’environnements à des fabriques, plutôt qu’un seul appelable. Chaque déroulement sélectionne son environnement via un champ environment dans le jeu de données, et seuls les outils de cet environnement sont exposés. Cela évite de divulguer des outils non pertinents (l’outil move du jeu à un exemple de codage, et inversement). Chaque environnement possède toujours ses propres données et renvoie le prompt depuis reset(), de sorte que le jeu de données n’a besoin que de la colonne environment pour router entre eux.
import random

from datasets import Dataset
from trl import GRPOConfig, GRPOTrainer


class CodingEnv:
    def reset(self, **kwargs) -> str:
        n = random.randint(1, 20)
        return f"Compute the {n}th Fibonacci number."

    def run_code(self, code: str) -> str:  # exposed as a tool only for "coding" examples
        """Run the given Python code and return its stdout.

        Args:
            code: The Python source to execute.

        Returns:
            The captured standard output.
        """
        ...

class GameEnv:
    def reset(self, **kwargs) -> str:
        return "Reach the goal tile."

    def move(self, action: str) -> str:  # exposed as a tool only for "game" examples
        """Apply an action to the game and return the new observation.

        Args:
            action: One of "up", "down", "left", "right".

        Returns:
            The observation after the move.
        """
        ...

# The dataset only routes: each row picks the environment for that rollout
dataset = Dataset.from_dict({"environment": ["coding", "game"] * 500})

trainer = GRPOTrainer(
    model="Qwen/Qwen3-0.6B",
    args=GRPOConfig(chat_template_kwargs={"enable_thinking": False}),
    train_dataset=dataset,
    reward_funcs=reward_func,
    environment_factory={"coding": CodingEnv, "game": GameEnv},
)
trainer.train()
La fonction de récompense reçoit toujours l’environnement de chaque exemple via reward_kwargs["environments"], ce qui lui permet de distinguer le type d’environnement (par ex. isinstance(env, CodingEnv)). Les instances d’environnement sont réutilisées d’une étape à l’autre (réinitialisation entre les épisodes), de sorte qu’un __init__ coûteux n’est payé qu’une seule fois plutôt qu’à chaque étape. Le champ environment est consommé par l’entraîneur et n’est pas transmis à reset.
Réponses d'outils multimodales
Les outils peuvent renvoyer des images en plus du texte en retournant une liste de blocs de contenu. Cela est utile pour l’entraînement d’agents VLM où l’outil fournit un retour visuel (par exemple, des captures d’écran, des graphiques, des images de caméra).
from PIL import Image

def take_screenshot() -> list:
    """
    Takes a screenshot of the current screen.

    Returns:
        The screenshot image with a description.
    """
    img = Image.open("screenshot.png")
    return [{"type": "image", "image": img}, {"type": "text", "text": "Here is the screenshot."}]
Les images renvoyées sont automatiquement injectées dans la conversation et transmises au VLM pour les tours de génération suivants.
Modèles pris en charge
Testé avec :
- Beam — par exemple,
reflection/Beam-1.0-501B-A23B - DeepSeek-R1 — par exemple,
deepseek-ai/DeepSeek-R1 - Gemma4 — par exemple,
google/gemma-4-E2B-it - GLM-4-MoE (4.5, 4.6 ou 4.7) — par exemple,
zai-org/GLM-4.7 - GPT-OSS — par exemple,
openai/gpt-oss-20b - Llama 3.1 — par exemple,
meta-llama/Llama-3.1-8B-Instruct - Llama 3.2 — par exemple,
meta-llama/Llama-3.2-3B-Instruct - Qwen2.5 — par exemple,
Qwen/Qwen2.5-0.5B-Instruct - Qwen3 — par exemple,
Qwen/Qwen3-0.6B - Qwen3-VL — par exemple,
Qwen/Qwen3-VL-2B-Instruct - Qwen3.5 — par exemple,
Qwen/Qwen3.5-2B - Qwen3.6 — par exemple,
Qwen/Qwen3.6-35B-A3B
La compatibilité avec tous les LLM n'est pas garantie. Si vous pensez qu'un modèle devrait être pris en charge, n'hésitez pas à ouvrir un ticket sur GitHub — ou mieux encore, à soumettre une pull request avec les modifications nécessaires.
Intégrations d'environnement
Tous les environnements se branchent sur le même emplacement environment_factory, ils sont donc interchangeables au niveau de TRL — choisissez celui dont l'écosystème correspond à votre tâche :
| Intégration | Ce que c'est | À utiliser lorsque |
|---|---|---|
| OpenEnv | La norme d’environnement ouvert (API de type Gymnasium, servie via WebSocket ou exécution conteneurisée), soutenue par Hugging Face et la communauté. | Vous utilisez un environnement OpenEnv prêt à l’emploi du Hub, ou vous définissez le vôtre conformément à la norme ouverte (par ex. Wordle, Sudoku, Catch). |
| OpenReward | Une intégration avec les environnements parlant ORS (le catalogue openreward.ai ou votre propre serveur ORS) ; les tâches et les récompenses sont servies via HTTP. | Vous souhaitez entraîner contre un environnement ORS : le catalogue (par exemple Eigent/SETA), un environnement auto-hébergé sur votre propre infrastructure, ou un serveur local que vous développez. |
| Harbor | Une intégration avec les suites de tâches Harbor : chaque tâche est une instruction, une image de bac à sable réelle (docker, e2b, …) et un vérificateur dans le bac à sable. | Vous souhaitez entraîner un modèle sur une suite de tâches Harbor : un arbre de tâches, chacune étant un bac à sable autonome accompagné d'un vérificateur (par exemple, un agent d'analyse de données qui explore des fichiers dans un bac à sable et rédige une réponse qu'un correcteur vérifie). |
Entraînement des modèles de vision et de langage
GRPO prend en charge l’entraînement de modèles Vision-Language (VLM) sur des jeux de données multimodaux contenant à la fois du texte et des images.
Modèles pris en charge
Testé avec :
- Gemma3 — par exemple,
google/gemma-3-4b-it - LLaVA-NeXT — par exemple,
llava-hf/llava-v1.6-mistral-7b-hf - Qwen2-VL — par exemple,
Qwen/Qwen2-VL-2B-Instruct - Qwen2.5-VL — par exemple,
Qwen/Qwen2.5-VL-3B-Instruct - SmolVLM2 — par exemple,
HuggingFaceTB/SmolVLM2-2.2B-Instruct
La compatibilité avec tous les VLM n'est pas garantie. Si vous pensez qu'un modèle devrait être pris en charge, n'hésitez pas à ouvrir un ticket sur GitHub — ou mieux encore, à soumettre une pull request avec les modifications nécessaires.
Démarrage rapide
Utilisez grpo_vlm.py pour affiner un VLM. Exemple de commande pour l’entraînement sur lmms-lab/multimodal-open-r1-8k-verified :
torchrun --nproc_per_node 8 examples/grpo_visual_math/grpo_visual_math.py \
  --deepspeed examples/deepspeed_configs/zero3.json \
  --model_name_or_path Qwen/Qwen2.5-VL-3B-Instruct \
  --output_dir grpo-Qwen2.5-VL-3B-Instruct \
  --learning_rate 1e-5 \
  --dtype bfloat16 \
  --max_completion_length 1024 \
  --use_vllm \
  --vllm_mode colocate \
  --use_peft \
  --lora_target_modules "q_proj", "v_proj" \
  --log_completions
Conseils de configuration
- Utiliser LoRA sur les couches de projection vision-langage
- Activer la quantification 4 bits pour réduire l'utilisation de la mémoire
- Les VLM sont gourmands en mémoire — commencez par des tailles de lot plus petites
- La plupart des modèles sont compatibles avec vLLM (modes
serveretcolocate)
Format du jeu de données
Chaque exemple d'entraînement doit inclure :
prompt: texte formaté via le modèle de discussion du processeurimage/images: Image PIL ou liste d'Images PIL
Le formateur gère automatiquement la conversion des images en tenseurs via le processeur d'images du modèle.
GRPOTrainer
classe trl.GRPOTrainer
< source >( model: str | PreTrainedModel | PeftModelreward_funcs: str | transformers.modeling_utils.PreTrainedModel | collections.abc.Callable[..., list[float | None]] | list[str | transformers.modeling_utils.PreTrainedModel | collections.abc.Callable[..., list[float | None]]] | None = Noneargs: trl.trainer.grpo_config.GRPOConfig | None = Nonetrain_dataset: datasets.arrow_dataset.Dataset | datasets.iterable_dataset.IterableDataset | None = Noneeval_dataset: datasets.arrow_dataset.Dataset | datasets.iterable_dataset.IterableDataset | datasets.dataset_dict.DatasetDict | datasets.dataset_dict.IterableDatasetDict | dict[str, datasets.arrow_dataset.Dataset | datasets.iterable_dataset.IterableDataset] | None = Noneprocessing_class: transformers.tokenization_utils_base.PreTrainedTokenizerBase | transformers.processing_utils.ProcessorMixin | None = Nonereward_processing_classes: transformers.tokenization_utils_base.PreTrainedTokenizerBase | list[transformers.tokenization_utils_base.PreTrainedTokenizerBase] | None = Nonecallbacks: list[transformers.trainer_callback.TrainerCallback] | None = Noneoptimizers: tuple[typing.Optional[torch.optim.Optimizer], typing.Optional[torch.optim.lr_scheduler.LambdaLR]] = (None, None)quantization_config: BitsAndBytesConfig | None = Nonepeft_config: PeftConfig | None = Nonetools: list[collections.abc.Callable] | None = Nonerollout_func: collections.abc.Callable[[list[str], 'GRPOTrainer'], dict[str, typing.Any]] | None = Noneenvironment_factory: collections.abc.Callable[[], trl.trainer.grpo_trainer._SupportsReset] | dict[str, collections.abc.Callable[[], trl.trainer.grpo_trainer._SupportsReset]] | None = None )
Paramètres
- model (
strou PreTrainedModel ouPeftModel) — Modèle à entraîner. Peut être l'un des éléments suivants :- Une chaîne de caractères, correspondant à l'identifiant du modèle d'un modèle pré-entraîné hébergé dans un dépôt de modèles sur huggingface.co, ou à un
chemin vers un dossier contenant les poids du modèle enregistrés à l'aide de
save_pretrained, par exemple
'./my_model_directory/'. Le modèle est chargé à l'aide de<ModelArchitecture>.from_pretrained(où<ModelArchitecture>est dérivé de la configuration du modèle) avec les arguments nommés deargs.model_init_kwargs. Sidtypen'est pas spécifié dansargs.model_init_kwargs, la valeur par défaut estfloat32. Cela diffère de from_pretrained, où (depuis Transformers v5) le type de données est déduit de la configuration du modèle. - Un objet PreTrainedModel. Seuls les modèles de langage causaux sont pris en charge.
- Un objet
PeftModel. Seuls les modèles de langage causaux sont pris en charge.
- Une chaîne de caractères, correspondant à l'identifiant du modèle d'un modèle pré-entraîné hébergé dans un dépôt de modèles sur huggingface.co, ou à un
chemin vers un dossier contenant les poids du modèle enregistrés à l'aide de
save_pretrained, par exemple
- reward_funcs (
RewardFunc | list[RewardFunc], facultatif) — Fonctions de récompense à utiliser pour le calcul des récompenses. Pour calculer les récompenses, nous appelons toutes les fonctions de récompense avec les prompts et les complétions, puis nous additionnons les récompenses. Peut être omis lorsque la récompense est fournie par l'environnement viaenvironment_factory((voir ci-dessous). Peut être soit : - Une seule fonction de récompense, par exemple : - Une chaîne de caractères : l'identifiant d'un modèle pré-entraîné hébergé dans un dépôt de modèles sur huggingface.co, ou un chemin vers un répertoire contenant des poids de modèle enregistrés à l'aide de save_pretrained, par exemple './my_model_directory/'. Le modèle est chargé à l'aide de from_pretrained avec num_labels=1 et les arguments de mot-clé de args.model_init_kwargs. - Un objet PreTrainedModel : seuls les modèles de classification de séquence sont pris en charge. - Une fonction de récompense personnalisée : la fonction reçoit les prompts et les complétions générées, ainsi que toutes les colonnes supplémentaires du jeu de données. Elle doit retourner une liste de récompenses. Les fonctions de récompense personnalisées peuvent être synchrones ou asynchrones et peuvent également retourner None lorsque la récompense ne s'applique pas à ces échantillons. Cela est utile pour l'entraînement multi-tâches où différentes fonctions de récompense s'appliquent à différents types d'échantillons. Lorsqu'une fonction de récompense retourne None pour un échantillon, cette fonction de récompense est exclue du calcul de la récompense pour cet échantillon. Pour plus de détails, voir Utilisation d'une fonction de récompense personnalisée. L'état de l'entraîneur est également transmis à la fonction de récompense. L'état de l'entraîneur est une instance de TrainerState et peut être accédé en accédant à l'argument trainer_state de la signature de la fonction de récompense. - Une liste de fonctions de récompense, où chaque élément peut indépendamment être de l'un des types ci-dessus. Le mélange de différents types au sein de la liste (par exemple, un identifiant de modèle en chaîne de caractères et une fonction de récompense personnalisée) est autorisé.-
Une fonction de récompense unique, telle que :
-
Une chaîne de caractères : l'identifiant du modèle d'un modèle pré-entraîné hébergé dans un dépôt de modèles sur huggingface.co, ou un chemin vers un dossier contenant les poids du modèle enregistrés à l'aide de save_pretrained, par exemple
'./my_model_directory/'. Le modèle est chargé à l'aide de from_pretrained avecnum_labels=1et les arguments de mot-clé deargs.model_init_kwargs. -
Un objet PreTrainedModel : seuls les modèles de classification de séquence sont pris en charge.
-
Une fonction de récompense personnalisée : la fonction reçoit les prompts et les complétions générées, ainsi que les colonnes supplémentaires du jeu de données. Elle doit renvoyer une liste de récompenses. Les fonctions de récompense personnalisées peuvent être synchrones ou asynchrones et peuvent également renvoyer
Nonelorsque la récompense ne s'applique pas à ces échantillons. Cela est utile pour l'entraînement multi-tâches où différentes fonctions de récompense s'appliquent à différents types d'échantillons. Lorsqu'une fonction de récompense renvoieNonepour un échantillon, cette fonction de récompense est exclue du calcul de la récompense pour cet échantillon. Pour plus de détails, voir Utiliser une fonction de récompense personnalisée.L’état du formateur est également transmis à la fonction de récompense. L’état du formateur est une instance de TrainerState et peut être consulté en accédant à l’argument
trainer_statede la signature de la fonction de récompense.
-
-
Une liste de fonctions de récompense, où chaque élément peut indépendamment être de l'un des types ci-dessus. Il est possible de mélanger différents types au sein de la liste (par exemple, un identifiant de modèle sous forme de chaîne et une fonction de récompense personnalisée).
-
- args (GRPOConfig, facultatif) —
Configuration de ce formateur. Si
None, une configuration par défaut est utilisée. - train_dataset (Dataset ou IterableDataset, facultatif) —
Jeu de données à utiliser pour l'entraînement. Il doit inclure une colonne
"prompt". Toute colonne supplémentaire du jeu de données est ignorée. Le format des échantillons peut être l'un des deux suivants :- Standard : chaque échantillon contient du texte brut.
- Conversationnel : chaque échantillon contient des messages structurés (par exemple, le rôle et le contenu).
Peut être omis uniquement lorsqu'un
environment_factoryest fourni et que l'environnement possède (ou génère procéduralement) les données, en renvoyant le prompt depuis sa méthodereset(). Dans ce cas,max_stepsdoit être défini pour fixer la durée de l'entraînement.Lorsque
train_datasetest un IterableDataset (par exemple un jeu de données en streaming),max_stepsdoit être défini dans les arguments d’entraînement, car sa longueur ne peut pas être déduite et le nombre total d’étapes d’entraînement est nécessaire pour limiter la boucle d’entraînement et configurer le planificateur de taux d’apprentissage. - eval_dataset (Dataset, IterableDataset, DatasetDict, IterableDatasetDict ou
dict[str, Dataset | IterableDataset]) — Jeu de données à utiliser pour l'évaluation. Il doit répondre aux mêmes exigences quetrain_dataset. - processing_class (PreTrainedTokenizerBase, ProcessorMixin, facultatif) —
Classe de traitement utilisée pour traiter les données. Le côté de bourrage doit être défini sur « left ». Si
None, la classe de traitement est chargée à partir du nom du modèle avec from_pretrained. Un jeton de bourrage,tokenizer.pad_token, doit être défini. Si la classe de traitement n’a pas défini de jeton de bourrage,tokenizer.eos_tokensera utilisé par défaut. - reward_processing_classes (PreTrainedTokenizerBase ou
list[PreTrainedTokenizerBase], facultatif) — Classes de traitement correspondant aux fonctions de récompense spécifiées dansreward_funcs. Peut être soit :- Une seule classe de traitement : utilisée lorsque
reward_funcsne contient qu'une seule fonction de récompense. - Une liste de classes de traitement : doit correspondre à l’ordre et à la longueur des fonctions de récompense dans
reward_funcs. Si défini surNone, ou si un élément de la liste correspondant à un PreTrainedModel estNone, le tokenizer du modèle est chargé automatiquement à l’aide de from_pretrained. Pour les éléments dereward_funcsqui sont des fonctions de récompense personnalisées (non PreTrainedModel), les entrées correspondantes dansreward_processing_classessont ignorées.
- Une seule classe de traitement : utilisée lorsque
- callbacks (liste de TrainerCallback, facultatif) —
Liste de callbacks pour personnaliser la boucle d'entraînement. Ils seront ajoutés à la liste des callbacks par défaut détaillée ici.
Si vous souhaitez supprimer l'un des callbacks par défaut utilisés, utilisez la méthode remove_callback.
- optimizers (
tuple[torch.optim.Optimizer | None, torch.optim.lr_scheduler.LambdaLR | None], facultatif, par défaut(None, None)) — Un tuple contenant l'optimiseur et le planificateur à utiliser. Par défaut, une instance deAdamWest utilisée sur votre modèle ainsi qu'un planificateur défini par get_linear_schedule_with_warmup et contrôlé parargs. - quantization_config (BitsAndBytesConfig, facultatif) —
Configuration de quantification utilisée lors du chargement du modèle à partir d'un identifiant de modèle. À combiner avec
peft_configpour l'entraînement QLoRA. Ignoré si le modèle est déjà instancié. - peft_config (
PeftConfig, facultatif) — Configuration PEFT utilisée pour envelopper le modèle. SiNone, le modèle n'est pas enveloppé. - tools (liste de
Callable, facultatif) — Une liste de fonctions d’outils appelables (synchrones ou asynchrones) que le modèle peut invoquer pendant la génération. Chaque outil doit être une fonction Python standard avec des arguments et des valeurs de retour correctement annotés par des types, ainsi qu’une docstring au style Google décrivant son objectif, ses arguments et sa valeur de retour. Pour plus de détails, voir : https://huggingface.co/docs/transformers/en/chat_extras#passing-tools. Le modèle utilise le nom de la fonction, ses annotations de types et sa docstring pour déterminer comment l’appeler. Assurez-vous que le modèle de chat du modèle prend en charge l’utilisation d’outils et qu’il a été affiné pour l’appel d’outils. - rollout_func (
RolloutFunc, facultatif) — Fonction à utiliser pour générer les complétions. Elle reçoit la liste des prompts alloués au processus actuel ainsi que l’instance du formateur. Elle doit retourner un dictionnaire contenant les champs"prompt_ids","completion_ids"et"logprobs", et peut éventuellement retourner"logprob_token_ids"(même forme que"logprobs"). Tout autre champ est transmis aux fonctions de récompense. La fonction reçoit la tranche brute de prompts par processus sans duplication ; elle est responsable du retour du nombre correct de complétions par prompt (voirnum_generations/num_generations_evalsur le formateur). Cette fonctionnalité est expérimentale et peut changer ou être supprimée à tout moment sans préavis. - environment_factory (
EnvironmentFactoryoudict[str, EnvironmentFactory], facultatif) — Un appelable qui crée et renvoie une instance d'environnement, ou un dictionnaire associant des noms d'environnements à de tels appelables. La classe d'environnement doit définir des méthodes qui peuvent être invoquées comme outils pendant la génération. Chaque méthode doit respecter les mêmes exigences que lestoolsdécrits ci-dessus. L'environnement doit également implémenter un appelableresetqui peut être utilisé pour réinitialiser l'état entre les générations. La méthoderesetdoit renvoyer soitNonesoit une chaîne de caractères : lorsqu'elle renvoie une chaîne, celle-ci est ajoutée au dernier message utilisateur avant la génération. L'environnement peut également définir une méthodeget_rewardne prenant aucun argument et renvoyant unfloat: lorsqu'elle est présente, l'environnement possède la récompense, etget_rewardest appelée une fois par déroulement terminé pour l'évaluer à partir de l'état interne de l'environnement. Elle agit comme une source de récompense supplémentaire (avec un poids de 1, enregistrée sous le nom de la classe de l'environnement) aux côtés dereward_funcs, devient alors facultatif.Avec un seul objet appelable, chaque exemple utilise le même environnement, avec une instance par déroulement afin que leurs interactions restent isolées. Avec un dictionnaire, chaque exemple doit comporter un champ
environmentqui sélectionne son environnement par son nom, et seuls les outils de cet environnement sont exposés dans son prompt — ce qui permet à une seule exécution de mélanger des tâches (par exemple, un environnement de codage et un jeu). Cette fonctionnalité est expérimentale et peut être modifiée ou supprimée à tout moment sans préavis.
Trainer pour la méthode Group Relative Policy Optimization (GRPO). Cet algorithme a été initialement proposé dans l’article DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models.
Exemple :
>>> from trl import GRPOTrainer
>>> from trl.rewards import accuracy_reward
>>> from datasets import load_dataset

>>> dataset = load_dataset("trl-lib/DeepMath-103K", split="train")

>>> trainer = GRPOTrainer(
...     model="Qwen/Qwen2.5-0.5B-Instruct",
...     reward_funcs=accuracy_reward,
...     train_dataset=dataset,
... )
>>> trainer.train()
train
< source >( resume_from_checkpoint: str | bool | None = Nonetrial: optuna.Trial | dict[str, Any] | None = Noneignore_keys_for_eval: list[str] | None = None ) → ~trainer_utils.TrainOutput
Paramètres
- resume_from_checkpoint (
stroubool, facultatif) — Si c'est unestr, chemin local d'un point de contrôle enregistré par une instance précédente deTrainer. Si c'est unboolet vautTrue, charge le dernier point de contrôle dans args.output_dir enregistré par une instance précédente deTrainer. S'il est présent, l'entraînement reprendra à partir des états du modèle/optimiseur/planificateur chargés ici. - trial (
optuna.Trialoudict[str, Any], facultatif) — L’exécution de l’essai ou le dictionnaire d’hyperparamètres pour la recherche d’hyperparamètres. - ignore_keys_for_eval (
list[str], facultatif) — Une liste de clés dans la sortie de votre modèle (s’il s’agit d’un dictionnaire) qui doivent être ignorées lors de la collecte des prédictions pour l’évaluation pendant l’entraînement.
Retourne
~trainer_utils.TrainOutput
Objet contenant le nombre d'étapes globales, la perte d'entraînement et les métriques.
Point d'entrée principal de l'entraînement.
Enregistrera le modèle, ce qui vous permettra de le recharger à l'aide de from_pretrained().
N'enregistrera que depuis le processus principal.
push_to_hub
< source >( commit_message: str | None = 'End of training'blocking: bool = Truetoken: str | None = Nonerevision: str | None = Noneprivate: bool | None = None**kwargs )
Paramètres
- commit_message (
str, facultatif, par défaut"End of training") — Message à committer lors de la poussée. - blocking (
bool, facultatif, par défautTrue) — Indique si la fonction doit ne renvoyer que lorsque legit pushest terminé. - token (
str, facultatif, par défautNone) — Jeton avec permission d’écriture pour écraser les arguments originaux du Trainer. - revision (
str, facultatif) — La révision git à partir de laquelle effectuer le commit. Par défaut, il s'agit de la tête de la branche « main ». - private (
bool, facultatif) — Indique s'il faut rendre le dépôt privé lors de sa création. La valeur par défaut estargs.hub_private_repo. N'a aucun effet si le dépôt existe déjà. - kwargs (
dict[str, Any], facultatif) — Arguments supplémentaires passés à~Trainer.create_model_card.
Téléchargez self.model et self.processing_class sur le hub de modèles 🤗 dans le dépôt self.args.hub_model_id.
GRPOConfig
classe trl.GRPOConfig
< source >( output_dir: str | None = Noneper_device_train_batch_size: int = 8num_train_epochs: float = 3.0max_steps: int = -1learning_rate: float = 1e-06lr_scheduler_type: transformers.trainer_utils.SchedulerType | str = 'linear'lr_scheduler_kwargs: dict | str | None = Nonewarmup_steps: float = 0optim: transformers.training_args.OptimizerNames | str = 'adamw_torch_fused'optim_args: str | None = Noneweight_decay: float = 0.0adam_beta1: float = 0.9adam_beta2: float = 0.999adam_epsilon: float = 1e-08optim_target_modules: None | str | list[str] = Nonegradient_accumulation_steps: int = 1average_tokens_across_devices: bool = Truemax_grad_norm: float = 1.0label_smoothing_factor: float = 0.0bf16: bool | None = Nonefp16: bool = Falsebf16_full_eval: bool = Falsefp16_full_eval: bool = Falsetf32: bool | None = Noneactivation_checkpointing: bool | None = Noneactivation_checkpointing_kwargs: dict[str, typing.Any] | str | None = Nonegradient_checkpointing: bool = Truegradient_checkpointing_kwargs: dict[str, typing.Any] | str | None = Nonetorch_compile: bool = Falsetorch_compile_backend: str | None = Nonetorch_compile_mode: str | None = Noneuse_liger_kernel: bool = Falseliger_kernel_config: dict[str, bool] | None = Noneuse_cache: bool = Falseneftune_noise_alpha: float | None = Nonetorch_empty_cache_steps: int | None = Noneauto_find_batch_size: bool = Falselogging_strategy: transformers.trainer_utils.IntervalStrategy | str = 'steps'logging_steps: float = 10logging_first_step: bool = Falselog_on_each_node: bool = Truelogging_nan_inf_filter: bool = Trueinclude_num_input_tokens_seen: str | bool = 'no'log_level: str = 'passive'log_level_replica: str = 'warning'disable_tqdm: bool | None = Nonereport_to: None | str | list[str] = 'none'run_name: str | None = Noneproject: str = 'huggingface'trackio_space_id: str | None = Nonetrackio_bucket_id: str | None = Nonetrackio_static_space_id: typing.Union[str, NoneType, typing.Literal[False]] = Noneeval_strategy: transformers.trainer_utils.IntervalStrategy | str = 'no'eval_steps: float | None = Noneeval_delay: float = 0per_device_eval_batch_size: int = 8prediction_loss_only: bool = Falseeval_on_start: bool = Falseeval_do_concat_batches: bool = Trueeval_use_gather_object: bool = Falseeval_accumulation_steps: int | None = Noneinclude_for_metrics: list[str] = <factory>batch_eval_metrics: bool = Falsesave_only_model: bool = Falsesave_strategy: transformers.trainer_utils.SaveStrategy | str = 'steps'save_steps: float = 500save_on_each_node: bool = Falsesave_total_limit: int | None = Noneenable_jit_checkpoint: bool = Falsepush_to_hub: bool = Falsehub_token: str | None = Nonehub_private_repo: bool | None = Nonehub_model_id: str | None = Nonehub_strategy: transformers.trainer_utils.HubStrategy | str = 'every_save'hub_always_push: bool = Falsehub_revision: str | None = Noneload_best_model_at_end: bool = Falsemetric_for_best_model: str | None = Nonegreater_is_better: bool | None = Noneignore_data_skip: bool = Falserestore_callback_states_from_checkpoint: bool = Falsefull_determinism: bool = Falseseed: int = 42data_seed: int | None = Noneuse_cpu: bool = Falseaccelerator_config: dict | str | None = Noneparallelism_config: accelerate.parallelism_config.ParallelismConfig | None = Nonedataloader_drop_last: bool = Falsedataloader_num_workers: int = 0dataloader_pin_memory: bool = Truedataloader_persistent_workers: bool = Falsedataloader_prefetch_factor: int | None = Nonedataloader_multiprocessing_context: str | None = Nonedataloader_in_order: bool = Trueremove_unused_columns: bool | None = Falselabel_names: list[str] | None = Nonetrain_sampling_strategy: str = 'random'length_column_name: str = 'length'ddp_find_unused_parameters: bool | None = Noneddp_bucket_cap_mb: int | None = Noneddp_broadcast_buffers: bool | None = Noneddp_static_graph: bool | None = Noneddp_backend: str | None = Noneddp_timeout: int = 1800fsdp: str | None = Nonefsdp_config: dict[str, typing.Any] | str | None = Nonedeepspeed: dict | str | None = Nonedebug: str | list[transformers.debug_utils.DebugOption] = ''skip_memory_metrics: bool = Truedo_train: bool = Falsedo_eval: bool = Falsedo_predict: bool = Falseresume_from_checkpoint: str | None = Nonelocal_rank: int = -1model_init_kwargs: dict[str, typing.Any] | str | None = Nonetrust_remote_code: bool = Falserouter_aux_loss_coef: float | None = Nonedisable_dropout: bool = Falsecast_lm_head_to_fp32: bool = Falsenum_generations: int | None = 8num_generations_eval: int | None = Nonemax_completion_length: int | None = 512ds3_gather_for_generation: bool = Trueshuffle_dataset: bool | None = Truepad_to_multiple_of: int | str | None = 'auto'generation_batch_size: int | None = Nonesteps_per_generation: int | None = Nonetemperature: float = 1.0top_p: float = 1.0top_k: int = 0min_p: float | None = Nonegeneration_kwargs: dict | str | None = Nonechat_template_kwargs: dict | str | None = Nonerepetition_penalty: float = 1.0cache_implementation: str | None = Noneuse_vllm: bool = Falsevllm_mode: str = 'colocate'vllm_model_impl: str = 'vllm'vllm_enable_sleep_mode: bool = Falsevllm_structured_outputs_regex: str | None = Nonevllm_server_base_url: str | None = Nonevllm_server_host: str = '0.0.0.0'vllm_server_port: int = 8000vllm_server_timeout: float = 240.0vllm_group_port: int = 51216vllm_gpu_memory_utilization: float = 0.3vllm_max_model_length: int | None = Nonevllm_tensor_parallel_size: int = 1beta: float = 0.0num_iterations: int = 1epsilon: float = 0.2delta: float | None = Noneepsilon_high: float | None = Nonesapo_temperature_neg: float = 1.05sapo_temperature_pos: float = 1.0vespo_k_pos: float = 2.0vespo_lambda_pos: float = 3.0vespo_k_neg: float = 3.0vespo_lambda_neg: float = 2.0importance_sampling_level: str = 'token'reward_weights: list[float] | None = Nonemulti_objective_aggregation: str = 'sum_then_normalize'scale_rewards: str = 'group'loss_type: str = 'dapo'mask_truncated_completions: bool = Falsesync_ref_model: bool = Falseref_model_mixup_alpha: float = 0.6ref_model_sync_steps: int = 512top_entropy_quantile: float = 1.0entropy_coef: float = 0.0use_adaptive_entropy: bool = Falseentropy_coef_min: float = 0.0entropy_coef_max: float = 1.0entropy_coef_delta: float = 0.005entropy_target: float = 0.2max_tool_calling_iterations: int | None = Nonevllm_importance_sampling_correction: bool = Truevllm_importance_sampling_mode: str = 'sequence_mask'vllm_importance_sampling_clip_max: float | None = 3.0vllm_importance_sampling_clip_min: float | None = Noneoff_policy_mask_threshold: float | None = Noneuse_bias_correction_kl: bool = Truelog_completions: bool = Falselog_multimodal: bool = Truenum_completions_to_print: int | None = Nonelog_unique_prompts: bool = Falselog_completions_hub_repo: str | None = Noneuse_transformers_continuous_batching: bool = Falsetransformers_continuous_batching_config: dict | str | None = Noneuse_transformers_paged: bool = Falsevllm_importance_sampling_cap: float | None = None )
Paramètres qui contrôlent le modèle et le modèle de référence
- model_init_kwargs (
stroudict[str, Any], facultatif) — Arguments par mot-clé pour from_pretrained, utilisés lorsque l’argumentmodeldu GRPOTrainer est fourni sous forme de chaîne de caractères. La valeur derevisionest également utilisée lors du chargement des classes de traitement. - trust_remote_code (
bool, facultatif, valeur par défautFalse) — Indique s'il faut autoriser le chargement de modèles et de tokenizers qui incluent du code Python personnalisé depuis le Hub. Transmis à from_pretrained et from_pretrained. S'applique également au chargement des modèles de récompense et des tokenizers de récompense. - router_aux_loss_coef (
float, facultatif) — Coefficient de la perte auxiliaire d’équilibrage de charge pour les modèles Mixture-of-Experts (MoE), ajoutée à la perte d’entraînement avec ce poids. Si non défini, la valeur déclarée par la configuration du modèle est utilisée. Définissez-le à0.0pour le désactiver. Échoue s’il est utilisé avec un modèle non-MoE. - disable_dropout (
bool, facultatif, valeur par défautFalse) — Indique s'il faut désactiver le dropout dans le modèle. Cela est utile pour l'entraînement avec un modèle de référence, car cela empêche le modèle de générer des logprobs différents pour la même entrée. - cast_lm_head_to_fp32 (
bool, facultatif, par défautFalse) — Indique s'il faut convertir la tête de modélisation du langage des modèles de politique et de référence en float32. Comme recommandé par la recette ScaleRL. Ce drapeau n'est pris en charge que lorsque le modèle possède des couches de plongement de mots et de tête de modélisation du langage non liées, c'est-à-dire quetie_word_embeddingsdans la configuration du modèle est False.
Paramètres qui contrôlent la prétraitement des données
- remove_unused_columns (
bool, facultatif, valeur par défautFalse) — Indique s'il faut ne conserver que la colonne"prompt"dans le jeu de données. Si vous utilisez une fonction de récompense personnalisée qui nécessite une colonne autre que"prompts"et"completions", vous devez laisser cette valeur àFalse. - num_generations (
int, facultatif, valeur par défaut8) — Nombre de générations à échantillonner par invite. La taille de lot effective (num_processes * per_device_batch_size * gradient_accumulation_steps) doit être divisible par cette valeur.- gradient_accumulation_steps) doit être divisible par cette valeur.
- num_generations_eval (
int, facultatif) — Nombre de générations à échantillonner lors de l'évaluation. Cela permet d'utiliser moins de générations pendant l'évaluation afin d'économiser des calculs. SiNone, utilise la valeur denum_generations. - max_completion_length (
intouNone, facultatif, par défaut512) — Longueur maximale de la complétion générée. - ds3_gather_for_generation (
bool, facultatif, valeur par défautTrue) — Ce paramètre s’applique à DeepSpeed ZeRO-3. S’il est activé, les poids du modèle de politique sont regroupés pour la génération, ce qui améliore la vitesse de génération. Toutefois, désactiver cette option permet d’entraîner des modèles dont la taille dépasse la capacité VRAM d’une seule GPU, au prix d’une génération plus lente. La désactivation de cette option n’est pas compatible avec la génération vLLM. - shuffle_dataset (
bool, facultatif, par défautTrue) — Indique s'il faut mélanger le jeu de données d'entraînement. - pad_to_multiple_of (
intoustr, facultatif, valeur par défaut"auto") — Si défini, les identifiants des prompts et des complétions seront rembourrés jusqu'à un multiple de cette valeur."auto"rembourde jusqu'à un multiple de 128 sur Neuron (AWS Trainium), qui compile une fois par forme d'entrée, et ne rembourde pas ailleurs.
Paramètres qui contrôlent la génération
- generation_batch_size (
int, facultatif) — Taille de lot à utiliser pour la génération. SiNone, la valeur par défaut est la taille de lot effective d’entraînement :per_device_train_batch_size * num_processes * steps_per_generation. Autrement dit, un lot de génération est traité par étape d’optimisation. Mutuellement exclusif avecsteps_per_generation. - steps_per_generation (
int, facultatif) — Nombre d'étapes par génération. SiNone, la valeur par défaut estgradient_accumulation_steps. Mutuellement exclusif avecgeneration_batch_size. - temperature (
float, facultatif, par défaut1.0) — Température pour l'échantillonnage. Plus la température est élevée, plus les complétions sont aléatoires. - top_p (
float, facultatif, par défaut1.0) — Flottant qui contrôle la probabilité cumulée des jetons de tête à prendre en compte. Doit être dans (0, 1]. Définissez-le à1.0pour prendre en compte tous les jetons. - top_k (
int, facultatif, par défaut0) — Nombre de jetons du vocabulaire ayant la plus haute probabilité à conserver pour le filtrage top-k. Si la valeur est0, le filtrage top-k est désactivé et tous les jetons sont pris en compte. - min_p (
float, facultatif) — Probabilité minimale du jeton, qui sera mise à l'échelle par la probabilité du jeton le plus probable. Elle doit être une valeur comprise entre0.0et1.0. Les valeurs typiques se situent dans la plage0.01-0.2. - generation_kwargs (
dict[str, Any], facultatif) — Arguments supplémentaires à passer à GenerationConfig (si vous utilisez transformers) ouSamplingParams(si vous utilisez vLLM) lors de l'échantillonnage des complétions. Cela permet de personnaliser davantage le comportement de la génération, par exemple en définissantsuppress_tokens,num_beams, etc. S'il contient des clés qui entrent en conflit avec les autres paramètres de génération (commemin_p,top_p, etc.), ils les remplaceront. - chat_template_kwargs (
dict[str, Any], facultatif) — Arguments supplémentaires à passer à la fonctionapply_chat_templatelors de la génération des complétions. - repetition_penalty (
float, facultatif, par défaut1.0) — Flottant qui pénalise les nouveaux jetons en fonction de leur présence dans le prompt et dans le texte généré jusqu’à présent. Les valeurs >1.0encouragent le modèle à utiliser de nouveaux jetons, tandis que les valeurs <1.0encouragent le modèle à répéter les jetons. - cache_implementation (
str, facultatif) — Implémentation de la méthode de cache pour une génération plus rapide lorsqueuse_vllmest défini surFalse.
Paramètres qui contrôlent l'accélération de la génération propulsée par vLLM
- use_vllm (
bool, facultatif, valeur par défautFalse) — Indique s'il faut utiliser vLLM pour générer des complétions. Si défini surTrue, l'entraîneur utilisera vLLM pour la génération au lieu de model.generate() par défaut. Nécessite l'installation devllm. - vllm_mode (
str, facultatif, valeur par défaut"colocate") — Mode à utiliser pour l'intégration vLLM lorsqueuse_vllmest défini surTrue. Doit être l'un des"server"ou"colocate"."server": le formateur enverra les requêtes de génération à un serveur vLLM distinct. Assurez-vous qu’un serveur vLLM est en cours d’exécution (à démarrer avecvllm serve)."colocate": vLLM s’exécute dans le même processus et partage les GPU d’entraînement. Cela évite d’avoir besoin d’un serveur séparé, mais peut provoquer une concurrence pour les ressources avec l’entraînement.
- vllm_model_impl (
str, facultatif, par défaut"vllm") — Implémentation du modèle à utiliser pour vLLM. Doit être l'une des valeurs"transformers"ou"vllm"."transformers": utiliser le backendtransformerspour l'implémentation du modèle."vllm": utiliser la bibliothèquevllmpour l'implémentation du modèle. - vllm_enable_sleep_mode (
bool, facultatif, valeur par défautFalse) — Active le mode veille de vLLM pour décharger les poids et le cache pendant l'étape d'optimisation. Cela maintient l'utilisation de la mémoire GPU au plus bas, mais le réveil du moteur ajoute une latence de transfert hôte-appareil. - vllm_structured_outputs_regex (
str, facultatif) — Expression régulière pour les sorties structurées de vLLM. SiNone(par défaut), les sorties structurées sont désactivées.
Paramètres qui contrôlent le serveur vLLM (utilisés uniquement lorsque `vllm_mode` est `"server"`)
- vllm_server_base_url (
str, facultatif) — URL de base du serveur vLLM (par exemple,"http://localhost:8000"). Si fournie,vllm_server_hostetvllm_server_portsont ignorés. - vllm_server_host (
str, facultatif, par défaut"0.0.0.0") — Hôte du serveur vLLM auquel se connecter. Ignoré sivllm_server_base_urlest fourni. - vllm_server_port (
int, facultatif, par défaut8000) — Port du serveur vLLM auquel se connecter. Ignoré sivllm_server_base_urlest fourni. - vllm_server_timeout (
float, facultatif, valeur par défaut240.0) — Durée totale de temporisation, en secondes, à attendre pour que le serveur vLLM soit opérationnel. Si le serveur n'est pas opérationnel après le dépassement de ce délai, uneConnectionErrorest levée. - vllm_group_port (
int, facultatif, valeur par défaut51216) — Numéro de port du groupe de mise à jour des poids. Il est utilisé pour communiquer avec le serveur vLLM. Sauf si le port est occupé, il n'est pas nécessaire de le modifier.
Paramètres qui contrôlent l'exécution de vLLM co-localisée (utilisés uniquement lorsque `vllm_mode` est `"colocate"`)
- vllm_gpu_memory_utilization (
float, facultatif, valeur par défaut0.3) — Contrôle l'utilisation de la mémoire GPU pour vLLM. Ce paramètre ne s'applique que lorsquevllm_modeest défini sur"colocate". Si vous utilisezvllm_mode="server", ce paramètre doit être transmis séparément lors du démarrage du serveur vLLM via le drapeau--vllm_gpu_memory_utilization. - vllm_max_model_length (
int, facultatif) — Fenêtre de contexte pour vLLM. Réglez-la sur au moins la longueur maximale des prompts dans le jeu de données plusmax_completion_length; si elle est omise, elle est déduite de la configuration du modèle. - vllm_tensor_parallel_size (
int, facultatif, valeur par défaut1) — Contrôle la taille du parallélisme de tenseurs pour vLLM. Ce paramètre ne s’applique que lorsquevllm_modeest défini sur"colocate". Si vous utilisezvllm_mode="server", ce paramètre doit être transmis séparément lors du démarrage du serveur vLLM via le drapeau--vllm_tensor_parallel_size.
Paramètres qui contrôlent l'entraînement
- beta (
float, facultatif, par défaut0.0) — Coefficient KL. Si0.0(par défaut), le modèle de référence n’est pas chargé, ce qui réduit l’utilisation de la mémoire et améliore la vitesse d’entraînement. DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning utilise une valeur de0.001. - num_iterations (
int, facultatif, par défaut1) — Nombre d'itérations par lot (noté μ dans l'algorithme). - epsilon (
float, facultatif, valeur par défaut0.2) — Valeur pour le clipping. - delta (
float, facultatif) — Active la borne supérieure de rognage dans la perte GRPO à double côté lorsqu’elle est définie sur un float. SiNone(par défaut), la rognage GRPO standard est utilisée. Il est recommandé de la définir sur une valeur supérieure à1 + εlorsqu’elle est activée. Cette méthode est introduite dans le rapport technique INTELLECT-2. - epsilon_high (
float, facultatif) — Valeur epsilon supérieure pour le clipping. Si elle n'est pas spécifiée, elle prend par défaut la même valeur que la borne inférieure spécifiée dans l'argumentepsilon. L'article DAPO recommande0.28. Lorsqu'elle est utilisée avecloss_type='cispo', elle correspond au paramètre ε_max spécifié dans l'article ScaleRL et prend par défaut la valeur recommandée5.0. - sapo_temperature_neg (
float, facultatif, valeur par défaut1.05) — Température pour les jetons ayant des scores d'avantage non positifs, utilisée dans la fonction de pertesapo. Ce paramètre est introduit dans l'article Soft Adaptive Policy Optimization. - sapo_temperature_pos (
float, facultatif, valeur par défaut1.0) — Température pour les jetons ayant des scores d'avantage positifs, utilisée dans la fonction de pertesapo. Ce paramètre est introduit dans l'article Soft Adaptive Policy Optimization. - vespo_k_pos (
float, facultatif, valeur par défaut2.0) — paramètre k pour les avantages positifs, il s'agit de l'exposant de puissance dans la perte VESPO. Il contrôle la force avec laquelle nous atténuons les échantillons ayant des poids d'importance faibles (lorsque le ratio d'échantillonnage d'importance < 1). - vespo_lambda_pos (
float, facultatif, valeur par défaut3.0) — paramètre lambda pour les avantages positifs, il s'agit du facteur d'atténuation dans la perte VESPO. Il contrôle la manière dont nous réduisons le poids des échantillons ayant des poids d'importance élevés (lorsque le ratio d'échantillonnage d'importance > 1). - vespo_k_neg (
float, facultatif, valeur par défaut3.0) — Paramètre k pour les avantages négatifs, il s'agit de l'exposant de puissance dans la perte VESPO. Il contrôle la force avec laquelle nous atténuons les échantillons ayant des poids d'importance faibles (lorsque le ratio d'échantillonnage d'importance < 1). - vespo_lambda_neg (
float, facultatif, valeur par défaut2.0) — paramètre lambda pour les avantages négatifs, il s'agit du facteur de décroissance exponentielle dans la perte VESPO. Il contrôle l'agressivité avec laquelle nous réduisons le poids des échantillons ayant des poids d'importance élevés (lorsque le ratio d'échantillonnage d'importance > 1). - importance_sampling_level (
str, facultatif, valeur par défaut"token") — Contrôle si les ratios d’échantillonnage d’importance sont calculés au niveau"token"ou"sequence"."token"conserve les ratios bruts de log-probabilités par jeton (un poids par jeton)."sequence"moyenne les ratios de log-probabilités sur les jetons valides pour produire un ratio unique par séquence. L’article GSPO montre que l’échantillonnage au niveau séquence donne souvent un entraînement plus stable et une meilleure alignement avec les récompenses au niveau séquence. - reward_weights (
list[float], facultatif) — Poids pour chaque fonction de récompense. Doit correspondre au nombre de fonctions de récompense. SiNone, toutes les récompenses sont pondérées également avec un poids de1.0. - multi_objective_aggregation (
str, facultatif, par défaut"sum_then_normalize") — Méthode pour agréger plusieurs fonctions de récompense. Les valeurs prises en charge sont :"sum_then_normalize"(par défaut) : somme d’abord les récompenses pondérées de chaque fonction de récompense, puis applique l’échelle/la normalisation des récompenses telles que spécifiées parscale_rewards(voirscale_rewardspour plus de détails)."normalize_then_sum": normalise/dimensionne d’abord chaque fonction de récompense à travers les générations (au sein de chaque groupe), puis somme les récompenses normalisées en utilisant les poids spécifiés. La récompense agrégée est ensuite normalisée au niveau du lot lors de la formation des avantages. Il s’agit de l’approche suggérée par l’article GDPO: Group reward-Decoupled Normalization Policy Optimization for Multi-reward RL Optimization.
- scale_rewards (
stroubool, facultatif, par défaut"group") — Spécifie la stratégie de mise à l'échelle des récompenses. Les valeurs prises en charge sont :Trueou"group"(par défaut) : les récompenses sont mises à l'échelle par l'écart-type au sein de chaque groupe, garantissant une variance unitaire au sein d'un groupe."batch": les récompenses sont mises à l’échelle par l’écart-type sur l’ensemble du lot, comme recommandé dans l’article PPO Lite.Falseou"none": aucune mise à l’échelle n’est appliquée. L’article Dr. GRPO recommande de ne pas mettre les récompenses à l’échelle, car la mise à l’échelle par l’écart-type introduit un biais de difficulté au niveau de la question.
- loss_type (
str, facultatif, par défaut"dapo") — Spécifie la formulation de la perte à utiliser. Les valeurs prises en charge sont : "grpo" : agrège les pertes au niveau des jetons en normalisant par la longueur de la séquence. Non recommandé en raison du biais de longueur — cette approche tend à privilégier les complétions plus courtes avec des avantages positifs et les plus longues avec des avantages négatifs. "dr_grpo" : agrège les pertes au niveau des jetons en normalisant avec une constante globale. Cette méthode a été introduite dans le papier Dr. GRPO pour éliminer le biais de longueur. La valeur de la constante correspond à max_completion_length. "dapo" (par défaut) : agrège les pertes au niveau des jetons en normalisant par le nombre de jetons actifs dans le lot global accumulé. Cette méthode a été introduite dans le papier DAPO pour éliminer le biais de longueur. "bnpo" : agrège les pertes au niveau des jetons en normalisant par le nombre de jetons actifs dans le lot local. Notez que la normalisation est effectuée uniquement sur le lot local, de sorte que les résultats peuvent varier légèrement en fonction de la taille du lot local, malgré une taille de lot effective constante. Lors de l'utilisation de per_device_train_batch_size==1, la perte est équivalente à la perte GRPO. "cispo" : applique un élagage aux poids d'échantillonnage d'importance au lieu des poids d'importance pondérés par l'avantage. Les poids élagués sont ensuite multipliés par les avantages et les probabilités logarithmiques du modèle de politique. Les pertes individuelles des jetons sont agrégées en normalisant par le nombre de jetons actifs dans le lot global accumulé. Cette méthode a été introduite dans le papier MiniMax-M1. "sapo" : perte de Soft Adaptive Policy Optimization, telle qu'introduite dans le papier Soft Adaptive Policy Optimization. Remplace l'élagage dur par une porte lisse contrôlée par la température qui atténue de manière adaptative les mises à jour hors politique tout en préservant les signaux d'apprentissage utiles. "luspo" : perte de Length-Unbiased Sequence Policy Optimization. Une perte au niveau de la séquence qui met à l'échelle la perte de chaque séquence en fonction de sa longueur. Il s'agit d'une modification de GSPO et nécessite importance_sampling_level="sequence". Introduite dans le papier LUSPO. "vespo" : Variational Sequence-Level Soft Policy Optimization. Remplace l'élagage dur par une fonction de pondération Gamma lisse et asymétrique appliquée directement aux poids d'importance au niveau de la séquence. Introduite dans le papier VESPO."grpo": agrège les pertes au niveau des jetons en les normalisant sur la longueur de la séquence. Non recommandé en raison du biais de longueur — cette approche a tendance à privilégier les complétions plus courtes avec des avantages positifs et les plus longues avec des avantages négatifs."dr_grpo": agrège les pertes au niveau des jetons en les normalisant avec une constante globale. Cette méthode a été introduite dans l'article Dr. GRPO pour éliminer le biais de longueur. La valeur de la constante correspond àmax_completion_length."dapo"(par défaut) : agrège les pertes au niveau des jetons en les normalisant par le nombre de jetons actifs du lot global accumulé. Cette méthode a été introduite dans l'article DAPO pour éliminer le biais de longueur."bnpo": agrège les pertes au niveau des jetons en les normalisant par le nombre de jetons actifs du lot local. Notez que la normalisation est effectuée uniquement sur le lot local, de sorte que les résultats peuvent varier légèrement en fonction de la taille du lot local, malgré une taille de lot effective constante. Lors de l'utilisation deper_device_train_batch_size==1, la perte est équivalente à la perte GRPO."cispo": Applique un élagage (clipping) aux poids d’échantillonnage d’importance plutôt qu’aux poids d’échantillonnage d’importance mis à l’échelle par l’avantage. Les poids élagués sont ensuite multipliés par les avantages et les logarithmes de probabilités du modèle de politique. Les pertes individuelles par jeton sont agrégées en les normalisant par le nombre de jetons actifs dans le lot global accumulé. Cette méthode a été introduite dans l’article MiniMax-M1."sapo": perte Soft Adaptive Policy Optimization, telle qu’introduite dans l’article Soft Adaptive Policy Optimization. Remplace le rognage dur par une porte lisse, contrôlée par la température, qui atténue de manière adaptative les mises à jour hors politique tout en préservant les signaux d’apprentissage utiles."luspo": perte de Length-Unbiased Sequence Policy Optimization. Une perte au niveau de la séquence qui met à l’échelle la perte de chaque séquence en fonction de sa longueur. Il s’agit d’une modification de GSPO et nécessiteimportance_sampling_level="sequence". Introduite dans l’article LUSPO."vespo": Variational Sequence-Level Soft Policy Optimization. Remplace le rognage dur par une fonction de pondération Gamma lisse et asymétrique appliquée directement aux poids d'importance au niveau de la séquence. Introduit dans l'article VESPO.
- mask_truncated_completions (
bool, facultatif, valeur par défautFalse) — Lorsqu’il est activé, les complétions tronquées sont exclues du calcul de la perte, ce qui empêche qu’elles soient pénalisées à tort et introduisent du bruit pendant l’entraînement. Selon l’article DAPO, il s’agit d’une bonne pratique pour la stabilité de l’entraînement. - sync_ref_model (
bool, facultatif, par défautFalse) — Indique s'il faut synchroniser le modèle de référence avec le modèle actif toutes lesref_model_sync_stepsétapes, en utilisant le paramètreref_model_mixup_alpha. Cette synchronisation provient de l'article TR-DPO. - ref_model_mixup_alpha (
float, facultatif, valeur par défaut0.6) — Paramètre α issu de l'article TR-DPO, qui contrôle le mélange entre la politique actuelle et la politique de référence précédente lors des mises à jour. La politique de référence est mise à jour selon l'équation :π_ref = α * π_θ + (1 - α) * π_ref_prev. Pour utiliser ce paramètre, vous devez définirsync_ref_model=True. - ref_model_sync_steps (
int, facultatif, valeur par défaut512) — paramètre τ issu de l’article TR-DPO, qui détermine la fréquence à laquelle la politique actuelle est synchronisée avec la politique de référence. Pour utiliser ce paramètre, vous devez définirsync_ref_model=True. - top_entropy_quantile (
float, facultatif, par défaut1.0) — Paramètre ρ issu de Beyond the 80/20 Rule. Conserve dans le terme de perte de la politique uniquement le quantile supérieur ρ des jetons, classés par entropie de la distribution de probabilité à chaque position de la séquence, ce qui améliore les résultats. Intervalle :[0.0-1.0]. Une valeur de0.0masque tous les jetons sauf celui ayant l’entropie la plus élevée ;1.0conserve tous les jetons. L’article recommande une valeur de0.2. Si utilisé avecmask_truncated_completions=True, seuls les jetons issus de complétions non tronquées sont pris en compte. - entropy_coef (
float, facultatif, par défaut0.0) — Coefficient du terme de régularisation par entropie dans la fonction de perte. Une valeur positive ajoute un bonus d'entropie qui encourage l'exploration en empêchant la politique de converger vers des sorties quasi déterministes. Le bonus est toujours l'entropie moyenne par jeton, indépendamment deloss_type; il n'est pas rééchelonné pour correspondre à la normalisation de la politique d'un type de perte donné, de sorte queentropy_coefa la même signification pour tous les types de perte. Lorsqueuse_adaptive_entropy=True, cette valeur sert de coefficient initial et est mise à jour à chaque étape de l'optimiseur. N'a aucun effet lorsqu'elle est définie sur0.0(par défaut). - use_adaptive_entropy (
bool, facultatif, valeur par défautFalse) — Indique s'il faut utiliser le contrôle adaptatif de l'entropie, introduit dans Skywork-OR1. Lorsqu'il est activé, le coefficient d'entropieentropy_coefest mis à jour à chaque étape de l'optimiseur : il est incrémenté deentropy_coef_deltalorsque l'entropie actuelle est inférieure àentropy_target, et décrémenté dans le cas contraire. Le coefficient n'est appliqué que lorsque l'entropie est inférieure ou égale àentropy_target. - entropy_coef_min (
float, facultatif, valeur par défaut0.0) — Borne inférieure du coefficient d'entropie lors de l'utilisation du contrôle adaptatif de l'entropie. - entropy_coef_max (
float, facultatif, valeur par défaut1.0) — Limite supérieure du coefficient d'entropie lors de l'utilisation du contrôle adaptatif de l'entropie. - entropy_coef_delta (
float, facultatif, valeur par défaut0.005) — Taille de pas pour l’ajustement du coefficient d’entropie à chaque étape de l’optimiseur lors du contrôle adaptatif de l’entropie. - entropy_target (
float, facultatif, valeur par défaut0.2) — Entropie moyenne cible par jeton (en nats) utilisée par le contrôle adaptatif de l’entropie. Le coefficient n’est appliqué que lorsque l’entropie actuelle est inférieure ou égale à cette valeur. Elle est mesurée sur le même ensemble de jetons que la perte de politique : tous les jetons de complétion par défaut, ou uniquement le sous-ensemble à haute entropie lorsquetop_entropy_quantile < 1.0. Les modèles de langage typiques présentent des entropies par jeton comprises entre 2 et 10 nats, de sorte que la valeur par défaut de0.2ne déclenche presque jamais la régularisation (sauf en cas d’effondrement quasi total de l’entropie) ; réglez-la à proximité de l’entropie observée en début d’entraînement (journalisée sous la métriqueentropy) afin que la prime s’active avant l’effondrement de la politique (tenez compte du sous-ensemble de jetons lorsque vous utiliseztop_entropy_quantile). - max_tool_calling_iterations (
int, facultatif) — Nombre maximal de tours d’appel d’outils lors de l’entraînement d’un agent. SiNone, il n’y a pas de limite et la génération s’arrête lorsque le modèle génère un tour de réponse sans appels d’outils, lorsque la complétion (tous les tours et les résultats d’outils) atteintmax_completion_lengthjetons, ou lorsque la séquence complète atteint la longueur maximale du modèle (vllm_max_model_lengthavecvllm_mode="colocate", lesmax_position_embeddingsdu modèle sinon). - vllm_importance_sampling_correction (
bool, facultatif, valeur par défautTrue) — Indique s'il faut appliquer l'Importance Sampling (IS) pour corriger l'écart entre les logprobs de complétion de vLLM et les logprobs de formation recalculés. Si défini surFalse, aucun IS n'est appliqué, quel que soitvllm_importance_sampling_mode. Si défini surTrue, le mode sélectionné détermine la manière dont les ratios IS sont calculés et contraints. Avectop_p < 1,top_k > 0oumin_p > 0, les logprobs recalculés sont normalisés sur l'ensemble des candidats à partir duquel chaque jeton a été échantillonné, ce qui nécessite vLLM 0.28 ou ultérieur et, en mode serveur, un serveur démarré avec--return-sampling-mask(et--enable-scale-outà partir de vLLM 0.30) ; sinon, les ratios IS sont biaisés. vLLM borne cet ensemble de candidats avectop_k, de sorte quetop_p < 1,min_p > 0et les sorties structurées, qui le restreignent aux jetons autorisés par la grammaire, nécessitenttop_k > 0(par ex.top_k=512). Les sorties structurées, qui bloqueraient autrement l'entraînement, nécessitent également cet ensemble de candidats. vLLM applique égalementrepetition_penaltyaux logprobs qu'il renvoie, de sorte querepetition_penalty != 1.0exigevllm_importance_sampling_correction=False. - vllm_importance_sampling_mode (
str, facultatif, valeur par défaut"sequence_mask") — Précise la manière dont l'Importance Sampling est effectué lorsquevllm_importance_sampling_correction=True. Les valeurs possibles sont :"token_truncate": IS tronquée au niveau des jetons. Les ratios par jeton sont bornés à [C_min, C_max]."token_mask": IS masqué au niveau des jetons. Les ratios par jeton situés en dehors de [C_min, C_max] sont mis à zéro."sequence_truncate": IS tronqué au niveau de la séquence. Un seul ratio de séquence est borné à [C_min, C_max] et appliqué à tous les jetons de la séquence."sequence_mask": IS masqué au niveau des séquences. Les séquences dont les ratios sont en dehors de [C_min, C_max] sont masquées.
- vllm_importance_sampling_clip_max (
float, facultatif, valeur par défaut3.0) — Limite supérieure C_max de l'échantillonnage par importance utilisée parvllm_importance_sampling_mode. Pour les modes*_truncate, les ratios d'importance sont tronqués par la valeur C_max. Pour les modes*_mask, les ratios supérieurs à C_max sont mis à zéro. - vllm_importance_sampling_clip_min (
float, facultatif) — Borne inférieure C_min de l'échantillonnage par importance utilisée parvllm_importance_sampling_mode. Pour les modes*_truncate, les ratios sont tronqués par la valeur inférieure C_min. Pour les modes*_mask, les ratios inférieurs à C_min sont mis à zéro. Pour masquer strictement les ratios inférieurs à C_min sans borne supérieure, définissezvllm_importance_sampling_clip_max=None. - off_policy_mask_threshold (
float, facultatif) — Seuil pour le masquage des séquences hors politique. SiNone, le masquage des séquences hors politique est désactivé. Lorsqu'il est défini, les séquences présentant des avantages négatifs et une divergence KL élevée sont masquées pour stabiliser l'entraînement. Ce paramètre correspond au seuildeltade l'équation 9 de l'article DeepSeek-V3.2. Il attend une valeur positive (par exemple, 0,5). - use_bias_correction_kl (
bool, facultatif, valeur par défautTrue) — Indique s'il faut multiplier le terme KL par le ratio d'échantillonnage d'importance, afin que le gradient KL devienne le gradient non biaisé du KL inverse, tel que décrit dans le paper DeepSeek-V3.2. Cela modifie le gradient KL dès quebeta != 0, y compris en on-policy : le ratio est différentiable, il affecte donc le gradient même lorsque sa valeur est exactement 1. La propriété de KL inverse non biaisé est valable pourimportance_sampling_level="token"; avec"sequence", un poids au niveau de la séquence est diffusé sur le KL par token.
Paramètres qui contrôlent la journalisation
- log_completions (
bool, facultatif, par défautFalse) — Indique s'il faut consigner un échantillon de paires (prompt, completion) toutes leslogging_stepsétapes. Sirichest installé, l'échantillon est affiché. Si la journalisationwandbet/outrackioest activée, il est consigné danswandbet/outrackio. - log_multimodal (
bool, facultatif, valeur par défautTrue) — Indique s'il faut journaliser le contenu multimodal (images, vidéos, etc.) avec les complétions. Désactivez cette option pour réduire la taille des journaux lors de l'utilisation de données multimodales haute résolution. - num_completions_to_print (
int, facultatif) — Nombre de complétions à afficher avecrich. SiNone, toutes les complétions sont journalisées. - log_unique_prompts (
bool, facultatif, valeur par défautFalse) — Indique s'il faut journaliser les prompts uniques. SiTrue, seuls les prompts uniques sont journalisés. SiFalse, tous les prompts sont journalisés. - log_completions_hub_repo (
str, facultatif) — Dépôt du Hugging Face Hub où enregistrer les complétions. Doit être un nom de dépôt complet comme'username/reponame'ou'orgname/reponame', ou simplement'reponame', auquel cas le dépôt sera créé dans l’espace de noms de l’utilisateur Hugging Face actuellement connecté. Notez que ce dépôt sera public sauf si vous définissezhub_private_repo=Trueou si l’organisation a par défaut la création de dépôts privés.
Paramètres qui contrôlent l'accélération de la génération grâce au batch continu de Transformers
- use_transformers_continuous_batching (
bool, facultatif, valeur par défautFalse) — Indique s'il faut utiliser le moteur de continuous batching de transformers pour générer des complétions. Nécessitetransformers>=5.8.0. - transformers_continuous_batching_config (
dict, facultatif) — Arguments par mot-clé pourContinuousBatchingConfig.
Paramètres obsolètes
- use_transformers_paged —
Le paramètre
use_transformers_pagedest obsolète et sera supprimé dans la version v2.0.0. Utilisezuse_transformers_continuous_batchingà la place. - vllm_importance_sampling_cap —
Le paramètre
vllm_importance_sampling_capest obsolète et sera supprimé dans la version v2.0.0. Utilisezvllm_importance_sampling_clip_maxà la place.
Classe de configuration pour le GRPOTrainer.
Cette classe ne contient que les paramètres spécifiques à l’entraînement GRPO. Pour la liste complète des arguments d’entraînement, veuillez consulter la documentation de TrainingArguments. Notez que les valeurs par défaut de cette classe peuvent différer de celles de TrainingArguments.
À l’aide de HfArgumentParser, nous pouvons transformer cette classe en arguments argparse qui peuvent être spécifiés sur la ligne de commande.
Ces paramètres ont des valeurs par défaut différentes de TrainingArguments :
logging_steps: la valeur par défaut est10au lieu de500.gradient_checkpointing: la valeur par défaut estTrueau lieu deFalse.bf16: passe àTruepar défaut sifp16n’est pas défini, au lieu deFalse.learning_rate: la valeur par défaut est1e-6au lieu de5e-5.