
TRL documentation
Интеграция и использование Kernels Hub
Интеграция и использование Kernels Hub
Библиотека kernels позволяет загружать оптимизированные вычислительные ядра непосредственно из Hub.
Найти kernels можно в выделенных организациях или с помощью поиска по тегу kernel в Hub.
Ядра — это оптимизированные фрагменты кода, которые используются при разработке, обучении и инференсе моделей. Здесь мы сосредоточимся на их интеграции с TRL, но для более подробной информации обратитесь к указанным выше ресурсам.
Установка
Чтобы использовать ядра с TRL, необходимо установить библиотеку в вашем окружении Python:
pip install kernels
Использование Kernels из Hub в TRL
Ядра могут напрямую заменять реализации внимания, устраняя необходимость в ручной компиляции бэкендов внимания, таких как Flash Attention, и ускоряя обучение, просто загрузив соответствующее ядро внимания из Hub.
Вы можете указать ядро при загрузке модели:
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained(
    "your-model-name",
    attn_implementation="kernels-community/flash-attn2"  # other options: kernels-community/vllm-flash-attn3, kernels-community/paged-attention
)
Или при запуске скрипта обучения TRL:
python sft.py ... --attn_implementation kernels-community/flash-attn2
Или с помощью TRL CLI:
trl sft ... --attn_implementation kernels-community/flash-attn2
Теперь вы можете использовать более быстрые бэкенды внимания с предварительно оптимизированным ядром для вашей конфигурации оборудования из Hub, что ускоряет как разработку, так и обучение.
Выбор и фиксация версии ядра
Репозитории ядер на Hub версионируются как ветки (v1, v2, v3, …), и Transformers выбирает версию по умолчанию для каждого репозитория. Эта версия по умолчанию может меняться от одного релиза Transformers к другому, поэтому одно и то же значение attn_implementation не всегда приводит к одной и той же сборке.
Чтобы управлять тем, какая сборка загружается, добавьте ревизию к идентификатору репозитория — ветку версии или SHA коммита:
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained(
    "your-model-name",
    attn_implementation="kernels-community/flash-attn2@v2",  # or a commit SHA to pin an exact build
)
Фиксация версии полезна для обеспечения воспроизводимости процесса обучения и для использования проверенной сборки в случае, если более новая содержит регрессии. Обратите внимание, что каждая версия предоставляет сборки только для определённого диапазона версий Torch и CUDA, поэтому для зафиксированной версии может не существовать варианта, совместимого с вашей средой.
attn_implementation="flash_attention_2"переключается на ядроkernels-community/flash-attn2из Hub, если пакетflash-attnне установлен, поэтому вы можете использовать ядро из Hub, даже не запрашивая его явно.
Сборки
v3для CUDA 12.8 в настоящее время завершаются с ошибкой на этапе обратного распространения для моделей, использующих групповое внимание (grouped-query attention). Если в вашей среде используется эта версия CUDA, зафиксируйте версию@v2, пока не будет закрыт huggingface/kernels-community#1085.
Сравнение реализаций внимания
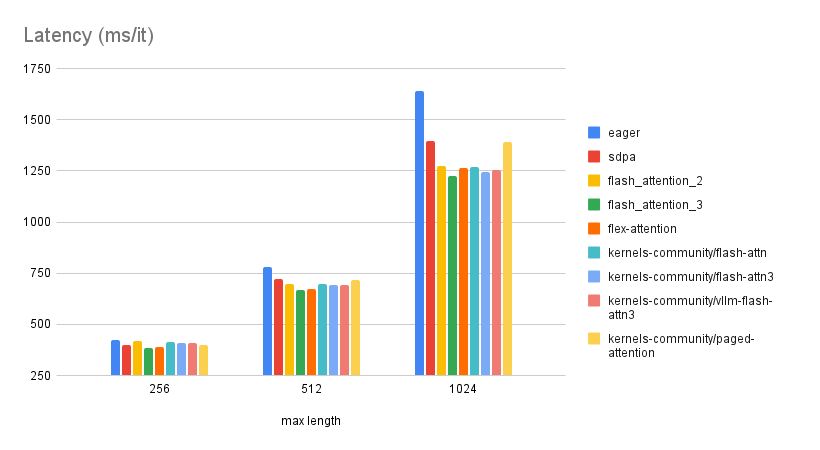
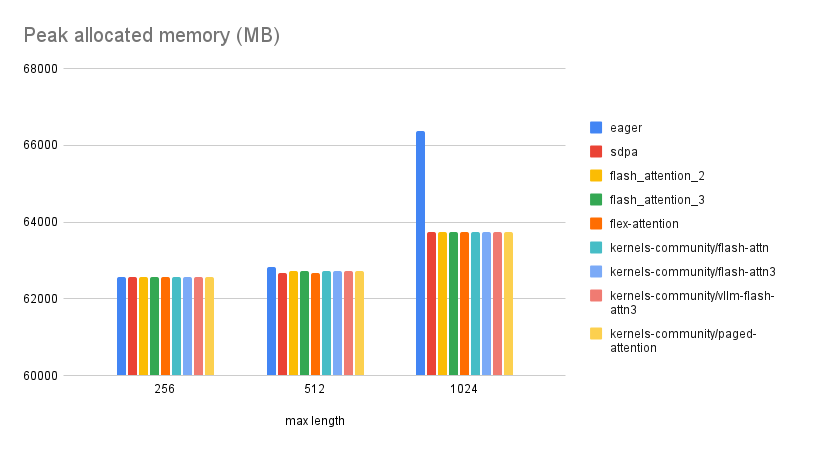
Мы оценили различные реализации внимания, доступные в transformers, а также различные ядра-бэкенды, используя TRL и SFT.
Эксперименты проводились на одном H100 GPU с CUDA 12.9, с использованием Qwen3-8B при batch size of 8, gradient accumulation of 1 и точности bfloat16.
Обратите внимание, что представленные здесь результаты специфичны для данной конфигурации и могут отличаться при других настройках обучения.
На приведённой ниже иллюстрации показаны латентность (время на шаг обучения) и пиковый объём выделенной памяти для различных реализаций внимания и ядерных бэкендов.
Реализации на основе ядер демонстрируют производительность, сопоставимую с производительностью кастомно установленных реализаций внимания, а увеличение max_length модели дополнительно повышает производительность. Потребление памяти во всех реализациях примерно одинаковое, значимых различий не наблюдается. Мы получаем ту же производительность, но с меньшими трудностями, как описано в следующем разделе.
Flash Attention и ядра Hub
Сборка Flash Attention из исходного кода может занять много времени — от нескольких минут до нескольких часов, в зависимости от вашего оборудования, конфигурации CUDA/PyTorch и наличия предварительно скомпилированных колёс.
В отличие от этого, Hugging Face Kernels обеспечивают значительно более быстрый и надежный рабочий процесс. Разработчикам не нужно беспокоиться о сложных настройках — всё выполняется автоматически. В наших бенчмарках ядра были готовы к использованию примерно за 2,5 секунды, без необходимости компиляции. Это позволяет начать обучение практически мгновенно, значительно ускоряя разработку. Просто укажите желаемую версию, и kernels возьмет на себя остальное.