
Transformers documentation
Pemroses gambar
Pemroses gambar
Image processor mengubah gambar menjadi nilai piksel, yaitu tensor yang merepresentasikan warna dan ukuran gambar. Nilai piksel tersebut merupakan input bagi model visi. Untuk memastikan model pretrained menerima input yang benar, image processor dapat melakukan operasi-operasi berikut guna memastikan gambar tersebut persis seperti gambar-gambar yang digunakan saat model di-pretrain.
- center-crop atau resize sebuah gambar
- menormalisasi atau menskalakan ulang nilai piksel
Gunakan from_pretrained() untuk memuat konfigurasi image processor (ukuran gambar, apakah akan menormalisasi dan menskalakan ulang, dll.) dari model vision di Hub Hugging Face atau direktori lokal. Konfigurasi untuk setiap model pretrained disimpan dalam file preprocessor_config.json.
Ketika image processor merupakan bagian dari multimodal processor, konfigurasinya bersarang di processor_config.json alih-alih. Lihat Menyimpan dan memuat processor untuk detailnya.
from transformers import AutoImageProcessor

image_processor = AutoImageProcessor.from_pretrained("google/vit-base-patch16-224")
Lewatkan gambar ke image processor untuk mengubahnya menjadi nilai piksel, dan atur return_tensors="pt" untuk mengembalikan tensor PyTorch. Silakan cetak input untuk melihat bagaimana gambar tersebut terlihat sebagai tensor.
from PIL import Image
import requests

url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/image_processor_example.png"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
inputs = image_processor(image, return_tensors="pt")
Panduan ini membahas kelas pemroses gambar dan cara prapemrosesan gambar untuk model visi.
Kelas pemroses gambar
Image processor menggunakan arsitektur berbasis backend dengan dua backend:
- TorchvisionBackend — implementasi torchvision-backed bawaan. Dipercepat dengan GPU dan hingga 33x lebih cepat daripada backend PIL untuk batch input torch.Tensor. Semua model mendukung backend ini; model yang lebih baru hanya mendukung backend ini.
- PilBackend — alternatif PIL/NumPy. Portabel dan hanya CPU. Hanya tersedia untuk model lama, di mana berguna untuk mereproduksi output numerik persis dari implementasi asli.
Backend aktif pada processor yang dimuat dapat diperiksa melalui atribut backend (misalnya, processor.backend == "torchvision"). Setiap image processor mewarisi ImageProcessingMixin yang menyediakan metode from_pretrained() dan save_pretrained().
Ada dua cara untuk memuat image processor: dengan AutoImageProcessor atau langsung dari kelas yang spesifik untuk model.
API AutoClass menyediakan metode yang praktis untuk memuat image processor tanpa perlu secara langsung menentukan model yang terkait dengan image processor tersebut.
Gunakan from_pretrained() dengan argumen backend untuk memilih backend. Ketika backend diabaikan (default), torchvision dipilih jika terinstal, dan PIL digunakan jika tidak. Perhatikan bahwa backend="pil" hanya didukung untuk model lama; model baru hanya mengekspos backend torchvision.
Untuk kecocokan terdekat dengan pra-pemrosesan pelatihan model, gunakan backend yang ditentukan dalam dokumentasi atau kode pelatihannya. Jika pipeline pelatihan menggunakan PIL dan model mendukung kedua backend, berikan backend="pil". Mengganti backend dapat mengubah nilai piksel yang di-resize, dan pembaruan Pillow atau torchvision juga dapat mengubahnya. Untuk pra-pemrosesan yang dapat direproduksi, pertahankan versi backend dan pustaka gambar tetap.
Seperangkat kecil model lama (Chameleon, Flava, Idefics3, SmolVLM) menggunakan interpolasi Lanczos. Backend default mereka bergantung pada versi torchvision Anda. Dengan torchvision > 0.27, Lanczos didukung secara native dan model-model ini secara default menggunakan torchvision. Versi torchvision yang lebih lama akan kembali ke BICUBIC, sehingga default-nya adalah PIL untuk mempertahankan output asli. Sampaikan
backend="torchvision"secara eksplisit untuk menimpa default.
from transformers import AutoImageProcessor

# Default: picks torchvision if available, otherwise pil
image_processor = AutoImageProcessor.from_pretrained("google/vit-base-patch16-224")

# Explicitly request the torchvision backend
image_processor = AutoImageProcessor.from_pretrained("google/vit-base-patch16-224", backend="torchvision")

# Explicitly request the PIL backend (only for models that support it)
image_processor = AutoImageProcessor.from_pretrained("google/vit-base-patch16-224", backend="pil")
Setiap image processor dikaitkan dengan model visi pretrained tertentu, dan konfigurasinya berisi ukuran yang diharapkan oleh model serta parameter normalisasi.
Muat pemroses backend torchvision langsung dari kelas spesifik model.
from transformers import ViTImageProcessor

image_processor = ViTImageProcessor.from_pretrained("google/vit-base-patch16-224")
Untuk model yang mendukungnya, Anda dapat memuat backend PIL dengan kelas yang berakhiran Pil. Ini berguna ketika Anda membutuhkan kesetaraan numerik yang persis dengan implementasi aslinya.
from transformers import ViTImageProcessorPil

image_processor = ViTImageProcessorPil.from_pretrained("google/vit-base-patch16-224")
Pemroses backend Torchvision
TorchvisionBackend adalah backend default. Pastikan torchvision terinstal, lalu muat dengan backend="torchvision" (atau cukup abaikan backend, karena torchvision dipilih secara otomatis saat tersedia).
from transformers import AutoImageProcessor

processor = AutoImageProcessor.from_pretrained("facebook/detr-resnet-50", backend="torchvision")
Kontrol perangkat tempat pemrosesan dilakukan dengan argumen device. Secara default, pemrosesan dilakukan pada perangkat yang sama dengan input jika input berupa tensor, selain itu akan kembali ke CPU. Contoh di bawah ini menjalankan pemrosesan pada akselerator.
import torch
from torchvision.io import read_image
from transformers import DetrImageProcessor

device = torch.accelerator.current_accelerator().type if torch.accelerator.is_available() else "cpu"

images = read_image("image.jpg")
processor = DetrImageProcessor.from_pretrained("facebook/detr-resnet-50")
images_processed = processor(images, return_tensors="pt", device=device)
Benchmarks
Benchmarks diperoleh dari instance AWS EC2 g5.2xlarge dengan GPU NVIDIA A10G Tensor Core.


Resolusi dinamis
Sebagian besar pemroses gambar mengubah ukuran setiap gambar ke satu resolusi tetap. Resolusi dinamis memungkinkan beberapa model untuk mempertahankan rasio aspek asli dan membiarkan jumlah data pra-pemrosesan bertambah seiring dengan gambar, sehingga foto yang detail mendapatkan lebih banyak patch daripada ikon kecil, dan model mengalokasikan komputasinya di tempat yang ada sesuatu untuk dilihat.
Cara gambar dibagi bersifat spesifik pada model. Beberapa model memotong gambar menjadi sejumlah patch berukuran tetap yang bervariasi, dibatasi oleh parameter seperti min_patches dan max_patches. Model lain mengubah ukuran gambar ke resolusi yang paling sesuai, baik yang dipilih dari daftar rasio aspek yang sudah ditentukan sebelumnya maupun yang diturunkan dari anggaran piksel.
Lihat halaman dokumentasi model untuk parameter, nilai default, dan bentuk outputnya.
Pra-pemrosesan
Model visi Transformers mengharapkan input sebagai tensor PyTorch dari nilai piksel. Pemroses gambar menangani konversi gambar menjadi nilai piksel, yang direpresentasikan oleh ukuran batch, jumlah saluran, tinggi, dan lebar. Untuk mencapai hal ini, gambar di-resize (center crop) dan nilai pikselnya dinormalisasi serta diskalakan ulang ke nilai yang diharapkan oleh model.
Prapemrosesan gambar tidak sama dengan augmentasi gambar. Augmentasi gambar melakukan perubahan (kecerahan, warna, rotasi, dll.) pada gambar dengan tujuan membuat contoh pelatihan baru atau mencegah overfitting. Prapemrosesan gambar melakukan perubahan pada gambar dengan tujuan menyesuaikan format input yang diharapkan oleh model pretrained.
Biasanya, gambar ditingkatkan (untuk meningkatkan kinerja) dan kemudian dipreproses sebelum diteruskan ke model. Anda dapat menggunakan pustaka apa pun (Albumentations, Kornia) untuk peningkatan dan pemroses gambar untuk preproses.
Panduan ini menggunakan modul transforms dari torchvision untuk augmentasi.
Mulai dengan memuat sampel kecil dari dataset food101.
from datasets import load_dataset

dataset = load_dataset("ethz/food101", split="train[:100]")
Dari modul transforms, gunakan API Compose untuk merangkai RandomResizedCrop dan ColorJitter. Transformasi ini secara acak memotong dan mengubah ukuran gambar, serta secara acak menyesuaikan warna gambar.
Ukuran gambar untuk dipotong secara acak dapat diambil dari pemroses gambar. Untuk beberapa model, tinggi dan lebar yang tepat diharapkan, sedangkan untuk model lainnya, hanya shortest_edge yang diperlukan.
from torchvision.transforms import RandomResizedCrop, ColorJitter, Compose

size = (
    image_processor.size["shortest_edge"]
    if "shortest_edge" in image_processor.size
    else (image_processor.size["height"], image_processor.size["width"])
)
_transforms = Compose([RandomResizedCrop(size), ColorJitter(brightness=0.5, hue=0.5)])
Terapkan transformasi pada gambar dan konversikan ke format RGB. Kemudian, lewati gambar yang telah ditingkatkan ke pemroses gambar untuk mengembalikan nilai piksel.
Parameter do_resize diatur ke False karena gambar sudah di-resize pada langkah augmentasi oleh RandomResizedCrop. Jika Anda tidak melakukan augmentasi pada gambar, maka image processor akan secara otomatis melakukan resize dan normalisasi gambar dengan nilai image_mean dan image_std. Nilai-nilai ini dapat ditemukan dalam file konfigurasi preprocessor.
def transforms(examples):
    images = [_transforms(img.convert("RGB")) for img in examples["image"]]
    examples["pixel_values"] = image_processor(images, do_resize=False, return_tensors="pt")["pixel_values"]
    return examples
Terapkan fungsi augmentasi dan pra-pemrosesan gabungan ke seluruh dataset secara langsung dengan set_transform.
dataset.set_transform(transforms)
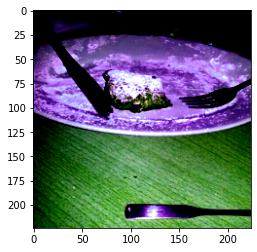
Konversi nilai piksel kembali menjadi gambar untuk melihat bagaimana gambar telah ditingkatkan dan dipreproses.
import numpy as np
import matplotlib.pyplot as plt

img = dataset[0]["pixel_values"]
plt.imshow(img.permute(1, 2, 0))
Untuk tugas visi lainnya seperti deteksi objek atau segmentasi, pemroses gambar mencakup metode pascapemrosesan untuk mengubah output mentah model menjadi prediksi yang bermakna seperti kotak pembatas atau peta segmentasi.
Padding
Beberapa model, seperti DETR, menerapkan scale augmentation selama pelatihan yang dapat menyebabkan gambar dalam satu batch memiliki ukuran yang berbeda. Gambar dengan ukuran yang berbeda tidak dapat di-batch bersama.
Untuk memperbaikinya, tambahkan padding pada gambar dengan token padding khusus 0. Gunakan metode pad untuk menambahkan padding pada gambar, dan definisikan fungsi collate kustom untuk menggabungkan mereka menjadi satu batch.
def collate_fn(batch):
    pixel_values = [item["pixel_values"] for item in batch]
    encoding = image_processor.pad(pixel_values, return_tensors="pt")
    labels = [item["labels"] for item in batch]
    batch = {}
    batch["pixel_values"] = encoding["pixel_values"]
    batch["pixel_mask"] = encoding["pixel_mask"]
    batch["labels"] = labels
    return batch