
Transformers documentation
AWQ
AWQ
Lượng tử hóa trọng số nhận thức kích hoạt (AWQ) giữ lại một phần nhỏ các trọng số quan trọng cho hiệu suất của LLM để nén mô hình xuống 4-bit với mức suy giảm hiệu suất tối thiểu.
Có một số thư viện để lượng tử hóa mô hình bằng thuật toán AWQ, chẳng hạn như llm-awq, autoawq hoặc optimum-intel. Transformers hỗ trợ nạp các mô hình đã được lượng tử hóa bằng thư viện llm-awq và autoawq. Hướng dẫn này sẽ cho bạn thấy cách nạp các mô hình đã được lượng tử hóa bằng autoawq, nhưng quy trình tương tự áp dụng cho các mô hình đã được lượng tử hóa bằng llm-awq.
Chạy lệnh bên dưới để cài đặt autoawq
pip install autoawq
AutoAWQ hạ cấp Transformers xuống phiên bản 4.47.1. Nếu bạn muốn thực hiện suy luận với AutoAWQ, bạn có thể cần cài đặt lại phiên bản Transformers của mình sau khi cài đặt AutoAWQ.
Xác định một mô hình đã được lượng tử hóa AWQ bằng cách kiểm tra khóa quant_method trong tệp config.json của mô hình.
{
  "_name_or_path": "/workspace/process/huggingfaceh4_zephyr-7b-alpha/source",
  "architectures": [
    "MistralForCausalLM"
  ],
  ...
  ...
  ...
  "quantization_config": {
    "quant_method": "awq",
    "zero_point": true,
    "group_size": 128,
    "bits": 4,
    "version": "gemm"
  }
}
Tải mô hình đã lượng tử hóa AWQ bằng from_pretrained(). Thao tác này mặc định tự động đặt các trọng số khác sang fp16 vì lý do hiệu suất. Sử dụng tham số dtype để tải các trọng số khác này ở định dạng khác.
Nếu mô hình được nạp trên CPU, hãy sử dụng tham số device_map để chuyển nó sang bộ tăng tốc.
from transformers import AutoModelForCausalLM, AutoTokenizer
from accelerate import Accelerator
import torch

device = Accelerator().device

model = AutoModelForCausalLM.from_pretrained(
  "TheBloke/zephyr-7B-alpha-AWQ",
  dtype=torch.float32,
  device_map=device
)
Sử dụng attn_implementation để bật FlashAttention2 nhằm tăng tốc suy luận hơn nữa.
from transformers import AutoModelForCausalLM, AutoTokenizer
from accelerate import Accelerator

model = AutoModelForCausalLM.from_pretrained(
  "TheBloke/zephyr-7B-alpha-AWQ",
  attn_implementation="flash_attention_2",
  device_map=Accelerator().device
)
Các module đã hợp nhất
Các module đã hợp nhất (fused) mang lại độ chính xác và hiệu suất được cải thiện. Chúng được hỗ trợ sẵn cho các module AWQ của kiến trúc Llama và Mistral, nhưng bạn cũng có thể hợp nhất các module AWQ cho các kiến trúc không được hỗ trợ.
Các module đã hợp nhất không thể kết hợp với các kỹ thuật tối ưu hóa khác như FlashAttention2.
Tạo một AwqConfig và đặt các tham số fuse_max_seq_len và do_fuse=True để bật các module đã hợp nhất. Tham số fuse_max_seq_len là tổng độ dài chuỗi và nó phải bao gồm độ dài ngữ cảnh và độ dài sinh dự kiến. Đặt nó thành một giá trị lớn hơn để an toàn.
Ví dụ dưới đây hợp nhất các module AWQ của model TheBloke/Mistral-7B-OpenOrca-AWQ.
import torch
from transformers import AwqConfig, AutoModelForCausalLM

quantization_config = AwqConfig(
    bits=4,
    fuse_max_seq_len=512,
    do_fuse=True,
)
model = AutoModelForCausalLM.from_pretrained(
  "TheBloke/Mistral-7B-OpenOrca-AWQ",
  quantization_config=quantization_config
).to(0)
Mô hình TheBloke/Mistral-7B-OpenOrca-AWQ đã được chạy benchmark với batch_size=1, cả khi có lẫn khi không có các module đã được hợp nhất.
| Kích thước lô | Chiều dài Prefill | Chiều dài giải mã | Token prefill/giây | Giải mã token/giây | Bộ nhớ (VRAM) |
|---|---|---|---|---|---|
| 1 | 32 | 32 | 60.0984 | 38.4537 | 4,50 GB (5,68%) |
| 1 | 64 | 64 | 1333.67 | 31.6604 | 4,50 GB (5,68%) |
| 1 | 128 | 128 | 2434.06 | 31.6272 | 4,50 GB (5,68%) |
| 1 | 256 | 256 | 3072.26 | 38.1731 | 4,50 GB (5,68%) |
| 1 | 512 | 512 | 3184.74 | 31.6819 | 4,59 GB (5,80%) |
| 1 | 1024 | 1024 | 3148.18 | 36.8031 | 4,81 GB (6,07%) |
| 1 | 2048 | 2048 | 2927.33 | 35.2676 | 5,73 GB (7,23%) |
| Kích thước lô | Chiều dài Prefill | Chiều dài giải mã | Token prefill/giây | Giải mã token/giây | Bộ nhớ (VRAM) |
|---|---|---|---|---|---|
| 1 | 32 | 32 | 81.4899 | 80.2569 | 4,00 GB (5,05%) |
| 1 | 64 | 64 | 1756.1 | 106.26 | 4,00 GB (5,05%) |
| 1 | 128 | 128 | 2479.32 | 105.631 | 4,00 GB (5,06%) |
| 1 | 256 | 256 | 1813.6 | 85.7485 | 4,01 GB (5,06%) |
| 1 | 512 | 512 | 2848.9 | 97.701 | 4,11 GB (5,19%) |
| 1 | 1024 | 1024 | 3044.35 | 87.7323 | 4,41 GB (5,57%) |
| 1 | 2048 | 2048 | 2715.11 | 89.4709 | 5,57 GB (7,04%) |
Tốc độ và thông lượng của các module đã hợp nhất và chưa hợp nhất cũng được kiểm tra bằng thư viện optimum-benchmark.
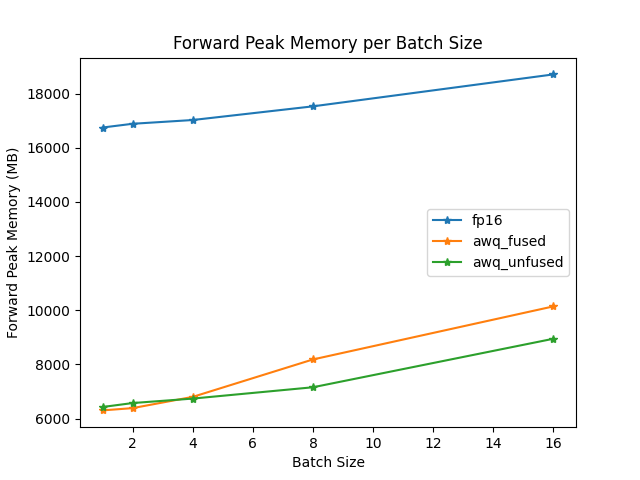
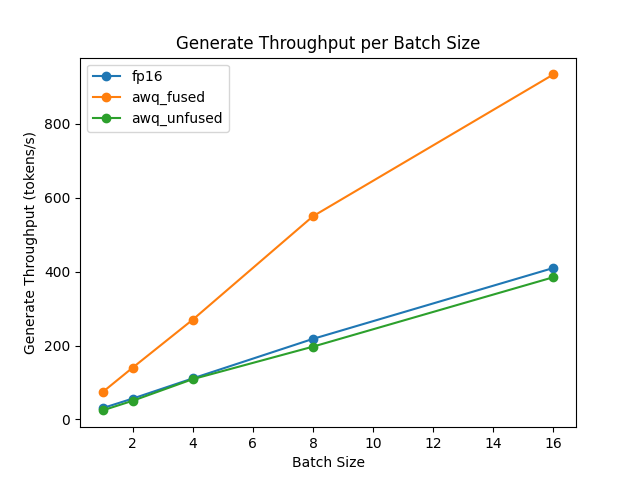
Đối với các kiến trúc không hỗ trợ các module đã hợp nhất, hãy tạo một AwqConfig và định nghĩa ánh xạ hợp nhất tùy chỉnh trong modules_to_fuse để xác định các module cần được hợp nhất.
Ví dụ dưới đây hợp nhất các module AWQ của model TheBloke/Yi-34B-AWQ.
import torch
from transformers import AwqConfig, AutoModelForCausalLM

quantization_config = AwqConfig(
    bits=4,
    fuse_max_seq_len=512,
    modules_to_fuse={
        "attention": ["q_proj", "k_proj", "v_proj", "o_proj"],
        "layernorm": ["ln1", "ln2", "norm"],
        "mlp": ["gate_proj", "up_proj", "down_proj"],
        "use_alibi": False,
        "num_attention_heads": 56,
        "num_key_value_heads": 8,
        "hidden_size": 7168
    }
)

model = AutoModelForCausalLM.from_pretrained(
  "TheBloke/Yi-34B-AWQ",
  quantization_config=quantization_config
).to(0)
Tham số modules_to_fuse nên bao gồm các khóa sau.
"attention": Tên của các lớp attention cần hợp nhất theo thứ tự sau: lớp chiếu query, key, value và output. Nếu bạn không muốn hợp nhất các lớp này, hãy truyền vào một danh sách rỗng."layernorm": Tên của tất cả các lớp LayerNorm mà bạn muốn thay thế bằng một lớp LayerNorm đã được hợp nhất tùy chỉnh. Nếu bạn không muốn hợp nhất các lớp này, hãy truyền vào một danh sách rỗng."mlp": Tên của các lớp MLP mà bạn muốn hợp nhất thành một lớp MLP duy nhất theo thứ tự: (lớp gate (dense, layer, post-attention) / lớp up / lớp down)."use_alibi": Nếu mô hình của bạn sử dụng nhúng vị trí ALiBi."num_attention_heads": Số lượng đầu chú ý."num_key_value_heads": Số lượng key value heads cần được sử dụng để triển khai Grouped Query Attention (GQA).giá trị tham số attention num_key_value_heads=num_attention_headsChú ý đa đầu num_key_value_heads=1Chú ý đa truy vấn num_key_value_heads=...Chú ý truy vấn nhóm "hidden_size": Kích thước của các biểu diễn ẩn.
ExLlamaV2
ExLlamaV2 kernels hỗ trợ prefill và decoding nhanh hơn. Chạy lệnh bên dưới để cài đặt phiên bản mới nhất của autoawq với hỗ trợ ExLlamaV2.
pip install git+https://github.com/casper-hansen/AutoAWQ.git
Đặt version="exllama" trong AwqConfig để bật các kernel ExLlamaV2.
ExLlamaV2 được hỗ trợ trên GPU AMD.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, AwqConfig

quantization_config = AwqConfig(version="exllama")

model = AutoModelForCausalLM.from_pretrained(
    "TheBloke/Mistral-7B-Instruct-v0.1-AWQ",
    quantization_config=quantization_config,
    device_map="auto",
)
Tài nguyên
Chạy notebook demo AWQ để xem thêm các ví dụ về cách lượng tử hóa một mô hình, đẩy mô hình đã lượng tử hóa lên Hub, và nhiều hơn nữa.
Update on GitHub