
Transformers documentation
InstructBlipVideo
Эта модель была опубликована в HF papers 11 мая 2023 года и добавлена в Hugging Face Transformers 25 июня 2024 года.


InstructBlipVideo
Обзор
InstructBLIPVideo — это расширение моделей, предложенных в работе InstructBLIP: Towards General-purpose Vision-Language Models with Instruction Tuning авторов Wenliang Dai, Junnan Li, Dongxu Li, Anthony Meng Huat Tiong, Junqi Zhao, Weisheng Wang, Boyang Li, Pascale Fung, Steven Hoi. InstructBLIPVideo использует ту же архитектуру, что и InstructBLIP, и работает с теми же контрольными точками, что и InstructBLIP. Единственное отличие — возможность обработки видео.
Аннотация из статьи следующая:
Универсальные языковые модели, способные решать различные задачи в области обработки естественного языка, появились благодаря конвейеру предварительного обучения и обучения по инструкциям. Однако создание универсальных моделей «зрение-язык» представляет собой сложную задачу из-за повышенной рассогласованности задач, вносимой дополнительным визуальным входом. Хотя предварительное обучение моделей «зрение-язык» широко изучалось, обучение по инструкциям для таких моделей остаётся относительно малоизученной областью. В данной работе мы проводим систематическое и комплексное исследование обучения по инструкциям для моделей «зрение-язык» на основе предварительно обученных моделей BLIP-2. Мы собрали широкий набор из 26 общедоступных наборов данных, преобразовали их в формат обучения по инструкциям и разбили на две группы: для обучения по инструкциям (held-in) и для zero-shot оценки (held-out). Кроме того, мы предлагаем метод извлечения визуальных признаков с учётом инструкций (instruction-aware visual feature extraction), который является ключевым для возможности модели извлекать информативные признаки, адаптированные к заданной инструкции. Полученные модели InstructBLIP демонстрируют наилучшие zero-shot результаты на всех 13 наборах данных из группы held-out, значительно превосходя BLIP-2 и более крупную модель Flamingo. Наши модели также обеспечивают наилучшие результаты при дообучении на отдельных задачах нижнего уровня (например, точность 90,7% на ScienceQA IMG). Наконец, мы качественно демонстрируем преимущества InstructBLIP перед современными мультимодальными моделями.
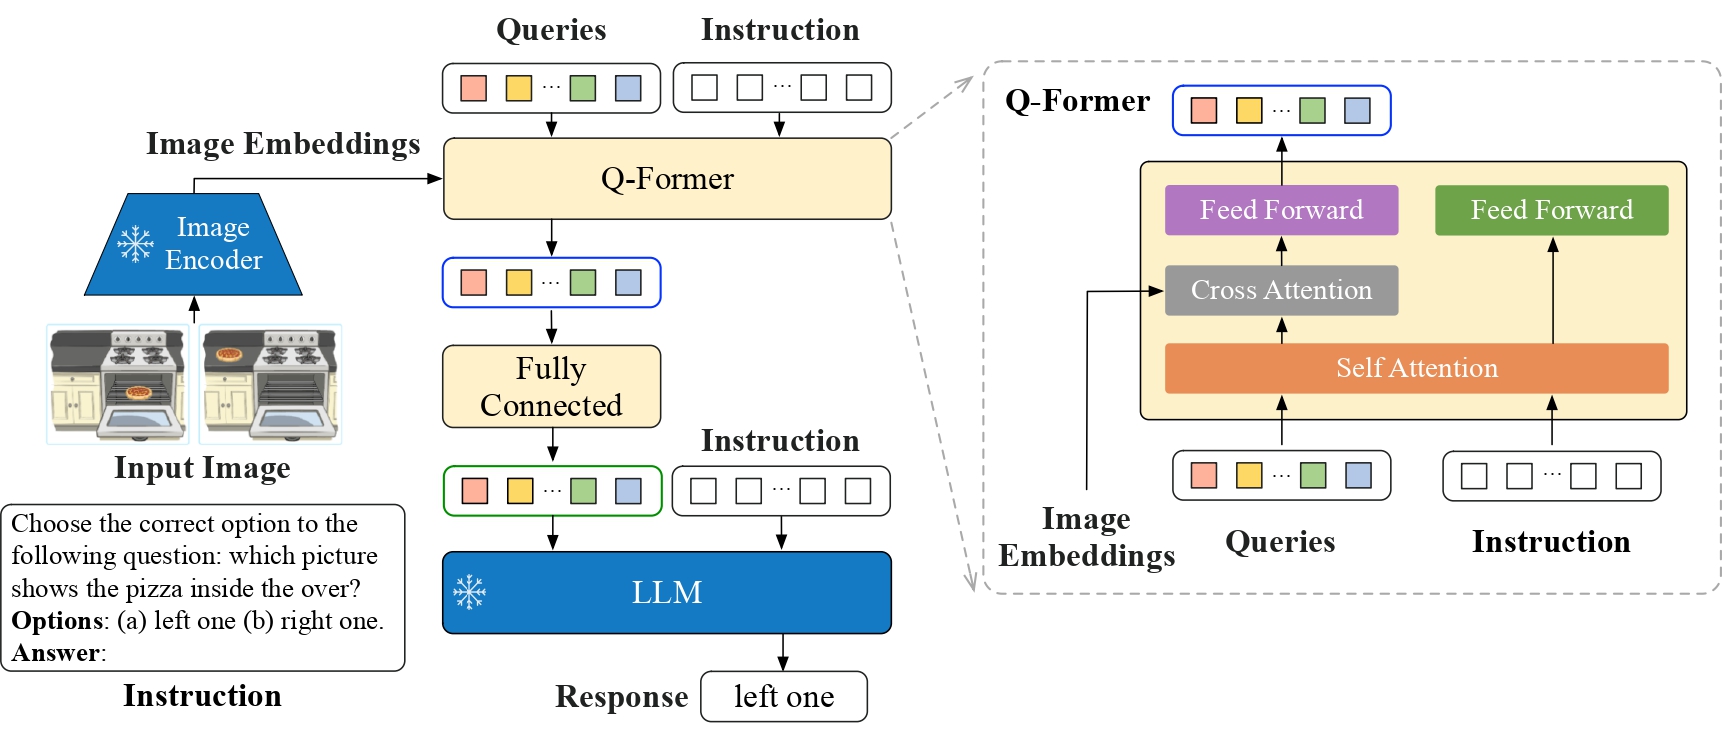 InstructBLIPVideo architecture. Taken from the original paper.
Эта модель была предоставлена RaushanTurganbay. Исходный код можно найти здесь.
Советы по использованию
- Модель обучалась с выборкой 4 кадров на видео, поэтому рекомендуется выбирать 4 кадра
Модели BLIP, выпущенные после версии v4.46, будут выдавать предупреждения о необходимости добавить
processor.num_query_tokens = {{num_query_tokens}}и расширить слой эмбеддингов модели для добавления специального токена<image>. Если вы являетесь владельцем контрольной точки модели, настоятельно рекомендуется добавить эти атрибуты в процессор; если же модель вам не принадлежит, создайте PR. Добавление этих атрибутов означает, что BLIP будет добавлять количество токенов запроса, необходимых на каждое изображение, и расширять текст, добавляя столько плейсхолдеров<image>, сколько будет токенов запроса. Обычно это около 500 токенов на изображение, поэтому убедитесь, что текст не обрезается, иначе при слиянии эмбеддингов произойдет сбой. Атрибуты можно получить из конфигурации модели какmodel.config.num_query_tokens, а расширение эмбеддингов модели выполняется по этой ссылке.
InstructBlipVideoConfig
класс transformers.InstructBlipVideoConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneqformer_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonetext_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonenum_query_tokens: int = 32initializer_factor: float = 1.0initializer_range: float = 0.02video_token_index: int | None = None )
Параметры
- vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], необязательный) — Объект конфигурации или словарь конфигурации визуального бэкбона. - qformer_config (
dict, необязательный) — Словарь параметров конфигурации, используемых для инициализации InstructBlipVideoQFormerConfig. - text_config (
Union[dict, ~configuration_utils.PreTrainedConfig], необязательный) — Объект конфигурации или словарь конфигурации текстового бэкбона. - num_query_tokens (
int, необязательный, по умолчанию 32) — Количество токенов запроса, передаваемых через Transformer. - initializer_factor (
float, необязательный, по умолчанию1.0) — Коэффициент для инициализации всех матриц весов (должен оставаться равным 1, используется внутренне для тестирования инициализации). - initializer_range (
float, необязательный, по умолчанию0.02) — Стандартное отклонение truncated_normal_initializer, используемое для инициализации всех матриц весов. - video_token_index (
int, необязательный) — Индекс токена видео, используемый в качестве плейсхолдера для входных видео.
Это класс конфигурации для хранения настроек модели InstructBlipVideoModel. Он используется для создания модели Instructblipvideo в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации модели Salesforce/instructblip-flan-t5-xl.
Объекты конфигурации наследуются от PreTrainedConfig и могут использоваться для управления выводами модели. Подробнее читайте в документации PreTrainedConfig.
Пример:
>>> from transformers import (
...     InstructBlipVideoVisionConfig,
...     InstructBlipVideoQFormerConfig,
...     OPTConfig,
...     InstructBlipVideoConfig,
...     InstructBlipVideoForConditionalGeneration,
... )

>>> # Initializing a InstructBlipVideoConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVideoConfig()

>>> # Initializing a InstructBlipVideoForConditionalGeneration (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVideoForConditionalGeneration(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config

>>> # We can also initialize a InstructBlipVideoConfig from a InstructBlipVideoVisionConfig, InstructBlipVideoQFormerConfig and any PreTrainedConfig

>>> # Initializing Instructblipvideo vision, Instructblipvideo Q-Former and language model configurations
>>> vision_config = InstructBlipVideoVisionConfig()
>>> qformer_config = InstructBlipVideoQFormerConfig()
>>> text_config = OPTConfig()

>>> config = InstructBlipVideoConfig(vision_config=vision_config, qformer_config=qformer_config, text_config=text_config)
InstructBlipVideoVisionConfig
класс transformers.InstructBlipVideoVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 1408intermediate_size: int = 6144num_hidden_layers: int = 39num_attention_heads: int = 16image_size: int | list[int] | tuple[int, int] = 224patch_size: int | list[int] | tuple[int, int] = 14hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06attention_dropout: float | int = 0.0initializer_range: float = 1e-10qkv_bias: bool = True )
Параметры
- hidden_size (
int, необязательный, по умолчанию1408) — Размерность скрытых представлений. - intermediate_size (
int, необязательный, по умолчанию6144) — Размерность представлений MLP. - num_hidden_layers (
int, необязательный, по умолчанию39) — Количество скрытых слоев в декодере Transformer. - num_attention_heads (
int, необязательный, по умолчанию16) — Количество головок внимания в каждом слое внимания декодера Transformer. - image_size (
Union[int, list[int], tuple[int, int]], необязательный, по умолчанию224) — Размер (разрешение) каждого изображения. - patch_size (
Union[int, list[int], tuple[int, int]], необязательный, по умолчанию14) — Размер (разрешение) каждого патча. - hidden_act (
str, необязательный, по умолчаниюgelu) — Нелинейная функция активации (функция или строка) в декодере. Например,"gelu","relu","silu"и т. д. - layer_norm_eps (
float, необязательный, по умолчанию1e-06) — Значение epsilon, используемое слоями нормализации. - attention_dropout (
Union[float, int], необязательный, по умолчанию0.0) — Коэффициент dropout для вероятностей внимания. - initializer_range (
float, необязательный, по умолчанию1e-10) — Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов. - qkv_bias (
bool, необязательный, по умолчаниюTrue) — Добавлять ли смещение к запросам, ключам и значениям.
Это класс конфигурации для хранения настроек модели InstructBlipVideoModel. Он используется для создания модели Instructblipvideo в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации модели Salesforce/instructblip-flan-t5-xl.
Объекты конфигурации наследуются от PreTrainedConfig и могут использоваться для управления выводами модели. Подробнее читайте в документации PreTrainedConfig.
Пример:
>>> from transformers import InstructBlipVideoVisionConfig, InstructBlipVideoVisionModel

>>> # Initializing a InstructBlipVideoVisionConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVideoVisionConfig()

>>> # Initializing a InstructBlipVideoVisionModel (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVideoVisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
InstructBlipVideoQFormerConfig
класс transformers.InstructBlipVideoQFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 30522hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.1attention_probs_dropout_prob: float | int = 0.1max_position_embeddings: int = 512initializer_range: float = 0.02layer_norm_eps: float = 1e-12pad_token_id: int | None = 0cross_attention_frequency: int = 2encoder_hidden_size: int = 1408 )
Параметры
- vocab_size (
int, необязательный, по умолчанию30522) — Размер словаря модели. Определяет количество различных токенов, которые могут быть представлены вinput_ids. - hidden_size (
int, необязательный, по умолчанию768) — Размерность скрытых представлений. - num_hidden_layers (
int, необязательный, по умолчанию12) — Количество скрытых слоев в декодере Transformer. - num_attention_heads (
int, необязательный, по умолчанию12) — Количество головок внимания в каждом слое внимания декодера Transformer. - intermediate_size (
int, необязательный, по умолчанию3072) — Размерность представлений MLP. - hidden_act (
str, необязательный, по умолчаниюgelu) — Нелинейная функция активации (функция или строка) в декодере. Например,"gelu","relu","silu"и т. д. - hidden_dropout_prob (
Union[float, int], необязательный, по умолчанию0.1) — Вероятность dropout для всех полносвязных слоёв в блоках эмбеддингов, энкодера и пулера. - attention_probs_dropout_prob (
Union[float, int], необязательный, по умолчанию0.1) — Коэффициент dropout для вероятностей внимания. - max_position_embeddings (
int, необязательный, по умолчанию512) — Максимальная длина последовательности, с которой может использоваться эта модель. - initializer_range (
float, необязательный, по умолчанию0.02) — Стандартное отклонение truncated_normal_initializer, используемое для инициализации всех матриц весов. - layer_norm_eps (
float, необязательный, по умолчанию1e-12) — Значение epsilon, используемое слоями нормализации. - pad_token_id (
int, необязательный, по умолчанию0) — Идентификатор токена, используемого для дополнения (padding) в словаре. - cross_attention_frequency (
int, необязательный, по умолчанию 2) — Частота добавления кросс-внимания в слои Transformer. - encoder_hidden_size (
int, необязательный, по умолчанию 1408) — Размер скрытых состояний для кросс-внимания.
Это класс конфигурации для хранения настроек модели InstructBlipVideoModel. Он используется для создания модели Instructblipvideo в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации модели Salesforce/instructblip-flan-t5-xl
Объекты конфигурации наследуются от PreTrainedConfig и могут использоваться для управления выводами модели. Подробнее читайте в документации PreTrainedConfig.
Примеры:
>>> from transformers import InstructBlipVideoQFormerConfig, InstructBlipVideoQFormerModel

>>> # Initializing a InstructBlipVideo Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVideoQFormerConfig()

>>> # Initializing a model (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVideoQFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
InstructBlipVideoProcessor
класс transformers.InstructBlipVideoProcessor
< source >( video_processortokenizerqformer_tokenizernum_query_tokens = None**kwargs )
Параметры
- video_processor (
InstructBlipVideoVideoProcessor) — Обработчик видео является обязательным входным параметром. - tokenizer (
GPT2Tokenizer) — Токенизатор является обязательным входным параметром. - qformer_tokenizer (
AutoTokenizer) — Экземпляр [‘PreTrainedTokenizer`]. Токенизатор Q-Former является обязательным входным параметром. - num_query_tokens (
int, необязательный) — Количество токенов, используемых Qformer в качестве запросов; должно совпадать со значением в конфигурации модели.
Создаёт InstructBlipVideoProcessor, который объединяет видео-процессор, токенизатор и qformer-токенизатор в единый процессор.
InstructBlipVideoProcessor предоставляет все возможности InstructBlipVideoVideoProcessor, GPT2Tokenizer и {qformer_tokenizer_class}. Подробнее см. в ~InstructBlipVideoVideoProcessor, ~GPT2Tokenizer и ~{qformer_tokenizer_class}.
InstructBlipVideoVideoProcessor
класс transformers.InstructBlipVideoVideoProcessor
< source >( **kwargs: *<class 'transformers.processing_utils.VideosKwargs'> )
Параметры
- do_convert_rgb (
bool, kwargs, optional, по умолчаниюTrue) — Следует ли преобразовать изображение в RGB. - do_resize (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, нужно ли изменять размер изображения. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, по умолчанию{'height' -- 384, 'width': 384}): Определяет максимальные размеры входных данных для модели. - default_to_square (
bool, kwargs, optional, по умолчаниюTrue) — Определяет, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задано как int. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, по умолчанию3) — Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисленияPILImageResampling. Влияет только в том случае, еслиdo_resizeустановлено вTrue. - do_rescale (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, следует ли выполнять рескейлинг изображения. - rescale_factor (
float, kwargs, optional, по умолчанию0.00392156862745098) — Коэффициент масштабирования, применяемый к изображению, еслиdo_rescaleустановлен вTrue. - do_normalize (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, следует ли нормализовать изображение. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional, по умолчанию[0.48145466, 0.4578275, 0.40821073]) — Среднее значение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional, по умолчанию[0.26862954, 0.26130258, 0.27577711]) — Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - do_center_crop (
bool, kwargs, optional) — Выполнять ли центрированную обрезку изображения. - do_pad (
bool, kwargs, optional) — Определяет, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия выравнивания зависит от модели. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер выходного изображения после примененияcenter_crop. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Поддерживается толькоChannelDimension.FIRST. Добавлено для совместимости с медленными процессорами. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, необязательный) — Формат размерности каналов для входного изображения. Если не задан, формат размерности каналов выводится из входного изображения. Может быть одним из:"channels_first"илиChannelDimension.FIRST: изображение в формате (num_channels, height, width)."channels_last"илиChannelDimension.LAST: изображение в формате (высота, ширина, число каналов)."none"илиChannelDimension.NONE: изображение в формате (height, width).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Устройство, на котором будут обрабатываться видео. Если не задано, устройство определяется на основе входных видео. - do_sample_frames (
bool, kwargs, optional, по умолчаниюFalse) — Следует ли извлекать кадры из видео перед обработкой или обрабатывать видео целиком. - video_metadata (
Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None], kwargs) — Метаданные видео, содержащие информацию о общей длительности, fps и общем количестве кадров. Будут использоваться для выборки кадров из видео или вычисления временных меток. Не передавайте метаданные, если не пытаетесь декодировать видео вручную перед обработкой - fps (
Annotated[int | float | None, None], kwargs) — Целевое количество кадров для выборки в секунду приdo_sample_frames=True. - num_frames (
Annotated[int | None, None], kwargs) — Максимальное количество кадров для выборки приdo_sample_frames=True. - return_metadata (
bool, kwargs, optional, по умолчаниюFalse) — Указывает, следует ли возвращать метаданные видео. Метаданные видео — это объект, содержащий информацию о длительности видео, частоте кадров (fps), используемом бэкенде декодирования и т. д. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Если задано, возвращает тензоры конкретного фреймворка. Допустимые значения:'pt': возвращает объектыtorch.TensorPyTorch.'np': возвращает объекты NumPynp.ndarray.
- **kwargs (VideosKwargs, optional) — Дополнительные параметры обработки для каждой модальности (текст, изображения, видео, аудио). Специфичные для модели параметры перечислены выше; полный список поддерживаемых аргументов см. в классе TypedDict.
Создаёт видеопроцессор InstructBlipVideoVideoProcessor.
preprocess
< source >( videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]]]**kwargs: *<class 'transformers.processing_utils.VideosKwargs'> ) → ~image_processing_base.BatchFeature
Параметры
- videos (
Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]) — Видео для предобработки. Ожидается одно видео или батч видео со значениями пикселей в диапазоне от 0 до 255. Если передаются видео со значениями пикселей в диапазоне от 0 до 1, установитеdo_rescale=False. - do_convert_rgb (
bool, kwargs, optional) — Следует ли преобразовать изображение в RGB. - do_resize (
bool, kwargs, optional) — Указывает, нужно ли изменить размер изображения. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Описывает максимальные размеры входных данных для модели. - default_to_square (
bool, kwargs, optional) — Определяет, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size является целым числом. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисленияPILImageResampling. Влияет только в том случае, еслиdo_resizeустановлено вTrue. - do_rescale (
bool, kwargs, optional) — Нужно ли перемасштабировать изображение. - rescale_factor (
float, kwargs, optional) — Коэффициент масштабирования, применяемый к изображению, еслиdo_rescaleустановлен вTrue. - do_normalize (
bool, kwargs, optional) — Нужно ли нормализовать изображение. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — Среднее значение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - do_center_crop (
bool, kwargs, optional) — Выполнять ли центрированную обрезку изображения. - do_pad (
bool, kwargs, optional) — Определяет, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия выравнивания зависит от модели. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер выходного изображения после примененияcenter_crop. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Поддерживается толькоChannelDimension.FIRST. Добавлено для совместимости с медленными процессорами. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, необязательный) — Формат размерности каналов для входного изображения. Если не задан, формат размерности каналов выводится из входного изображения. Может быть одним из:"channels_first"илиChannelDimension.FIRST: изображение в формате (num_channels, height, width)."channels_last"илиChannelDimension.LAST: изображение в формате (высота, ширина, число каналов)."none"илиChannelDimension.NONE: изображение в формате (height, width).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Устройство, на котором будут обрабатываться видео. Если не задано, устройство определяется на основе входных видео. - do_sample_frames (
bool, kwargs, optional) — Следует ли извлекать кадры из видео перед обработкой или обрабатывать видео целиком. - video_metadata (
Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None], kwargs) — Метаданные видео, содержащие информацию о общей длительности, fps и общем количестве кадров. Будут использоваться для выборки кадров из видео или вычисления временных меток. Не передавайте метаданные, если не пытаетесь декодировать видео вручную перед обработкой - fps (
Annotated[int | float | None, None], kwargs) — Целевое количество кадров для выборки в секунду приdo_sample_frames=True. - num_frames (
Annotated[int | None, None], kwargs) — Максимальное количество кадров для выборки приdo_sample_frames=True. - return_metadata (
bool, kwargs, optional) — Указывает, следует ли возвращать метаданные видео. Метаданные видео — это объект, содержащий информацию о длительности видео, частоте кадров (fps), используемом бэкенде декодирования и т. д. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Возвращает стопку тензоров, если установлено значение'pt', иначе возвращает список тензоров.
Возвращает
~image_processing_base.BatchFeature
- data (
dict) — Словарь списков/массивов/тензоров, возвращаемый методом call (‘pixel_values’ и т. д.). - tensor_type (
Union[None, str, TensorType], необязательный) — Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
InstructBlipVideoVisionModel
класс transformers.InstructBlipVideoVisionModel
< source >( config: InstructBlipVideoVisionConfig )
forward
< source >( pixel_values: typing.Optional[torch.FloatTensor] = Noneinterpolate_pos_encoding: bool = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.FloatTensor)
Параметры
- pixel_values (
torch.FloatTensorформы(batch_size, num_channels, image_size, image_size), необязательный) — Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощьюimage_processor_class. Подробности см. вimage_processor_class.__call__(InstructBlipVideoProcessor используетimage_processor_classдля обработки изображений). - interpolate_pos_encoding (
bool, необязательный, по умолчаниюFalse) — Указывает, следует ли интерполировать предобученные позиционные кодировки.
Возвращает
BaseModelOutputWithPooling или tuple(torch.FloatTensor)
Объект BaseModelOutputWithPooling или кортеж
torch.FloatTensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (InstructBlipVideoConfig) и входных данных.
Метод forward модели InstructBlipVideoVisionModel переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
last_hidden_state (
torch.FloatTensorформы(batch_size, sequence_length, hidden_size)) — Последовательность скрытых состояний на выходе последнего слоя модели.pooler_output (
torch.FloatTensorформы(batch_size, hidden_size)) — Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки через линейный слой и функцию активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.hidden_states (
tuple(torch.FloatTensor), необязательный, возвращается, если переданоoutput_hidden_states=Trueили еслиconfig.output_hidden_states=True) — кортеж изtorch.FloatTensor(один для вывода слоя встраиваний, если модель имеет такой слой, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
attentions (
tuple(torch.FloatTensor), необязательный, возвращается, если переданоoutput_attentions=Trueили еслиconfig.output_attentions=True) — Кортежtorch.FloatTensor(по одному для каждого слоя) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
InstructBlipVideoQFormerModel
класс transformers.InstructBlipVideoQFormerModel
< source >( config: InstructBlipVideoQFormerConfig )
Querying Transformer (Q-Former), используемый в InstructBlipVideo. Небольшая модификация BLIP-2, так как он также принимает инструкцию в качестве входных данных.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.FloatTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonequery_embeds: typing.Optional[torch.Tensor] = Noneencoder_hidden_states: typing.Optional[torch.FloatTensor] = Noneencoder_attention_mask: typing.Optional[torch.FloatTensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPoolingAndCrossAttentions or tuple(torch.FloatTensor)
Параметры
- input_ids (
torch.LongTensorформы(batch_size, sequence_length)) — Индексы токенов входной последовательности в словаре. По умолчанию токены отсечки (padding) игнорируются.Индексы можно получить с помощью AutoTokenizer. Подробности см. в PreTrainedTokenizer.encode() и PreTrainedTokenizer.call().
- attention_mask (
torch.FloatTensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения токенов-заполнителей из внимания. Значения маски из диапазона[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
- position_ids (
torch.LongTensorформы(batch_size, sequence_length), , необязательный) — Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона[0, config.n_positions - 1]. - query_embeds (
torch.FloatTensorс формой(batch_size, sequence_length, hidden_size)) — Скрытые состояния, используемые в вычислении внимания. При кросс-внимании используются в качестве запроса (т. е. для ключа и значения применяются encoder_hidden_states). - encoder_hidden_states (
torch.FloatTensorформы(batch_size, sequence_length, hidden_size), необязательный) — Последовательность скрытых состояний на выходе последнего слоя энкодера. Используется в кросс-внимании, если модель настроена как декодер. - encoder_attention_mask (
torch.FloatTensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения внимания к индексам токенов заполнения во входных данных энкодера. Эта маска используется в кросс-внимании, если модель настроена как декодер. Значения маски выбираются из[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
Возвращает
BaseModelOutputWithPoolingAndCrossAttentions или tuple(torch.FloatTensor)
Объект BaseModelOutputWithPoolingAndCrossAttentions или кортеж
torch.FloatTensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (InstructBlipVideoConfig) и входных данных.
Метод forward модели InstructBlipVideoQFormerModel переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
last_hidden_state (
torch.FloatTensorформы(batch_size, sequence_length, hidden_size)) — Последовательность скрытых состояний на выходе последнего слоя модели.pooler_output (
torch.FloatTensorформы(batch_size, hidden_size)) — Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки через линейный слой и функцию активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.hidden_states (
tuple(torch.FloatTensor), необязательный, возвращается, если переданоoutput_hidden_states=Trueили еслиconfig.output_hidden_states=True) — кортеж изtorch.FloatTensor(один для вывода слоя встраиваний, если модель имеет такой слой, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
attentions (
tuple(torch.FloatTensor), необязательный, возвращается, если переданоoutput_attentions=Trueили еслиconfig.output_attentions=True) — Кортежtorch.FloatTensor(по одному для каждого слоя) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
cross_attentions (
tuple(torch.FloatTensor), необязательный, возвращается, если переданоoutput_attentions=Trueиconfig.add_cross_attention=Trueили еслиconfig.output_attentions=True) — Кортежtorch.FloatTensor(по одному для каждого слоя) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания кросс-внимания декодера после softmax внимания, используемые для вычисления взвешенного среднего в головах кросс-внимания.
past_key_values (
Cache, необязательный, возвращается при передачеuse_cache=Trueили когдаconfig.use_cache=True) — это экземпляр Cache. Подробнее см. в нашем руководстве по кэшу kv.Содержит предварительно вычисленные скрытые состояния (ключи и значения в блоках само-внимания и, при необходимости, если
config.is_encoder_decoder=True, в блоках кросс-внимания), которые можно использовать (см. входной параметрpast_key_values) для ускорения последовательного декодирования.
InstructBlipVideoModel
класс transformers.InstructBlipVideoModel
< source >( config: InstructBlipVideoConfig )
Параметры
- config (InstructBlipVideoConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация по файлу конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Используйте метод from_pretrained() для загрузки весов модели.
Базовая модель InstructBlipVideo, состоящая из языковой модели, qformer и визуального энкодера.
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( pixel_values: FloatTensorqformer_input_ids: FloatTensorqformer_attention_mask: typing.Optional[torch.LongTensor] = Noneinput_ids: typing.Optional[torch.FloatTensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Nonedecoder_input_ids: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool = Falseuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → InstructBlipVideoForConditionalGenerationModelOutput or tuple(torch.FloatTensor)
Параметры
- pixel_values (
torch.FloatTensorформы(batch_size, num_channels, image_size, image_size)) — Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощьюimage_processor_class. Подробности см. вimage_processor_class.__call__(InstructBlipVideoProcessor используетimage_processor_classдля обработки изображений). - qformer_input_ids (
torch.LongTensorформы(batch_size, sequence_length), необязательный) — Индексы токенов входной последовательности в словаре Q-Former. Входные токены могут быть переданы необязательно в качестве текстового промпта, который модель Q-Former закодирует.Индексы можно получить с помощью InstructBlipVideoProcessor. Подробности см. в
InstructBlipVideoProcessor.__call__(). - qformer_attention_mask (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения токенов-заполнителей из внимания. Значения маски из диапазона[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
- input_ids (
torch.FloatTensorформы(batch_size, sequence_length), , необязательный) — Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется.Индексы можно получить с помощью AutoTokenizer. Подробности см. в PreTrainedTokenizer.encode() и PreTrainedTokenizer.call().
- attention_mask (
torch.LongTensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения токенов-заполнителей из внимания. Значения маски из диапазона[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
- decoder_input_ids (
torch.LongTensorформы(batch_size, target_sequence_length), необязательный) — Индексы токенов входной последовательности декодера в словаре. Индексы можно получить с помощью AutoTokenizer. Подробности — в PreTrainedTokenizer.encode() и PreTrainedTokenizer.call(). Что такое decoder input IDs?Индексы можно получить с помощью AutoTokenizer. Подробности см. в PreTrainedTokenizer.encode() и PreTrainedTokenizer.call().
- decoder_attention_mask (
torch.BoolTensorформы(batch_size, target_sequence_length), необязательный) — Поведение по умолчанию: генерировать тензор, игнорирующий токены pad вdecoder_input_ids. Маска причинности также будет использоваться по умолчанию.Актуально только в том случае, если используется языковая модель с архитектурой «кодировщик-декодировщик» (например, T5).
- inputs_embeds (
torch.Tensorформы(batch_size, sequence_length, hidden_size), необязательный) — При необходимости, вместо передачиinput_idsможно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексыinput_idsпреобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели. - interpolate_pos_encoding (
bool, необязательный, по умолчаниюFalse) — Указывает, следует ли интерполировать предобученные позиционные кодировки. - use_cache (
bool, необязательный) — Если установлено вTrue, возвращаются состояния ключей и значенийpast_key_values, которые можно использовать для ускорения декодирования (см.past_key_values).
Возвращает
InstructBlipVideoForConditionalGenerationModelOutput или tuple(torch.FloatTensor)
InstructBlipVideoForConditionalGenerationModelOutput или кортеж из
torch.FloatTensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (InstructBlipVideoConfig) и входных данных.
Метод forward модели InstructBlipVideoModel переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
- loss (
torch.FloatTensor, необязательный, возвращается, если заданlabels,torch.FloatTensorформы(1,)) — Потери языковой модели, полученные от языковой модели. - logits (
torch.FloatTensorформы(batch_size, sequence_length, config.vocab_size)) — Оценки предсказаний языковой модели. - vision_outputs (
~modeling_outputs.BaseModelOutputWithPooling, необязательный) — Выходы визуального кодировщика. - qformer_outputs (
~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions, необязательный) — Выходные данные Q-Former (Querying Transformer). - language_model_outputs (
CausalLMOutputWithPastилиSeq2SeqLMOutput) — Выходные данные языковой модели.
InstructBlipVideoForConditionalGeneration
класс transformers.InstructBlipVideoForConditionalGeneration
< source >( config: InstructBlipVideoConfig )
Параметры
- config (InstructBlipVideoConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация по файлу конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Используйте метод from_pretrained() для загрузки весов модели.
Модель InstructBlipVideo для генерации текста по изображению и необязательному текстовому запросу. Модель состоит из визуального энкодера, Querying Transformer (Q-Former) и языковой модели.
Необязательно можно передать в модель input_ids, которые служат текстовым промптом, чтобы языковая модель продолжила этот промпт. В противном случае языковая модель начинает генерировать текст с токена [BOS] (начало последовательности).
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( pixel_values: FloatTensorqformer_input_ids: FloatTensorqformer_attention_mask: typing.Optional[torch.LongTensor] = Noneinput_ids: typing.Optional[torch.FloatTensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Nonedecoder_input_ids: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneinterpolate_pos_encoding: bool = Falseuse_cache: bool | None = Nonemm_encoder_outputs: transformers.modeling_outputs.BaseModelOutputWithPooling | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → InstructBlipVideoForConditionalGenerationModelOutput or tuple(torch.FloatTensor)
Параметры
- pixel_values (
torch.FloatTensorформы(batch_size, num_channels, image_size, image_size)) — Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощьюimage_processor_class. Подробности см. вimage_processor_class.__call__(InstructBlipVideoProcessor используетimage_processor_classдля обработки изображений). - qformer_input_ids (
torch.LongTensorформы (batch_size, sequence_length)) — Последовательность, используемая в качестве промпта для модуля Q-Former. - qformer_attention_mask (
torch.LongTensorформы (batch_size, sequence_length), необязательный) — Маска для исключения внимания к индексам токенов-заполнителей. - input_ids (
torch.FloatTensorформы(batch_size, sequence_length), , необязательный) — Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется.Индексы можно получить с помощью AutoTokenizer. Подробности см. в PreTrainedTokenizer.encode() и PreTrainedTokenizer.call().
- attention_mask (
torch.LongTensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения токенов-заполнителей из внимания. Значения маски из диапазона[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
- decoder_input_ids (
torch.LongTensorформы(batch_size, target_sequence_length), необязательный) — Индексы токенов входной последовательности декодера в словаре. Индексы можно получить с помощью AutoTokenizer. Подробности — в PreTrainedTokenizer.encode() и PreTrainedTokenizer.call(). Что такое decoder input IDs?Индексы можно получить с помощью AutoTokenizer. Подробности см. в PreTrainedTokenizer.encode() и PreTrainedTokenizer.call().
- decoder_attention_mask (
torch.LongTensorформы(batch_size, target_sequence_length), необязательный) — Маска для исключения внимания к определённым индексам токенов. По умолчанию используется каузальная маска, чтобы модель могла учитывать только предыдущие входные данные при прогнозировании будущих. - inputs_embeds (
torch.FloatTensorформы(batch_size, sequence_length, hidden_size), необязательный) — При необходимости, вместо передачиinput_idsможно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексыinput_idsпреобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска эмбеддингов модели. - labels (
torch.LongTensorформы(batch_size, sequence_length), необязательный) — Метки для вычисления потерь маскированного языкового моделирования. Индексы должны находиться в диапазоне[0, ..., config.vocab_size]или быть равны -100 (см. docstringinput_ids). Токены с индексами, установленными в-100, игнорируются (маскируются); потери вычисляются только для токенов с метками в диапазоне[0, ..., config.vocab_size]. - interpolate_pos_encoding (
bool, необязательный, по умолчаниюFalse) — Указывает, следует ли интерполировать предобученные позиционные кодировки. - use_cache (
bool, необязательный) — Если установлено вTrue, возвращаются состояния ключей и значенийpast_key_values, которые можно использовать для ускорения декодирования (см.past_key_values). - mm_encoder_outputs (
~modeling_outputs.BaseModelOutputWithPooling, необязательный) — Словарь, где ключами являются поддерживаемые модальности, а значениями — закодированные выходные данные для данной модальности. Каждый закодированный выход представляет собой кортеж, состоящий из (pooler_output, необязательный:last_hidden_states, необязательный:hidden_states, необязательный:attentions)pooler_outputформы(batch_size, sequence_length, hidden_size), необязательный) — это последовательность мультимодальных признаков энкодера, объединённых с текстовыми эмбеддингами.
Возвращает
InstructBlipVideoForConditionalGenerationModelOutput или tuple(torch.FloatTensor)
InstructBlipVideoForConditionalGenerationModelOutput или кортеж
torch.FloatTensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (InstructBlipVideoConfig) и входных данных.
Метод forward класса InstructBlipVideoForConditionalGeneration переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
- loss (
torch.FloatTensor, необязательный, возвращается, если заданlabels,torch.FloatTensorформы(1,)) — Потери языковой модели, полученные от языковой модели. - logits (
torch.FloatTensorформы(batch_size, sequence_length, config.vocab_size)) — Оценки предсказаний языковой модели. - vision_outputs (
~modeling_outputs.BaseModelOutputWithPooling, необязательный) — Выходы визуального кодировщика. - qformer_outputs (
~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions, необязательный) — Выходные данные Q-Former (Querying Transformer). - language_model_outputs (
CausalLMOutputWithPastилиSeq2SeqLMOutput) — Выходные данные языковой модели.
Примеры:
>>> from transformers import InstructBlipVideoProcessor, InstructBlipVideoForConditionalGeneration
>>> import torch
>>> from huggingface_hub import hf_hub_download
>>> import av
>>> import numpy as np

>>> def read_video_pyav(container, indices):
...     '''
...     Decode the video with PyAV decoder.
...     Args:
...         container (`av.container.input.InputContainer`): PyAV container.
...         indices (`list[int]`): List of frame indices to decode.
...     Returns:
...         result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
...     '''
...     frames = []
...     container.seek(0)
...     start_index = indices[0]
...     end_index = indices[-1]
...     for i, frame in enumerate(container.decode(video=0)):
...         if i > end_index:
...             break
...         if i >= start_index and i in indices:
...             frames.append(frame)
...     return np.stack([x.to_ndarray(format="rgb24") for x in frames])

>>> model = InstructBlipVideoForConditionalGeneration.from_pretrained("Salesforce/instructblip-vicuna-7b", device_map="auto")
>>> processor = InstructBlipVideoProcessor.from_pretrained("Salesforce/instructblip-vicuna-7b")

>>> file_path = hf_hub_download(
...       repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)

>>> # sample uniformly 4 frames from the video
>>> total_frames = container.streams.video[0].frames
>>> indices = np.arange(0, total_frames, total_frames / 4).astype(int)
>>> clip = read_video_pyav(container, indices)

>>> prompt = "What is happening in the video?"
>>> inputs = processor(text=prompt, images=clip, return_tensors="pt").to(model.device)

>>> outputs = model.generate(
...     **inputs,
...     do_sample=False,
...     num_beams=5,
...     max_length=256,
...     repetition_penalty=1.5,
...     length_penalty=1.0,
... )
>>> generated_text = processor.batch_decode(outputs, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
"A person is eating a bowl of pasta, and they are using a fork to eat it. The person is sitting at a table, and the plate of pasta is on the table in front"
generate
< source >( pixel_values: FloatTensorqformer_input_ids: typing.Optional[torch.LongTensor] = Noneqformer_attention_mask: typing.Optional[torch.LongTensor] = Noneinput_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Noneinterpolate_pos_encoding: bool = False**generate_kwargs ) → captions (list)
Параметры
- pixel_values (
torch.FloatTensorформы (batch_size, num_channels, height, width) или — (batch_size, num_frames, num_channels, height, width)): входные изображения или видео для обработки. - qformer_input_ids (
torch.LongTensorформы (batch_size, sequence_length), необязательный) — Последовательность, используемая в качестве промпта для модуля Q-Former. - qformer_attention_mask (
torch.LongTensorформы (batch_size, sequence_length), необязательный) — Маска для исключения внимания к индексам токенов-заполнителей. - input_ids (
torch.LongTensorформы (batch_size, sequence_length), необязательный) — Последовательность, используемая в качестве промпта для генерации. - attention_mask (
torch.LongTensorформы (batch_size, sequence_length), необязательный) — Маска для исключения внимания к индексам токенов-заполнителей. - inputs_embeds (
torch.FloatTensorформы(batch_size, sequence_length, hidden_size)) — Встроенное представление входных данных. Должно быть float, а не int-токены. - interpolate_pos_encoding (
bool, необязательный, по умолчаниюFalse) — Указывает, следует ли интерполировать позиционное кодирование эмбеддингов изображения.
Возвращает
captions (список)
Список строк длины batch_size * num_captions.
Переопределяет функцию generate, чтобы использовать модель в качестве условного генератора.
get_video_features
< source >( pixel_values: FloatTensorqformer_input_ids: LongTensorqformer_attention_mask: typing.Optional[torch.LongTensor] = Noneinterpolate_pos_encoding: bool | None = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithVisionQformerOutputs or tuple(torch.FloatTensor)
Параметры
- pixel_values (
torch.FloatTensorформы(batch_size, num_channels, image_size, image_size)) — Тензоры, соответствующие входным изображениям. - qformer_input_ids (
torch.LongTensorформы (batch_size, sequence_length)) — Последовательность, используемая в качестве промпта для модуля Q-Former. - qformer_attention_mask (
torch.LongTensorформы (batch_size, sequence_length), необязательный) — Маска для исключения внимания к индексам токенов-заполнителей. - interpolate_pos_encoding (
bool, необязательный, по умолчаниюFalse) — Указывает, следует ли интерполировать предобученные позиционные кодировки.
Возвращает
BaseModelOutputWithVisionQformerOutputs или tuple(torch.FloatTensor)
BaseModelOutputWithVisionQformerOutputs или кортеж из
torch.FloatTensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (InstructBlipVideoConfig) и входных данных.
last_hidden_state (
torch.FloatTensorформы(batch_size, sequence_length, hidden_size)) — Последовательность скрытых состояний на выходе последнего слоя модели.pooler_output (
torch.FloatTensorформы(batch_size, hidden_size)) — Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки через линейный слой и функцию активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.hidden_states (
tuple(torch.FloatTensor), необязательный, возвращается, если переданоoutput_hidden_states=Trueили еслиconfig.output_hidden_states=True) — кортеж изtorch.FloatTensor(один для вывода слоя встраиваний, если модель имеет такой слой, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
attentions (
tuple(torch.FloatTensor), необязательный, возвращается, если переданоoutput_attentions=Trueили еслиconfig.output_attentions=True) — Кортежtorch.FloatTensor(по одному для каждого слоя) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
vision_outputs (
~modeling_outputs.BaseModelOutputWithPooling, необязательный) — Выходы визуального кодировщика.qformer_outputs (
~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions, необязательный) — Выходные данные Q-Former (Querying Transformer).
Пример:
>>> from PIL import Image
>>> from transformers import AutoProcessor, InstructBlipVideoForConditionalGeneration

>>> model = InstructBlipVideoForConditionalGeneration.from_pretrained("Salesforce/instructblip-flan-t5-xl")
>>> processor = AutoProcessor.from_pretrained("Salesforce/instructblip-flan-t5-xl")

>>> messages = [
...     {
...         "role": "user", "content": [
...             {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
...             {"type": "text", "text": "Where is the cat standing?"},
...         ]
...     },
... ]

>>> inputs = processor.apply_chat_template(
...     messages,
...     tokenize=True,
...     return_dict=True,
...     return_tensors="pt",
...     add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]