Transformers documentation
시각적 문서 검색
시각적 문서 검색
문서에는 텍스트 외에도 차트, 표, 시각 자료 등이 포함될 수 있으며, 이를 통해 멀티모달 데이터를 포함할 수 있습니다. 이러한 문서에서 정보를 검색하는 것은 어려운 작업입니다. 텍스트 검색 모델만으로는 시각 데이터를 처리할 수 없으며, 이미지 검색 모델은 세밀한 수준과 문서 처리 기능이 부족하기 때문입니다.
시각 문서 검색은 멀티모달 검색 증강 생성(RAG)을 포함하여 모든 유형의 문서에서 정보를 검색하는 데 도움이 됩니다. 이러한 모델은 문서(이미지 형태)와 텍스트를 입력으로 받아 두 것 간의 유사도 점수를 계산합니다.
이 가이드에서는 ColPali로 문서를 색인하고 검색하는 방법을 보여줍니다.
대규모 사용 사례에서는 벡터 데이터베이스를 사용하여 문서를 인덱싱하고 검색하는 것이 좋습니다.
Transformers와 Datasets가 설치되어 있는지 확인하세요.
pip install -q datasets transformers
UFO 목격과 관련된 문서 데이터셋을 인덱싱합니다. 관심 있는 열이 누락된 예시를 필터링합니다. 데이터셋에는 여러 열이 포함되어 있으며, 문서의 짧은 요약을 포함하는 specific_detail_query 열과 문서가 포함된 image 열에 관심이 있습니다.
from datasets import load_dataset

dataset = load_dataset("davanstrien/ufo-ColPali")
dataset = dataset["train"]
dataset = dataset.filter(lambda example: example["specific_detail_query"] is not None)
print(dataset)Dataset({
features: ['image', 'raw_queries', 'broad_topical_query', 'broad_topical_explanation', 'specific_detail_query', 'specific_detail_explanation', 'visual_element_query', 'visual_element_explanation', 'parsed_into_json'],
num_rows: 2172
})모델과 토크나이저를 로드해 보겠습니다.
import torch
from transformers import ColPaliForRetrieval, ColPaliProcessor
from accelerate import Accelerator

device = Accelerator().device

model_name = "vidore/colpali-v1.2-hf"

processor = ColPaliProcessor.from_pretrained(model_name)

model = ColPaliForRetrieval.from_pretrained(
    model_name,
    dtype=torch.bfloat16,
    device_map="auto",
).eval()
텍스트 쿼리를 프로세서에 전달하고 모델에서 인덱싱된 텍스트 임베딩을 반환합니다. 이미지-텍스트 검색의 경우, ColPaliProcessor의 text 매개변수를 images 매개변수로 교체하여 이미지를 전달합니다.
inputs = processor(text="a document about Mars expedition").to(model.device)
with torch.no_grad():
  text_embeds = model(**inputs, return_tensors="pt").embeddings
이미지를 오프라인으로 인덱싱하고, 추론 시 쿼리 텍스트 임베딩을 반환하여 가장 가까운 이미지 임베딩을 가져옵니다.
아래와 같이 map을 사용하여 이미지와 이미지 임베딩을 데이터셋에 저장합니다. 인덱싱된 임베딩을 포함하는 embeddings 컬럼을 추가합니다. ColPali 임베딩은 저장 공간을 많이 차지하므로, accelerator에서 제거하고 NumPy 벡터로 CPU에 저장합니다.
ds_with_embeddings = dataset.map(lambda example: {'embeddings': model(**processor(images=example["image"]).to(device), return_tensors="pt").embeddings.to(torch.float32).detach().cpu().numpy()})온라인 추론을 위해 이미지 임베딩을 배치로 검색하고 가장 관련성이 높은 k개의 이미지를 가져오는 함수를 생성하세요. 아래 함수는 인덱싱된 데이터셋, 텍스트 임베딩, 상위 결과 수, 배치 크기가 주어지면 데이터셋 내 인덱스와 해당 점수를 반환합니다.
def find_top_k_indices_batched(dataset, text_embedding, processor, k=10, batch_size=4):
    scores_and_indices = []

    for start_idx in range(0, len(dataset), batch_size):

        end_idx = min(start_idx + batch_size, len(dataset))
        batch = dataset[start_idx:end_idx]
        batch_embeddings = [torch.tensor(emb[0], dtype=torch.float32) for emb in batch["embeddings"]]
        scores = processor.score_retrieval(text_embedding.to("cpu").to(torch.float32), batch_embeddings)

        if hasattr(scores, "tolist"):
            scores = scores.tolist()[0]

        for i, score in enumerate(scores):
            scores_and_indices.append((score, start_idx + i))

    sorted_results = sorted(scores_and_indices, key=lambda x: -x[0])

    topk = sorted_results[:k]
    indices = [idx for _, idx in topk]
    scores = [score for score, _ in topk]

    return indices, scores
텍스트 임베딩을 생성하고, 위 함수에 전달하여 데이터셋 인덱스와 점수를 반환합니다.
with torch.no_grad():
  text_embeds = model(**processor(text="a document about Mars expedition").to(model.device), return_tensors="pt").embeddings
indices, scores = find_top_k_indices_batched(ds_with_embeddings, text_embeds, processor, k=3, batch_size=4)
print(indices, scores)([440, 442, 443], [14.370786666870117, 13.675487518310547, 12.9899320602417])
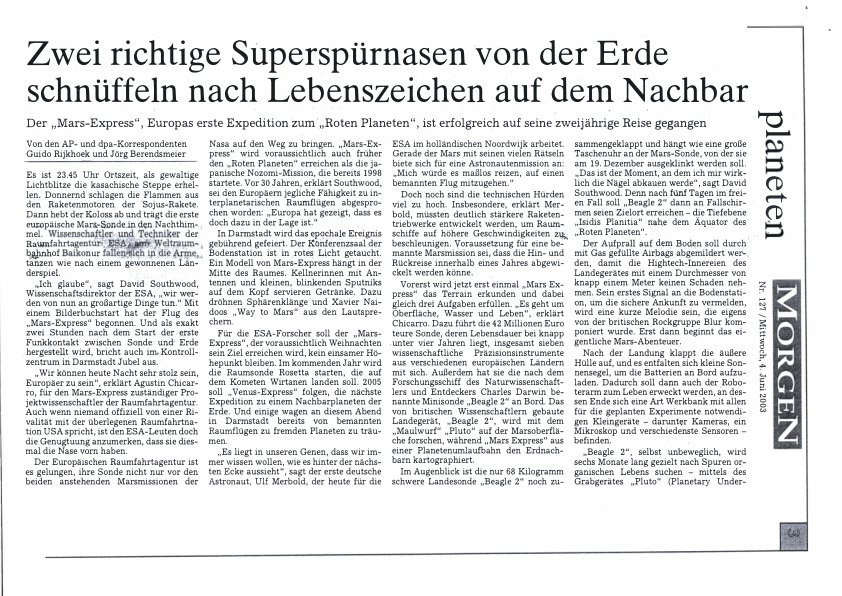
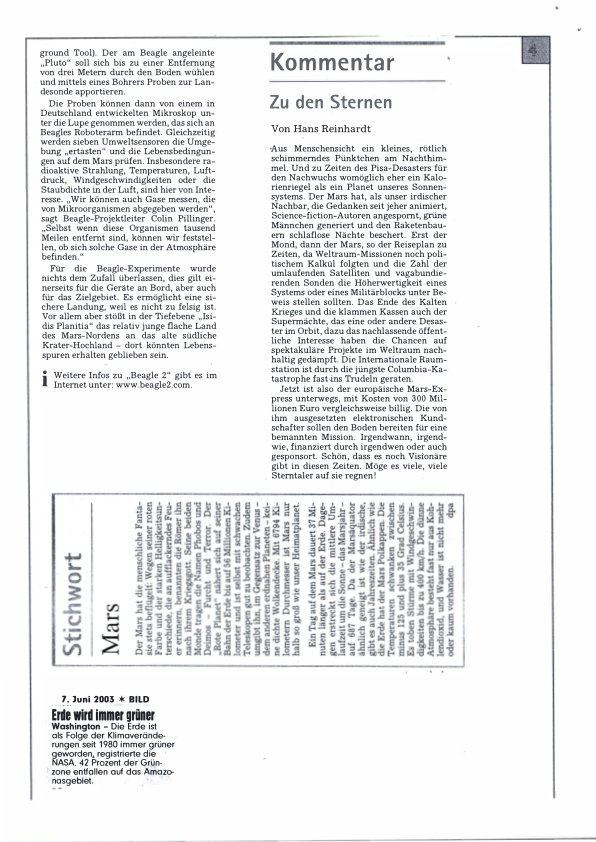
Mars 관련 문서를 확인하려면 이미지를 표시합니다.
for i in indices:
  display(dataset[i]["image"])