
Transformers documentation
Réponse aux questions sur des documents
Réponse aux questions sur des documents
Le Document Question Answering, également appelé Document Visual Question Answering, est une tâche qui consiste à fournir des réponses à des questions posées sur des images de documents. L’entrée des modèles prenant en charge cette tâche est généralement une combinaison d’une image et d’une question, et la sortie est une réponse exprimée en langage naturel. Ces modèles utilisent plusieurs modalités, notamment le texte, les positions des mots (bounding boxes) et l’image elle-même.
Ce guide illustre comment :
- Effectuer le fine-tuning de LayoutLMv2 sur le DocVQA dataset.
- Utilisez votre modèle affiné pour l'inférence.
Pour consulter toutes les architectures et points de contrôle compatibles avec cette tâche, nous vous recommandons de consulter la page de la tâche
LayoutLMv2 résout la tâche de question-réponse sur documents en ajoutant une tête de question-réponse au-dessus des états cachés finaux des jetons, afin de prédire les positions des jetons de début et de fin de la réponse. Autrement dit, le problème est traité comme une question-réponse extractive : étant donné le contexte, il s’agit d’extraire l’information qui répond à la question. Le contexte provient de la sortie d’un moteur OCR, ici Tesseract de Google.
Avant de commencer, assurez-vous d'avoir installé toutes les bibliothèques nécessaires. LayoutLMv2 dépend de detectron2, torchvision et tesseract.
pip install -q transformers datasets
pip install 'git+https://github.com/facebookresearch/detectron2.git'
pip install torchvisionsudo apt install tesseract-ocr
pip install -q pytesseractUne fois que vous avez installé toutes les dépendances, redémarrez votre environnement d'exécution.
Nous vous encourageons à partager votre modèle avec la communauté. Connectez-vous à votre compte Hugging Face pour le téléverser sur le 🤗 Hub. Lorsqu'on vous le demande, saisissez votre jeton pour vous connecter :
>>> from huggingface_hub import notebook_login

>>> notebook_login()
Définissons quelques variables globales.
>>> model_checkpoint = "microsoft/layoutlmv2-base-uncased"
>>> batch_size = 4
Charger les données
Dans ce guide, nous utilisons un petit échantillon de DocVQA prétraité que vous pouvez trouver sur le 🤗 Hub. Si vous souhaitez utiliser le jeu de données DocVQA complet, vous pouvez vous inscrire et le télécharger sur la page d’accueil de DocVQA. Dans ce cas, pour poursuivre avec ce guide, consultez comment charger des fichiers dans un jeu de données 🤗.
>>> from datasets import load_dataset

>>> dataset = load_dataset("nielsr/docvqa_1200_examples")
>>> dataset
DatasetDict({
    train: Dataset({
        features: ['id', 'image', 'query', 'answers', 'words', 'bounding_boxes', 'answer'],
        num_rows: 1000
    })
    test: Dataset({
        features: ['id', 'image', 'query', 'answers', 'words', 'bounding_boxes', 'answer'],
        num_rows: 200
    })
})
Comme vous pouvez le constater, le jeu de données est déjà réparti en ensembles d’entraînement et de test. Examinez un exemple aléatoire pour vous familiariser avec les caractéristiques.
>>> dataset["train"].featuresVoici ce que représentent les champs individuels :
id: l’identifiant de l’exempleimage: un objet PIL.Image.Image contenant l'image du documentquery: la chaîne de caractères de la question - question posée en langage naturel, dans plusieurs languesanswers: une liste de réponses correctes fournies par des annotateurs humainswordsetbounding_boxes: les résultats de l'OCR, que nous n'utiliserons pas icianswer: une réponse correspondante issue d'un autre modèle, que nous n'utiliserons pas ici
Laissons uniquement les questions en anglais et supprimons la fonctionnalité answer, qui semble contenir des prédictions d’un autre modèle.
Nous prendrons également la première des réponses du jeu fourni par les annotateurs. Vous pouvez également en échantillonner une aléatoirement.
>>> updated_dataset = dataset.map(lambda example: {"question": example["query"]["en"]}, remove_columns=["query"])
>>> updated_dataset = updated_dataset.map(
...     lambda example: {"answer": example["answers"][0]}, remove_columns=["answer", "answers"]
... )
Notez que le point de contrôle LayoutLMv2 utilisé dans ce guide a été entraîné avec max_position_embeddings = 512 (vous pouvez
trouver cette information dans le fichier config.json du point de contrôle).
Nous pouvons tronquer les exemples, mais pour éviter la situation où la réponse se trouve à la fin d’un long document et se retrouve tronquée,
nous supprimons ici les quelques exemples dont l’embedding est susceptible de dépasser 512.
Si la plupart des documents de votre jeu de données sont longs, vous pouvez mettre en œuvre une stratégie de fenêtre glissante - consultez ce notebook pour plus de détails.
>>> updated_dataset = updated_dataset.filter(lambda x: len(x["words"]) + len(x["question"].split()) < 512)À ce stade, supprimons également les fonctionnalités OCR de ce jeu de données. Elles sont le résultat d’un OCR destiné à l’ajustement fin d’un autre modèle. Elles nécessiteraient encore un certain traitement si nous voulions les utiliser, car elles ne correspondent pas aux exigences d’entrée du modèle utilisé dans ce guide. Nous pouvons plutôt utiliser le LayoutLMv2Processor sur les données d’origine pour l’OCR et la tokenisation. De cette façon, nous obtiendrons des entrées conformes aux attentes du modèle. Si vous souhaitez traiter les images manuellement, consultez la documentation du modèle LayoutLMv2 pour connaître le format d’entrée attendu par le modèle.
>>> updated_dataset = updated_dataset.remove_columns("words")
>>> updated_dataset = updated_dataset.remove_columns("bounding_boxes")
Enfin, l’exploration des données ne serait pas complète si nous ne jetions pas un œil à un exemple d’image.
>>> updated_dataset["train"][11]["image"]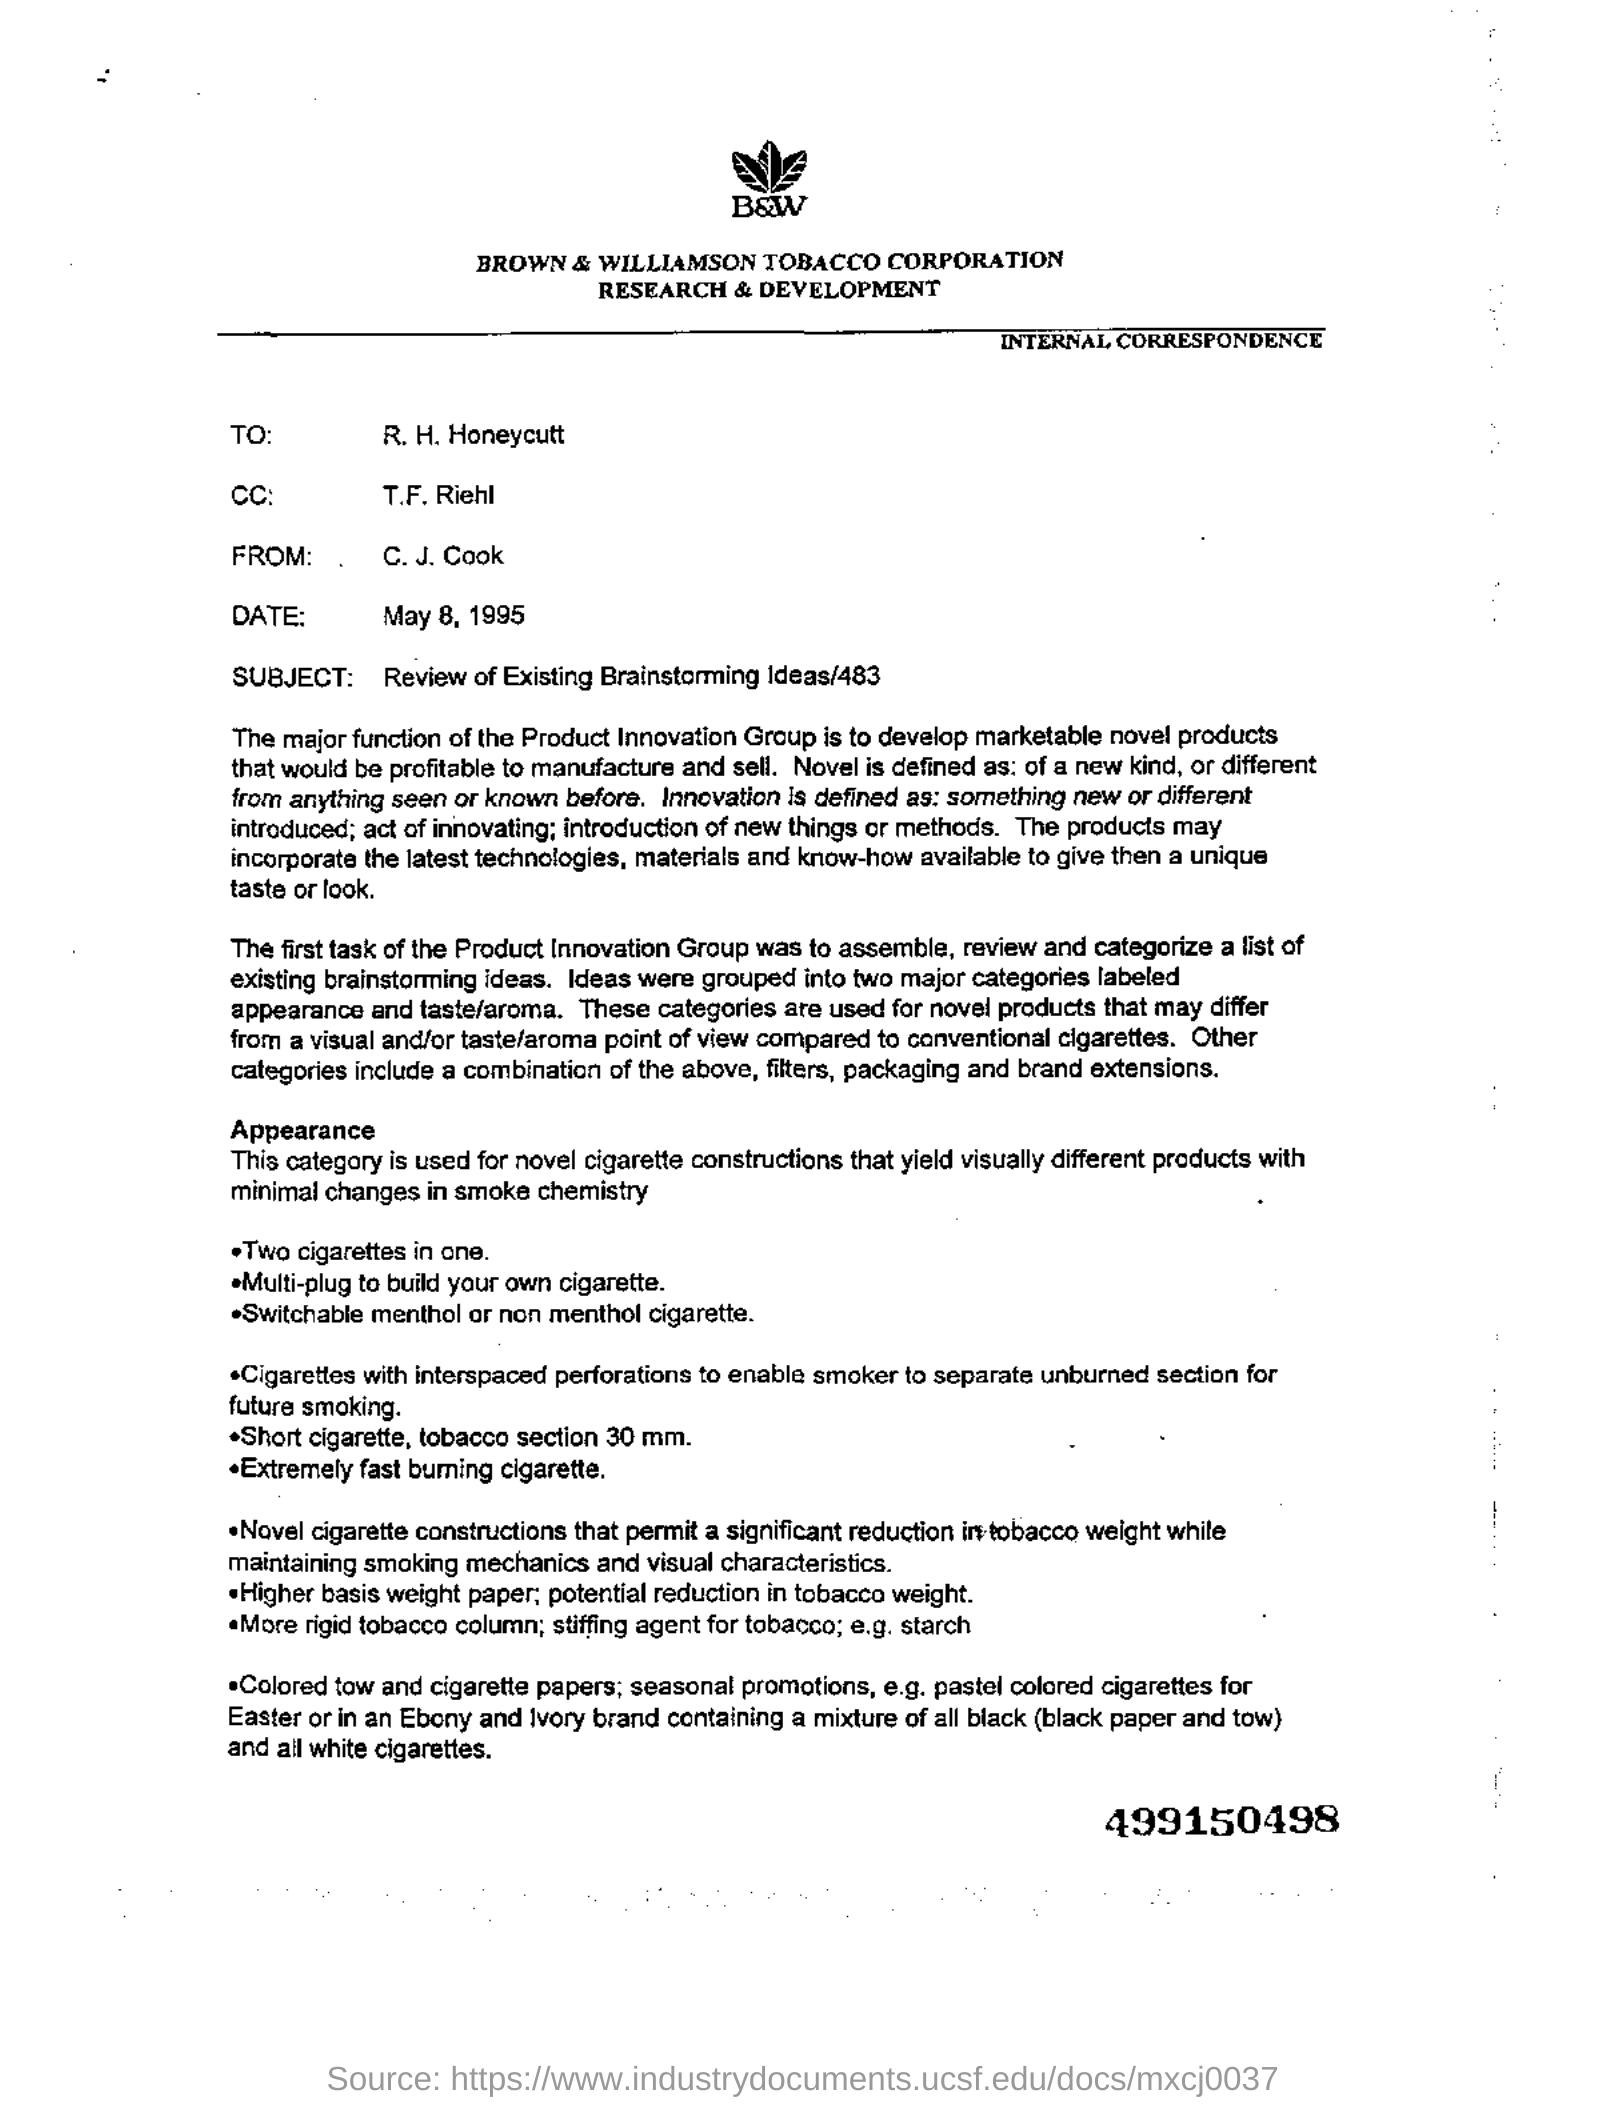
Prétraiter les données
La tâche de réponse à des questions sur des documents est une tâche multimodale, et vous devez vous assurer que les entrées de chaque modalité sont prétraitées conformément aux attentes du modèle. Commençons par charger le LayoutLMv2Processor, qui combine en interne un processeur d’images capable de gérer les données d’images et un tokeniseur capable d’encoder les données textuelles.
>>> from transformers import AutoProcessor

>>> processor = AutoProcessor.from_pretrained(model_checkpoint)
Prétraitement des images de documents
Tout d'abord, préparons les images de documents pour le modèle à l'aide de l'image_processor du processeur.
Par défaut, le processeur d'images redimensionne les images en 224x224, s'assure qu'elles ont le bon ordre des canaux de couleur,
et applique l'OCR avec tesseract pour obtenir les mots et les boîtes englobantes normalisées. Dans ce tutoriel, tous ces paramètres par défaut sont exactement ce dont nous avons besoin.
Écrivez une fonction qui applique le traitement d'images par défaut à un lot d'images et renvoie les résultats de l'OCR.
>>> image_processor = processor.image_processor


>>> def get_ocr_words_and_boxes(examples):
...     images = [image.convert("RGB") for image in examples["image"]]
...     encoded_inputs = image_processor(images)

...     examples["image"] = encoded_inputs.pixel_values
...     examples["words"] = encoded_inputs.words
...     examples["boxes"] = encoded_inputs.boxes

...     return examples
Pour appliquer ce prétraitement à l’ensemble du jeu de données de manière rapide, utilisez map.
>>> dataset_with_ocr = updated_dataset.map(get_ocr_words_and_boxes, batched=True, batch_size=2)Prétraitement des données textuelles
Une fois l’OCR appliqué aux images, nous devons encoder la partie texte du jeu de données pour le préparer au modèle.
Cela consiste à convertir les mots et les boîtes obtenus à l’étape précédente en input_ids, attention_mask, token_type_ids et bbox au niveau des jetons. Pour le prétraitement du texte, nous aurons besoin du tokenizer issu du processeur.
>>> tokenizer = processor.tokenizerEn plus du prétraitement mentionné ci-dessus, nous devons également ajouter les étiquettes pour le modèle. Pour les modèles xxxForQuestionAnswering
de 🤗 Transformers, les étiquettes sont composées des start_positions et des end_positions, qui indiquent quel jeton se trouve au
début et quel jeton se trouve à la fin de la réponse.
Commençons par cela. Définissez une fonction auxiliaire capable de trouver une sous-liste (la réponse découpée en mots) dans une liste plus grande (la liste des mots).
This function will take two lists as input, words_list and answer_list. It will then iterate over the words_list and check
if the current word in the words_list (words_list[i]) is equal to the first word of answer_list (answer_list[0]) and if
the sublist of words_list starting from the current word and of the same length as answer_list is equal to answer_list.
If this condition is true, it means that a match has been found, and the function will record the match, its starting index (idx),
and its ending index (idx + len(answer_list) - 1). If more than one match was found, the function will return only the first one.
If no match is found, the function returns (None, 0, and 0).
>>> def subfinder(words_list, answer_list):
...     matches = []
...     start_indices = []
...     end_indices = []
...     for idx, i in enumerate(range(len(words_list))):
...         if words_list[i] == answer_list[0] and words_list[i : i + len(answer_list)] == answer_list:
...             matches.append(answer_list)
...             start_indices.append(idx)
...             end_indices.append(idx + len(answer_list) - 1)
...     if matches:
...         return matches[0], start_indices[0], end_indices[0]
...     else:
...         return None, 0, 0
Pour illustrer la manière dont cette fonction localise la position de la réponse, utilisons-la sur un exemple :
>>> example = dataset_with_ocr["train"][1]
>>> words = [word.lower() for word in example["words"]]
>>> match, word_idx_start, word_idx_end = subfinder(words, example["answer"].lower().split())
>>> print("Question: ", example["question"])
>>> print("Words:", words)
>>> print("Answer: ", example["answer"])
>>> print("start_index", word_idx_start)
>>> print("end_index", word_idx_end)
Question:  Who is in  cc in this letter?
Words: ['wie', 'baw', 'brown', '&', 'williamson', 'tobacco', 'corporation', 'research', '&', 'development', 'internal', 'correspondence', 'to:', 'r.', 'h.', 'honeycutt', 'ce:', 't.f.', 'riehl', 'from:', '.', 'c.j.', 'cook', 'date:', 'may', '8,', '1995', 'subject:', 'review', 'of', 'existing', 'brainstorming', 'ideas/483', 'the', 'major', 'function', 'of', 'the', 'product', 'innovation', 'graup', 'is', 'to', 'develop', 'marketable', 'nove!', 'products', 'that', 'would', 'be', 'profitable', 'to', 'manufacture', 'and', 'sell.', 'novel', 'is', 'defined', 'as:', 'of', 'a', 'new', 'kind,', 'or', 'different', 'from', 'anything', 'seen', 'or', 'known', 'before.', 'innovation', 'is', 'defined', 'as:', 'something', 'new', 'or', 'different', 'introduced;', 'act', 'of', 'innovating;', 'introduction', 'of', 'new', 'things', 'or', 'methods.', 'the', 'products', 'may', 'incorporate', 'the', 'latest', 'technologies,', 'materials', 'and', 'know-how', 'available', 'to', 'give', 'then', 'a', 'unique', 'taste', 'or', 'look.', 'the', 'first', 'task', 'of', 'the', 'product', 'innovation', 'group', 'was', 'to', 'assemble,', 'review', 'and', 'categorize', 'a', 'list', 'of', 'existing', 'brainstorming', 'ideas.', 'ideas', 'were', 'grouped', 'into', 'two', 'major', 'categories', 'labeled', 'appearance', 'and', 'taste/aroma.', 'these', 'categories', 'are', 'used', 'for', 'novel', 'products', 'that', 'may', 'differ', 'from', 'a', 'visual', 'and/or', 'taste/aroma', 'point', 'of', 'view', 'compared', 'to', 'canventional', 'cigarettes.', 'other', 'categories', 'include', 'a', 'combination', 'of', 'the', 'above,', 'filters,', 'packaging', 'and', 'brand', 'extensions.', 'appearance', 'this', 'category', 'is', 'used', 'for', 'novel', 'cigarette', 'constructions', 'that', 'yield', 'visually', 'different', 'products', 'with', 'minimal', 'changes', 'in', 'smoke', 'chemistry', 'two', 'cigarettes', 'in', 'cne.', 'emulti-plug', 'te', 'build', 'yaur', 'awn', 'cigarette.', 'eswitchable', 'menthol', 'or', 'non', 'menthol', 'cigarette.', '*cigarettes', 'with', 'interspaced', 'perforations', 'to', 'enable', 'smoker', 'to', 'separate', 'unburned', 'section', 'for', 'future', 'smoking.', '«short', 'cigarette,', 'tobacco', 'section', '30', 'mm.', '«extremely', 'fast', 'buming', 'cigarette.', '«novel', 'cigarette', 'constructions', 'that', 'permit', 'a', 'significant', 'reduction', 'iretobacco', 'weight', 'while', 'maintaining', 'smoking', 'mechanics', 'and', 'visual', 'characteristics.', 'higher', 'basis', 'weight', 'paper:', 'potential', 'reduction', 'in', 'tobacco', 'weight.', '«more', 'rigid', 'tobacco', 'column;', 'stiffing', 'agent', 'for', 'tobacco;', 'e.g.', 'starch', '*colored', 'tow', 'and', 'cigarette', 'papers;', 'seasonal', 'promotions,', 'e.g.', 'pastel', 'colored', 'cigarettes', 'for', 'easter', 'or', 'in', 'an', 'ebony', 'and', 'ivory', 'brand', 'containing', 'a', 'mixture', 'of', 'all', 'black', '(black', 'paper', 'and', 'tow)', 'and', 'ail', 'white', 'cigarettes.', '499150498']
Answer:  T.F. Riehl
start_index 17
end_index 18
Une fois les exemples encodés, en revanche, ils ressembleront à ceci :
>>> encoding = tokenizer(example["question"], example["words"], example["boxes"])
>>> tokenizer.decode(encoding["input_ids"])
[CLS] who is in cc in this letter? [SEP] wie baw brown & williamson tobacco corporation research & development ...
Nous devrons trouver la position de la réponse dans l’entrée encodée.
token_type_idsnous indique quels jetons font partie de la question et lesquels font partie des mots du document.tokenizer.cls_token_idpermet de trouver le jeton spécial situé au début de l’entrée.word_idspermet d’associer la réponse trouvée dans leswordsd’origine à la même réponse dans l’entrée encodée complète et de déterminer la position de début/fin de la réponse dans l’entrée encodée.
Dans cette optique, créons une fonction pour encoder un lot d'exemples du jeu de données :
>>> def encode_dataset(examples, max_length=512):
...     questions = examples["question"]
...     words = examples["words"]
...     boxes = examples["boxes"]
...     answers = examples["answer"]

...     # encode the batch of examples and initialize the start_positions and end_positions
...     encoding = tokenizer(questions, words, boxes, max_length=max_length, padding="max_length", truncation=True)
...     start_positions = []
...     end_positions = []

...     # loop through the examples in the batch
...     for i in range(len(questions)):
...         cls_index = encoding["input_ids"][i].index(tokenizer.cls_token_id)

...         # find the position of the answer in example's words
...         words_example = [word.lower() for word in words[i]]
...         answer = answers[i]
...         match, word_idx_start, word_idx_end = subfinder(words_example, answer.lower().split())

...         if match:
...             # if match is found, use `token_type_ids` to find where words start in the encoding
...             token_type_ids = encoding["token_type_ids"][i]
...             token_start_index = 0
...             while token_type_ids[token_start_index] != 1:
...                 token_start_index += 1

...             token_end_index = len(encoding["input_ids"][i]) - 1
...             while token_type_ids[token_end_index] != 1:
...                 token_end_index -= 1

...             word_ids = encoding.word_ids(i)[token_start_index : token_end_index + 1]
...             start_position = cls_index
...             end_position = cls_index

...             # loop over word_ids and increase `token_start_index` until it matches the answer position in words
...             # once it matches, save the `token_start_index` as the `start_position` of the answer in the encoding
...             for id in word_ids:
...                 if id == word_idx_start:
...                     start_position = token_start_index
...                 else:
...                     token_start_index += 1

...             # similarly loop over `word_ids` starting from the end to find the `end_position` of the answer
...             for id in word_ids[::-1]:
...                 if id == word_idx_end:
...                     end_position = token_end_index
...                 else:
...                     token_end_index -= 1

...             start_positions.append(start_position)
...             end_positions.append(end_position)

...         else:
...             start_positions.append(cls_index)
...             end_positions.append(cls_index)

...     encoding["image"] = examples["image"]
...     encoding["start_positions"] = start_positions
...     encoding["end_positions"] = end_positions

...     return encoding
Maintenant que nous disposons de cette fonction de prétraitement, nous pouvons encoder l'ensemble du jeu de données :
>>> encoded_train_dataset = dataset_with_ocr["train"].map(
...     encode_dataset, batched=True, batch_size=2, remove_columns=dataset_with_ocr["train"].column_names
... )
>>> encoded_test_dataset = dataset_with_ocr["test"].map(
...     encode_dataset, batched=True, batch_size=2, remove_columns=dataset_with_ocr["test"].column_names
... )
Vérifions à quoi ressemblent les caractéristiques du jeu de données encodé :
>>> encoded_train_dataset.features
{'image': Sequence(feature=Sequence(feature=Sequence(feature=Value(dtype='uint8', id=None), length=-1, id=None), length=-1, id=None), length=-1, id=None),
 'input_ids': Sequence(feature=Value(dtype='int32', id=None), length=-1, id=None),
 'token_type_ids': Sequence(feature=Value(dtype='int8', id=None), length=-1, id=None),
 'attention_mask': Sequence(feature=Value(dtype='int8', id=None), length=-1, id=None),
 'bbox': Sequence(feature=Sequence(feature=Value(dtype='int64', id=None), length=-1, id=None), length=-1, id=None),
 'start_positions': Value(dtype='int64', id=None),
 'end_positions': Value(dtype='int64', id=None)}
Évaluation
L’évaluation pour le question answering documentaire nécessite une quantité importante de post-traitement. Pour ne pas vous faire perdre trop de temps, ce guide passe l’étape d’évaluation. Le Trainer calcule néanmoins la perte d’évaluation pendant l’entraînement, afin que vous ne soyez pas complètement dans l’ignorance des performances de votre modèle. Le question answering extractif est généralement évalué à l’aide du F1/exact match. Si vous souhaitez l’implémenter vous-même, consultez le chapitre sur le Question Answering du cours Hugging Face pour vous inspirer.
Entraînement
Félicitations ! Vous avez franchi avec succès la partie la plus difficile de ce guide et vous êtes désormais prêt à entraîner votre propre modèle. L'entraînement implique les étapes suivantes :
- Chargez le modèle avec AutoModelForDocumentQuestionAnswering en utilisant le même point de contrôle que lors de la prétraitement.
- Définissez vos hyperparamètres d’entraînement dans TrainingArguments.
- Définissez une fonction pour regrouper les exemples en lots, ici le DefaultDataCollator convient parfaitement.
- Transmettez les arguments d'entraînement à Trainer en même temps que le modèle, le jeu de données et le data collator.
- Appel de train() pour l’ajustement fin de votre modèle.
>>> from transformers import AutoModelForDocumentQuestionAnswering

>>> model = AutoModelForDocumentQuestionAnswering.from_pretrained(model_checkpoint)
Dans TrainingArguments, utilisez output_dir pour indiquer l’emplacement de sauvegarde de votre modèle et configurez les hyperparamètres selon vos besoins.
Si vous souhaitez partager votre modèle avec la communauté, définissez push_to_hub sur True (vous devez être connecté à Hugging Face pour téléverser votre modèle).
Dans ce cas, output_dir servira également de nom au dépôt où le point de contrôle de votre modèle sera publié.
>>> from transformers import TrainingArguments

>>> # REPLACE THIS WITH YOUR REPO ID
>>> repo_id = "MariaK/layoutlmv2-base-uncased_finetuned_docvqa"

>>> training_args = TrainingArguments(
...     output_dir=repo_id,
...     per_device_train_batch_size=4,
...     num_train_epochs=20,
...     save_steps=200,
...     logging_steps=50,
...     eval_strategy="steps",
...     learning_rate=5e-5,
...     save_total_limit=2,
...     remove_unused_columns=False,
...     push_to_hub=True,
... )
Définissez un collateur de données simple pour regrouper les exemples en lots.
>>> from transformers import DefaultDataCollator

>>> data_collator = DefaultDataCollator()
Enfin, rassemblez le tout et appelez train() :
>>> from transformers import Trainer

>>> trainer = Trainer(
...     model=model,
...     args=training_args,
...     data_collator=data_collator,
...     train_dataset=encoded_train_dataset,
...     eval_dataset=encoded_test_dataset,
...     processing_class=processor,
... )

>>> trainer.train()
Pour ajouter le modèle final au 🤗 Hub, créez une carte de modèle et appelez push_to_hub :
>>> trainer.create_model_card()
>>> trainer.push_to_hub()
Inférence
Maintenant que vous avez effectué le fine-tuning d'un modèle LayoutLMv2 et que vous l'avez téléversé sur le 🤗 Hub, vous pouvez l'utiliser pour l'inférence. La manière la plus simple de tester votre modèle fine-tuné pour l'inférence est de l'utiliser dans un Pipeline.
Prenons un exemple :
>>> example = dataset["test"][2]
>>> question = example["query"]["en"]
>>> image = example["image"]
>>> print(question)
>>> print(example["answers"])
'Who is ‘presiding’ TRRF GENERAL SESSION (PART 1)?'
['TRRF Vice President', 'lee a. waller']
Ensuite, instanciez un pipeline pour la question-réponse sur document avec votre modèle, et transmettez-lui la combinaison image + question.
>>> from transformers import pipeline

>>> qa_pipeline = pipeline("document-question-answering", model="MariaK/layoutlmv2-base-uncased_finetuned_docvqa")
>>> qa_pipeline(image, question)
[{'score': 0.9949808120727539,
  'answer': 'Lee A. Waller',
  'start': 55,
  'end': 57}]
Vous pouvez également reproduire manuellement les résultats du pipeline si vous le souhaitez :
- Prenez une image et une question, puis préparez-les pour le modèle à l'aide du processeur de votre modèle.
- Transmettez le résultat ou le prétraitement au modèle.
- Le modèle renvoie
start_logitsetend_logits, qui indiquent quel jeton se trouve au début de la réponse et quel jeton se trouve à la fin de la réponse. Les deux ont la forme (batch_size, sequence_length). - Effectuez un argmax sur la dernière dimension des
start_logitset desend_logitspour obtenir lesstart_idxetend_idxprédits. - Décoder la réponse avec le tokenizer.
>>> import torch
>>> from transformers import AutoProcessor
>>> from transformers import AutoModelForDocumentQuestionAnswering

>>> processor = AutoProcessor.from_pretrained("MariaK/layoutlmv2-base-uncased_finetuned_docvqa")
>>> model = AutoModelForDocumentQuestionAnswering.from_pretrained("MariaK/layoutlmv2-base-uncased_finetuned_docvqa")

>>> with torch.no_grad():
...     encoding = processor(image.convert("RGB"), question, return_tensors="pt")
...     outputs = model(**encoding)
...     start_logits = outputs.start_logits
...     end_logits = outputs.end_logits
...     predicted_start_idx = start_logits.argmax(-1).item()
...     predicted_end_idx = end_logits.argmax(-1).item()

>>> processor.tokenizer.decode(encoding.input_ids.squeeze()[predicted_start_idx : predicted_end_idx + 1])
'lee a. waller'