
Diffusers documentation
PixArt-α
PixArt-α
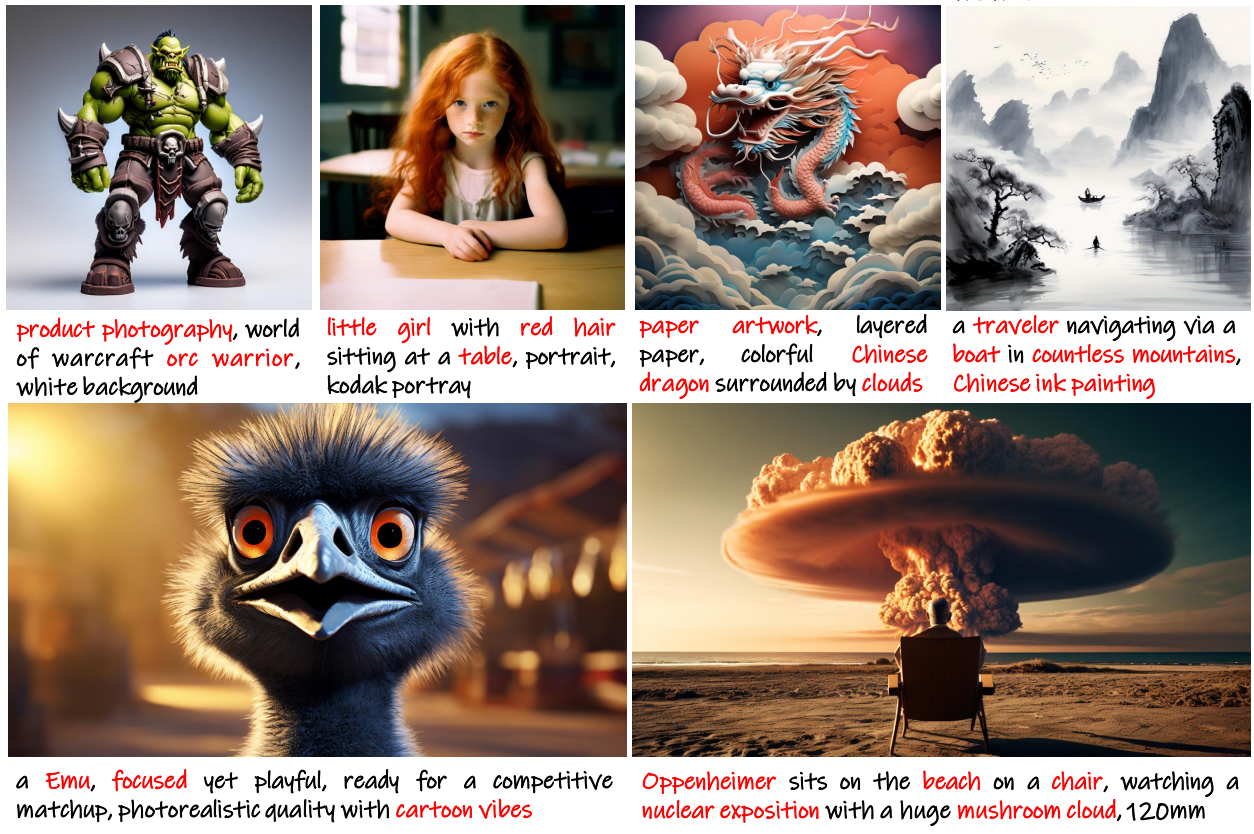
PixArt-α: Fast Training of Diffusion Transformer for Photorealistic Text-to-Image Synthesis 的作者是 Junsong Chen、Jincheng Yu、Chongjian Ge、Lewei Yao、Enze Xie、Yue Wu、Zhongdao Wang、James Kwok、Ping Luo、Huchuan Lu 和 Zhenguo Li。
该论文的摘要如下:
最先进的文本到图像(T2I)模型需要高昂的训练成本(例如数百万 GPU 小时),这严重阻碍了 AIGC 社区的基础创新,同时增加了 CO2 排放。本文介绍了 PIXART-α,这是一种基于 Transformer 的 T2I 扩散模型,其图像生成质量可与最先进的图像生成器(例如 Imagen、SDXL,甚至 Midjourney)相媲美,达到了接近商业应用的标准。此外,如图 1 和图 2 所示,它以较低的训练成本支持高达 1024px 分辨率的高分辨率图像合成。为实现这一目标,我们提出了三个核心设计:(1)训练策略分解:我们设计了三个不同的训练步骤,分别优化像素依赖、文本-图像对齐以及图像美学质量;(2)高效的 T2I Transformer:我们将交叉注意力模块引入 Diffusion Transformer (DiT),以注入文本条件并简化计算密集型的类别条件分支;(3)高信息量数据:我们强调了文本-图像对中概念密度的重要性,并利用大型视觉-语言模型自动标注密集的伪描述,以辅助文本-图像对齐学习。因此,PIXART-α 的训练速度显著超越了现有的大规模 T2I 模型,例如,PIXART-α 仅消耗 Stable Diffusion v1.5 训练时间的 10.8%(675 个 A100 GPU 天 vs. 6,250 个 A100 GPU 天),节省了约 300,000 美元(26,000 美元 vs. 320,000 美元),并减少了 90% 的 CO2 排放。此外,与更大的 SOTA 模型 RAPHAEL 相比,我们的训练成本仅为 1%。大量实验表明,PIXART-α 在图像质量、艺术性和语义控制方面表现出色。我们希望 PIXART-α 能为 AIGC 社区和初创公司提供新的见解,以加速从零开始构建高质量且低成本的生成模型。
您可以在 PixArt-alpha/PixArt-alpha 找到原始代码库,并在 PixArt-alpha 找到所有可用的检查点。
关于此流水线的一些说明:
- 它使用 Transformer 主干网络(而非 UNet)进行去噪。因此,其架构与 DiT 类似。
- 该模型使用从 T5 计算得出的文本条件进行训练。这一特性使该流水线在遵循包含复杂细节的复杂文本提示方面表现更佳。
- 它擅长生成不同宽高比的高分辨率图像。为了获得最佳效果,作者推荐了一些尺寸范围,可在此处找到。
- 其质量可与当前最先进的文本到图像生成系统(如 Stable Diffusion XL、Imagen 和 DALL-E 2)相媲美,同时效率更高。
请务必参阅 调度器指南,了解如何探索调度器速度与质量之间的权衡,并查看 跨流水线复用组件 部分,了解如何高效地将相同组件加载到多个流水线中。
在 GPU 显存低于 8GB 的情况下进行推理
通过以 8 位精度加载文本编码器,可以在 8GB 以下的 GPU 显存中运行 PixArtAlphaPipeline。下面通过一个完整的示例来说明。
首先,安装 bitsandbytes 库:
pip install -U bitsandbytes
然后以 8 位加载文本编码器:
from transformers import T5EncoderModel
from diffusers import PixArtAlphaPipeline
import torch

text_encoder = T5EncoderModel.from_pretrained(
    "PixArt-alpha/PixArt-XL-2-1024-MS",
    subfolder="text_encoder",
    load_in_8bit=True,
    device_map="auto",

)
pipe = PixArtAlphaPipeline.from_pretrained(
    "PixArt-alpha/PixArt-XL-2-1024-MS",
    text_encoder=text_encoder,
    transformer=None,
    device_map="auto"
)
现在,使用 pipe 对提示词进行编码:
with torch.no_grad():
    prompt = "cute cat"
    prompt_embeds, prompt_attention_mask, negative_embeds, negative_prompt_attention_mask = pipe.encode_prompt(prompt)
由于文本嵌入已经计算完成,请从内存中移除 text_encoder 和 pipe,以释放部分 GPU 显存:
import gc

def flush():
    gc.collect()
    torch.cuda.empty_cache()

del text_encoder
del pipe
flush()
然后使用提示嵌入作为输入来计算潜在变量:
pipe = PixArtAlphaPipeline.from_pretrained(
    "PixArt-alpha/PixArt-XL-2-1024-MS",
    text_encoder=None,
    dtype=torch.float16,
).to("cuda")  # or "mps", "xpu", "cpu"

latents = pipe(
    negative_prompt=None,
    prompt_embeds=prompt_embeds,
    negative_prompt_embeds=negative_embeds,
    prompt_attention_mask=prompt_attention_mask,
    negative_prompt_attention_mask=negative_prompt_attention_mask,
    num_images_per_prompt=1,
    output_type="latent",
).images

del pipe.transformer
flush()
请注意,在初始化
pipe时,你将text_encoder设置为None,以便不加载它。
潜变量计算完成后,将其传递给 VAE 解码为真实图像:
with torch.no_grad():
    image = pipe.vae.decode(latents / pipe.vae.config.scaling_factor, return_dict=False)[0]
image = pipe.image_processor.postprocess(image, output_type="pil")[0]
image.save("cat.png")
通过删除未使用的组件并释放 GPU 显存,您应该能够在 8GB 以下的 GPU 显存中运行 PixArtAlphaPipeline。
如果您想要一份内存使用情况的报告,请运行此 脚本。
以 8 位精度计算的文本嵌入可能会因精度降低导致表示空间中的信息丢失,从而影响生成图像的质量。建议对比使用和不使用 8 位精度时的输出结果。
在加载 text_encoder 时,您将 load_in_8bit 设置为 True。您也可以指定 load_in_4bit,将内存需求进一步降低到 7GB 以下。
PixArtAlphaPipeline
class diffusers.PixArtAlphaPipeline
< source >( tokenizer: T5Tokenizertext_encoder: T5EncoderModelvae: AutoencoderKLtransformer: PixArtTransformer2DModelscheduler: DPMSolverMultistepScheduler )
参数
- vae (AutoencoderKL) — 变分自编码器(VAE)模型,用于将图像编码为潜在表示,以及从潜在表示解码回图像。
- text_encoder (
T5EncoderModel) — 冻结的文本编码器。PixArt-Alpha 使用 T5,具体为 t5-v1_1-xxl 变体。 - tokenizer (
T5Tokenizer) — T5Tokenizer 类的分词器。 - transformer (PixArtTransformer2DModel) —
一个以文本为条件的
PixArtTransformer2DModel,用于对编码后的图像潜变量进行去噪。在配置中最初发布为Transformer2DModel,但此不一致可以忽略。 - scheduler (SchedulerMixin) —
用于与
transformer配合,对编码后的图像潜变量进行去噪的调度器。
使用 PixArt-Alpha 进行文本到图像生成的 Pipeline。
该模型继承自 DiffusionPipeline。有关该库为所有流水线实现的通用方法(例如下载或保存、在特定设备上运行等),请参阅父类文档。
__call__
< source >( prompt: str | list[str] = Nonenegative_prompt: str = ''num_inference_steps: int = 20timesteps: list = Nonesigmas: list = Noneguidance_scale: float = 4.5num_images_per_prompt: int | None = 1height: int | None = Nonewidth: int | None = Noneeta: float = 0.0generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneprompt_embeds: typing.Optional[torch.Tensor] = Noneprompt_attention_mask: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_attention_mask: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truecallback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1clean_caption: bool = Trueuse_resolution_binning: bool = Truemax_sequence_length: int = 120**kwargs ) → ImagePipelineOutput or tuple
参数
- prompt (
str或list[str],可选) — 用于引导图像生成的提示词或提示词列表。如果未定义,则必须改为传入prompt_embeds。 - negative_prompt (
str或list[str],可选) — 用于不引导图像生成的提示词。如果未定义,则必须传入negative_prompt_embeds。在未使用引导时会被忽略(即当guidance_scale小于1时忽略)。 - num_inference_steps (
int,可选,默认为 100) — 去噪步数。更多的去噪步数通常能生成更高质量的图像,但代价是推理速度变慢。 - timesteps (
list[int], 可选) — 用于支持timesteps参数的调度器去噪过程的自定义时间步,该参数位于其set_timesteps方法中。如果未定义,则使用传入num_inference_steps时的默认行为。必须按降序排列。 - sigmas (
list[float],可选) — 用于在支持sigmas参数的调度器的set_timesteps方法中,为去噪过程指定自定义的 sigmas。如果未定义,则使用传入num_inference_steps时的默认行为。 - guidance_scale (
float,可选,默认值为 4.5) — Classifier-Free Diffusion Guidance 中定义的引导尺度。guidance_scale定义为 Imagen Paper 中公式 2 的w。通过设置guidance_scale > 1来启用引导尺度。较高的引导尺度会促使生成与文本prompt紧密关联的图像,通常以牺牲图像质量为代价。 - num_images_per_prompt (
int,可选,默认为 1) — 每个提示词生成的图像数量。 - height (
int,可选,默认为 self.unet.config.sample_size) — 生成图像的高度(以像素为单位)。 - width (
int,可选,默认为 self.unet.config.sample_size) — 生成图像的宽度(以像素为单位)。 - eta(
float,可选,默认值为 0.0)— 对应 DDIM 论文中的参数 eta (η):https://huggingface.co/papers/2010.02502。仅适用于 schedulers.DDIMScheduler,对其他调度器将被忽略。 - generator (
torch.Generator或list[torch.Generator],可选) — 一个或一组 torch 生成器,用于使生成过程具有确定性。 - latents (
torch.Tensor, 可选) — 预先生成的噪声潜变量,从高斯分布中采样得到,用作图像生成的输入。可用于使用不同的提示词对同一生成过程进行微调。如果未提供,将通过使用提供的随机generator进行采样来生成一个潜变量张量。 - prompt_embeds (
torch.Tensor, 可选) — 预生成的文本嵌入。可用于轻松调整文本输入,例如 提示词加权。如果未提供,文本嵌入将从prompt输入参数生成。 - prompt_attention_mask (
torch.Tensor,可选) — 为文本嵌入预生成的注意力掩码。 - negative_prompt_embeds (
torch.Tensor, 可选) — 预生成的负向文本嵌入。对于 PixArt-Alpha,此负向提示应为 ""。如果未提供,negative_prompt_embeds 将根据negative_prompt输入参数生成。 - negative_prompt_attention_mask (
torch.Tensor, 可选) — 为负向文本嵌入预生成的注意力掩码。 - output_type (
str,可选,默认为"pil") — 生成图像的输出格式。可选值为 PIL:PIL.Image.Image或np.array。 - return_dict (
bool,可选,默认为True) — 是否返回~pipelines.stable_diffusion.IFPipelineOutput而不是普通元组。 - callback (
Callable, 可选) — 一个函数,将在推理过程中每callback_steps步被调用一次。该函数将以以下参数被调用:callback(step: int, timestep: int, latents: torch.Tensor)。 - callback_steps (
int,可选,默认为 1) —callback函数的调用频率。如果未指定,则回调将在每一步被调用。 - clean_caption (
bool,可选,默认为True) — 是否在创建嵌入之前清理字幕。需要安装beautifulsoup4和ftfy。如果未安装这些依赖项,嵌入将直接从原始提示创建。 - use_resolution_binning (
bool,默认为True) — 如果设置为True,请求的高度和宽度会先通过ASPECT_RATIO_1024_BIN映射到最接近的分辨率。生成的潜变量解码为图像后,会被重新调整回请求的分辨率。适用于生成非正方形图像。 - max_sequence_length(
int,默认为 120)— 与prompt配合使用的最大序列长度。
返回值
ImagePipelineOutput 或 tuple
如果 return_dict 为 True,则返回 ImagePipelineOutput;否则返回一个 tuple,其中第一个元素是包含生成图像的列表
调用生成 pipeline 时调用的函数。
示例:
>>> import torch
>>> from diffusers import PixArtAlphaPipeline

>>> # You can replace the checkpoint id with "PixArt-alpha/PixArt-XL-2-512x512" too.
>>> pipe = PixArtAlphaPipeline.from_pretrained("PixArt-alpha/PixArt-XL-2-1024-MS", torch_dtype=torch.float16)
>>> # Enable memory optimizations.
>>> pipe.enable_model_cpu_offload()

>>> prompt = "A small cactus with a happy face in the Sahara desert."
>>> image = pipe(prompt).images[0]
encode_prompt
< source >( prompt: str | list[str]do_classifier_free_guidance: bool = Truenegative_prompt: str = ''num_images_per_prompt: int = 1device: typing.Optional[torch.device] = Noneprompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Noneprompt_attention_mask: typing.Optional[torch.Tensor] = Nonenegative_prompt_attention_mask: typing.Optional[torch.Tensor] = Noneclean_caption: bool = Falsemax_sequence_length: int = 120**kwargs )
参数
- prompt (
str或list[str],可选) — 要编码的提示 - negative_prompt (
str或list[str],可选) — 用于不引导图像生成的提示词。如果未定义,则必须改为传入negative_prompt_embeds。在未使用引导时会被忽略(即当guidance_scale小于1时会被忽略)。对于 PixArt-Alpha,此值应为 ""。 - do_classifier_free_guidance (
bool,可选,默认为True) — 是否使用 classifier free guidance - num_images_per_prompt (
int,可选,默认为 1) — 每个提示词应生成的图像数量 - device — (
torch.device,可选): 用于放置生成的嵌入向量的 torch 设备 - prompt_embeds (
torch.Tensor, 可选) — 预生成的文本嵌入。可用于轻松调整文本输入,例如 提示词加权。如果未提供,文本嵌入将从prompt输入参数生成。 - negative_prompt_embeds (
torch.Tensor, 可选) — 预生成的负向文本嵌入。对于 PixArt-Alpha,它应该是空字符串 "" 的嵌入。 - clean_caption (
bool,默认为False) — 如果为True,该函数将在编码之前对提供的 caption 进行预处理和清理。 - max_sequence_length (
int,默认为 120) — 用于提示词的最大序列长度。
将提示词编码为文本编码器的隐藏状态。