
Diffusers documentation
Stable Diffusion 3
Stable Diffusion 3


O Stable Diffusion 3 (SD3) foi proposto em Scaling Rectified Flow Transformers for High-Resolution Image Synthesis por Patrick Esser, Sumith Kulal, Andreas Blattmann, Rahim Entezari, Jonas Muller, Harry Saini, Yam Levi, Dominik Lorenz, Axel Sauer, Frederic Boesel, Dustin Podell, Tim Dockhorn, Zion English, Kyle Lacey, Alex Goodwin, Yannik Marek e Robin Rombach.
O resumo do artigo é:
Os modelos de difusão criam dados a partir de ruído ao inverter os caminhos direcionais dos dados em direção ao ruído e surgiram como uma técnica poderosa de modelagem generativa para dados perceptuais de alta dimensão, como imagens e vídeos. O fluxo retificado é uma formulação recente de modelo generativo que conecta dados e ruído em uma linha reta. Apesar de suas melhores propriedades teóricas e simplicidade conceitual, ele ainda não foi estabelecido de forma decisiva como prática padrão. Neste trabalho, aprimoramos as técnicas existentes de amostragem de ruído para o treinamento de modelos de fluxo retificado, viésando-as em direção a escalas perceptualmente relevantes. Por meio de um estudo em larga escala, demonstramos o desempenho superior dessa abordagem em comparação com formulações de difusão estabelecidas para a síntese de texto para imagem em alta resolução. Além disso, apresentamos uma nova arquitetura baseada em transformadores para geração de texto para imagem que usa pesos separados para as duas modalidades e permite um fluxo bidirecional de informações entre tokens de imagem e texto, melhorando a compreensão do texto, a tipografia e as avaliações de preferência humana. Demonstramos que essa arquitetura segue tendências de escala previsíveis e correlaciona a perda de validação mais baixa com a melhoria da síntese de texto para imagem, medida por diversas métricas e avaliações humanas.
Exemplo de uso
Como o modelo é restrito, antes de usá-lo com diffusers, você precisa primeiro acessar a página do Stable Diffusion 3 Medium no Hugging Face, preencher o formulário e aceitar a restrição. Depois de ter acesso, é necessário fazer login para que o seu sistema saiba que você aceitou a restrição.
Use o comando abaixo para fazer login:
hf auth login
O pipeline SD3 usa três codificadores de texto para gerar uma imagem. O offloading de modelos é necessário para que ele seja executado na maioria dos hardwares comuns. Use o tipo de dados
torch.float16para economizar ainda mais memória.
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_pretrained("stabilityai/stable-diffusion-3-medium-diffusers", dtype=torch.float16)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

image = pipe(
    prompt="a photo of a cat holding a sign that says hello world",
    negative_prompt="",
    num_inference_steps=28,
    height=1024,
    width=1024,
    guidance_scale=7.0,
).images[0]

image.save("sd3_hello_world.png")
Observação: O Stable Diffusion 3.5 também pode ser executado usando o pipeline SD3, e todas as otimizações e técnicas mencionadas se aplicam a ele também. No total, existem três modelos oficiais na família SD3:
stabilityai/stable-diffusion-3-medium-diffusersstabilityai/stable-diffusion-3.5-largestabilityai/stable-diffusion-3.5-large-turbo
Prompting de Imagem com IP-Adapters
Um IP-Adapter permite que você use imagens, além do prompt de texto, para orientar o SD3. Isso é especialmente útil ao descrever conceitos complexos que são difíceis de articular apenas por meio de texto e quando você possui imagens de referência. Para carregar e usar um IP-Adapter, você precisa de:
image_encoder: Modelo de visão pré-treinado usado para obter recursos de imagem, geralmente um codificador de imagem CLIP.feature_extractor: Processador de imagem que prepara a imagem de entrada para oimage_encoderescolhido.ip_adapter_id: Checkpoint contendo os parâmetros das camadas de atenção cruzada de imagem e da projeção de imagem.
IP-Adapters são treinados para uma arquitetura de modelo específica, portanto, também funcionam em variações finetunadas do modelo base. Você pode usar a função ~SD3IPAdapterMixin.set_ip_adapter_scale para ajustar o quão fortemente a saída se alinha com o prompt de imagem. Quanto maior o valor, mais de perto o modelo segue o prompt de imagem. Um valor padrão de 0,5 geralmente é um bom equilíbrio, garantindo que o modelo considere os prompts de texto e imagem de forma igualitária.
import torch
from PIL import Image

from diffusers import StableDiffusion3Pipeline
from transformers import SiglipVisionModel, SiglipImageProcessor

image_encoder_id = "google/siglip-so400m-patch14-384"
ip_adapter_id = "InstantX/SD3.5-Large-IP-Adapter"

feature_extractor = SiglipImageProcessor.from_pretrained(
    image_encoder_id,
    dtype=torch.float16
)
image_encoder = SiglipVisionModel.from_pretrained(
    image_encoder_id,
    dtype=torch.float16
).to( "cuda")  # or "mps", "xpu", "cpu"

pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3.5-large",
    dtype=torch.float16,
    feature_extractor=feature_extractor,
    image_encoder=image_encoder,
).to("cuda")

pipe.load_ip_adapter(ip_adapter_id)
pipe.set_ip_adapter_scale(0.6)

ref_img = Image.open("image.jpg").convert('RGB')

image = pipe(
    width=1024,
    height=1024,
    prompt="a cat",
    negative_prompt="lowres, low quality, worst quality",
    num_inference_steps=24,
    guidance_scale=5.0,
    ip_adapter_image=ref_img
).images[0]

image.save("result.jpg")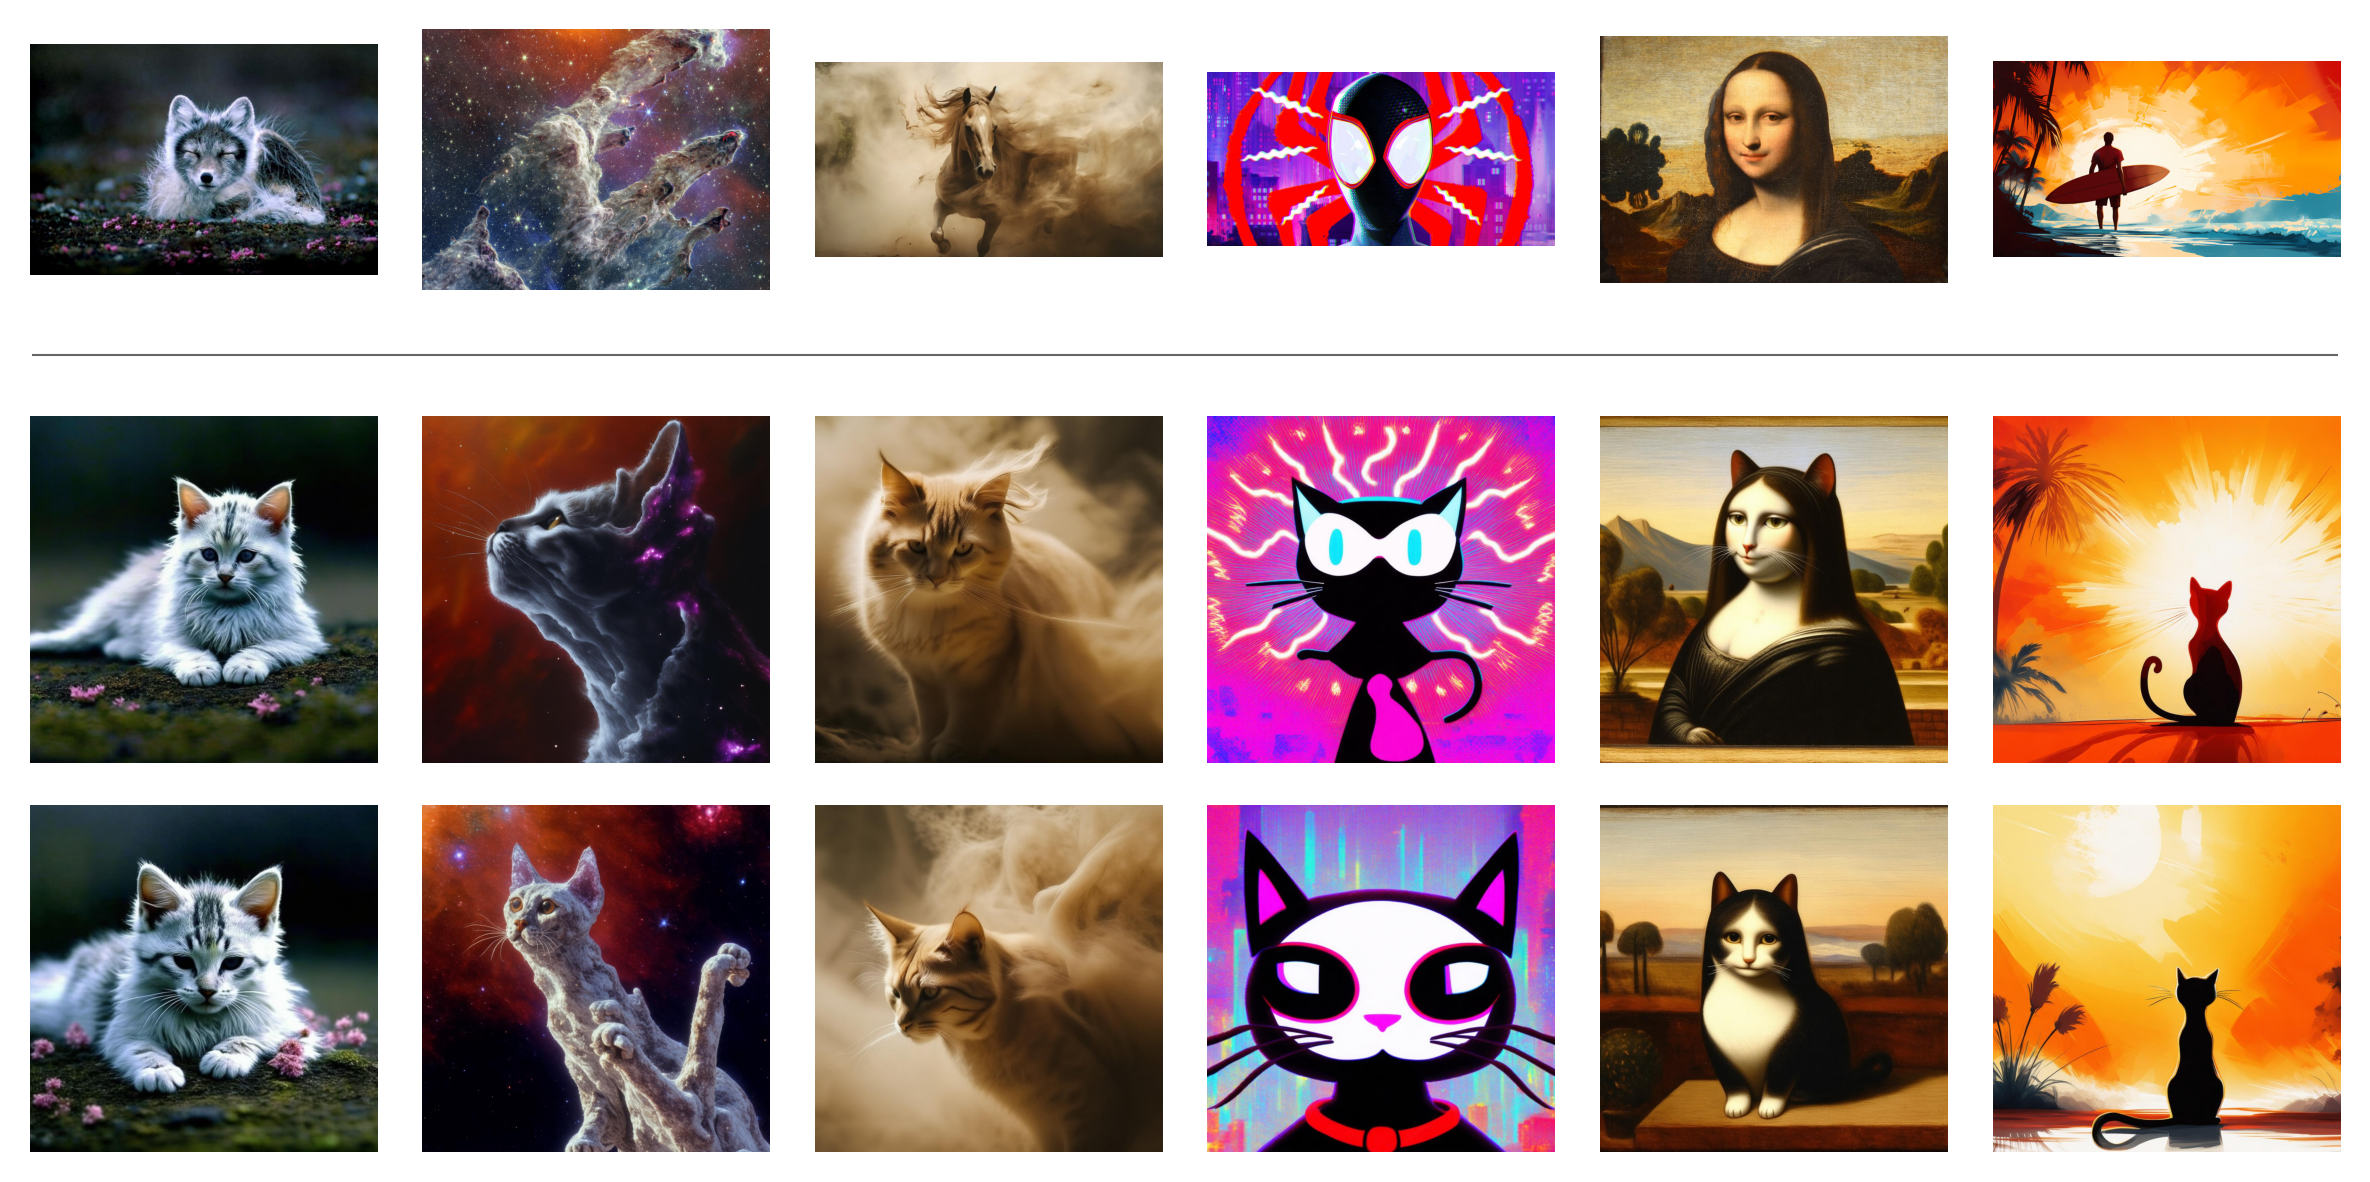
Confira o IP-Adapter para saber mais sobre como os IP-Adapters funcionam.
Otimizações de memória para SD3
O SD3 utiliza três codificadores de texto, sendo um deles o modelo T5-XXL, de tamanho muito grande. Isso torna desafiador executar o modelo em GPUs com menos de 24GB de VRAM, mesmo ao usar a precisão fp16. A seção a seguir descreve algumas otimizações de memória no Diffusers que facilitam a execução do SD3 em hardware com recursos limitados.
Executando Inferência com Deslocamento de Modelo
A otimização de memória mais básica disponível no Diffusers permite mover os componentes do modelo para a CPU durante a inferência, a fim de economizar memória, com um leve aumento na latência de inferência. O offloading do modelo move um componente do modelo para a GPU apenas quando ele precisa ser executado, mantendo os componentes restantes na CPU.
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_pretrained("stabilityai/stable-diffusion-3-medium-diffusers", dtype=torch.float16)
pipe.enable_model_cpu_offload()

image = pipe(
    prompt="a photo of a cat holding a sign that says hello world",
    negative_prompt="",
    num_inference_steps=28,
    height=1024,
    width=1024,
    guidance_scale=7.0,
).images[0]

image.save("sd3_hello_world.png")
Removendo o Codificador de Texto T5 durante a Inferência
Remover o codificador de texto T5-XXL de 4,7 bilhões de parâmetros, que consome muita memória, durante a inferência pode reduzir significativamente os requisitos de memória para o SD3, com apenas uma pequena perda de desempenho.
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3-medium-diffusers",
    text_encoder_3=None,
    tokenizer_3=None,
    dtype=torch.float16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

image = pipe(
    prompt="a photo of a cat holding a sign that says hello world",
    negative_prompt="",
    num_inference_steps=28,
    height=1024,
    width=1024,
    guidance_scale=7.0,
).images[0]

image.save("sd3_hello_world-no-T5.png")
Usando uma versão quantizada do codificador de texto T5
Podemos aproveitar a biblioteca bitsandbytes para carregar e quantizar o codificador de texto T5-XXL para precisão de 8 bits. Isso permite que você continue usando os três codificadores de texto com apenas um pequeno impacto no desempenho.
Primeiro, instale a biblioteca bitsandbytes.
pip install bitsandbytes
Em seguida, carregue o modelo T5-XXL usando o BitsAndBytesConfig.
import torch
from diffusers import StableDiffusion3Pipeline
from transformers import T5EncoderModel, BitsAndBytesConfig

quantization_config = BitsAndBytesConfig(load_in_8bit=True)

model_id = "stabilityai/stable-diffusion-3-medium-diffusers"
text_encoder = T5EncoderModel.from_pretrained(
    model_id,
    subfolder="text_encoder_3",
    quantization_config=quantization_config,
)
pipe = StableDiffusion3Pipeline.from_pretrained(
    model_id,
    text_encoder_3=text_encoder,
    device_map="balanced",
    dtype=torch.float16
)

image = pipe(
    prompt="a photo of a cat holding a sign that says hello world",
    negative_prompt="",
    num_inference_steps=28,
    height=1024,
    width=1024,
    guidance_scale=7.0,
).images[0]

image.save("sd3_hello_world-8bit-T5.png")
Você pode encontrar o script de ponta a ponta aqui.
Otimizações de desempenho para SD3
Usando Torch Compile para acelerar a inferência
O uso de componentes compilados no pipeline SD3 pode acelerar a inferência em até 4X. O trecho de código a seguir demonstra como compilar os componentes Transformer e VAE do pipeline SD3.
import torch
from diffusers import StableDiffusion3Pipeline

torch.set_float32_matmul_precision("high")

torch._inductor.config.conv_1x1_as_mm = True
torch._inductor.config.coordinate_descent_tuning = True
torch._inductor.config.epilogue_fusion = False
torch._inductor.config.coordinate_descent_check_all_directions = True

pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3-medium-diffusers",
    dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipe.set_progress_bar_config(disable=True)

pipe.transformer.to(memory_format=torch.channels_last)
pipe.vae.to(memory_format=torch.channels_last)

pipe.transformer = torch.compile(pipe.transformer, mode="max-autotune", fullgraph=True)
pipe.vae.decode = torch.compile(pipe.vae.decode, mode="max-autotune", fullgraph=True)

# Warm Up
prompt = "a photo of a cat holding a sign that says hello world"
for _ in range(3):
    _ = pipe(prompt=prompt, generator=torch.manual_seed(1))

# Run Inference
image = pipe(prompt=prompt, generator=torch.manual_seed(1)).images[0]
image.save("sd3_hello_world.png")
Confira o script completo aqui.
Quantização
A quantização ajuda a reduzir os requisitos de memória de modelos muito grandes armazenando os pesos do modelo em um tipo de dados de menor precisão. No entanto, a quantização pode ter um impacto variável na qualidade do vídeo, dependendo do modelo de vídeo.
Consulte a visão geral de Quantization para saber mais sobre os backends de quantização suportados e sobre como selecionar um backend de quantização que atenda ao seu caso de uso. O exemplo abaixo demonstra como carregar um StableDiffusion3Pipeline quantizado para inferência com bitsandbytes.
import torch
from diffusers import BitsAndBytesConfig as DiffusersBitsAndBytesConfig, SD3Transformer2DModel, StableDiffusion3Pipeline
from transformers import BitsAndBytesConfig as BitsAndBytesConfig, T5EncoderModel

quant_config = BitsAndBytesConfig(load_in_8bit=True)
text_encoder_8bit = T5EncoderModel.from_pretrained(
    "stabilityai/stable-diffusion-3.5-large",
    subfolder="text_encoder_3",
    quantization_config=quant_config,
    dtype=torch.float16,
)

quant_config = DiffusersBitsAndBytesConfig(load_in_8bit=True)
transformer_8bit = SD3Transformer2DModel.from_pretrained(
    "stabilityai/stable-diffusion-3.5-large",
    subfolder="transformer",
    quantization_config=quant_config,
    dtype=torch.float16,
)

pipeline = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3.5-large",
    text_encoder=text_encoder_8bit,
    transformer=transformer_8bit,
    dtype=torch.float16,
    device_map="balanced",
)

prompt = "a tiny astronaut hatching from an egg on the moon"
image = pipeline(prompt, num_inference_steps=28, guidance_scale=7.0).images[0]
image.save("sd3.png")
Usando prompts longos com o codificador de texto T5
Por padrão, o prompt do T5 Text Encoder usa um comprimento máximo de sequência de 256. Isso pode ser ajustado definindo o max_sequence_length para aceitar menos ou mais tokens. Tenha em mente que sequências mais longas exigem recursos adicionais e resultam em tempos de geração mais longos, como durante a inferência em lote.
prompt = "A whimsical and creative image depicting a hybrid creature that is a mix of a waffle and a hippopotamus, basking in a river of melted butter amidst a breakfast-themed landscape. It features the distinctive, bulky body shape of a hippo. However, instead of the usual grey skin, the creature’s body resembles a golden-brown, crispy waffle fresh off the griddle. The skin is textured with the familiar grid pattern of a waffle, each square filled with a glistening sheen of syrup. The environment combines the natural habitat of a hippo with elements of a breakfast table setting, a river of warm, melted butter, with oversized utensils or plates peeking out from the lush, pancake-like foliage in the background, a towering pepper mill standing in for a tree.  As the sun rises in this fantastical world, it casts a warm, buttery glow over the scene. The creature, content in its butter river, lets out a yawn. Nearby, a flock of birds take flight"

image = pipe(
    prompt=prompt,
    negative_prompt="",
    num_inference_steps=28,
    guidance_scale=4.5,
    max_sequence_length=512,
).images[0]
Enviando um prompt diferente para o T5 Text Encoder
Você pode enviar um prompt diferente para os CLIP Text Encoders e o T5 Text Encoder para evitar que o prompt seja truncado pelos CLIP Text Encoders e melhorar a geração.
O prompt com os CLIP Text Encoders ainda é truncado para o limite de 77 tokens.
prompt = "A whimsical and creative image depicting a hybrid creature that is a mix of a waffle and a hippopotamus, basking in a river of melted butter amidst a breakfast-themed landscape. A river of warm, melted butter, pancake-like foliage in the background, a towering pepper mill standing in for a tree."

prompt_3 = "A whimsical and creative image depicting a hybrid creature that is a mix of a waffle and a hippopotamus, basking in a river of melted butter amidst a breakfast-themed landscape. It features the distinctive, bulky body shape of a hippo. However, instead of the usual grey skin, the creature’s body resembles a golden-brown, crispy waffle fresh off the griddle. The skin is textured with the familiar grid pattern of a waffle, each square filled with a glistening sheen of syrup. The environment combines the natural habitat of a hippo with elements of a breakfast table setting, a river of warm, melted butter, with oversized utensils or plates peeking out from the lush, pancake-like foliage in the background, a towering pepper mill standing in for a tree.  As the sun rises in this fantastical world, it casts a warm, buttery glow over the scene. The creature, content in its butter river, lets out a yawn. Nearby, a flock of birds take flight"

image = pipe(
    prompt=prompt,
    prompt_3=prompt_3,
    negative_prompt="",
    num_inference_steps=28,
    guidance_scale=4.5,
    max_sequence_length=512,
).images[0]
Tiny AutoEncoder para Stable Diffusion 3
Tiny AutoEncoder for Stable Diffusion (TAESD3) é uma versão pequena e destilada do VAE do Stable Diffusion 3, criada por Ollin Boer Bohan, que consegue decodificar os latentes do StableDiffusion3Pipeline quase instantaneamente.
Para usar com Stable Diffusion 3:
import torch
from diffusers import StableDiffusion3Pipeline, AutoencoderTiny

pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3-medium-diffusers", dtype=torch.float16
)
pipe.vae = AutoencoderTiny.from_pretrained("madebyollin/taesd3", dtype=torch.float16)
pipe = pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt = "slice of delicious New York-style berry cheesecake"
image = pipe(prompt, num_inference_steps=25).images[0]
image.save("cheesecake.png")
Carregando os checkpoints originais via from_single_file
As classes SD3Transformer2DModel e StableDiffusion3Pipeline suportam o carregamento dos checkpoints originais por meio do método from_single_file. Esse método permite carregar os arquivos de checkpoint originais que foram usados para treinar os modelos.
Carregando os checkpoints originais para o SD3Transformer2DModel
from diffusers import SD3Transformer2DModel

model = SD3Transformer2DModel.from_single_file("https://huggingface.co/stabilityai/stable-diffusion-3-medium/blob/main/sd3_medium.safetensors")
Carregando o checkpoint único para o StableDiffusion3Pipeline
Carregando o checkpoint de arquivo único sem T5
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_single_file(
    "https://huggingface.co/stabilityai/stable-diffusion-3-medium/blob/main/sd3_medium_incl_clips.safetensors",
    dtype=torch.float16,
    text_encoder_3=None
)
pipe.enable_model_cpu_offload()

image = pipe("a picture of a cat holding a sign that says hello world").images[0]
image.save('sd3-single-file.png')
Carregando o checkpoint de arquivo único com T5
O exemplo a seguir carrega um checkpoint armazenado em formato de ponto flutuante de 8 bits, o que requer PyTorch 2.3 ou posterior.
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_single_file(
    "https://huggingface.co/stabilityai/stable-diffusion-3-medium/blob/main/sd3_medium_incl_clips_t5xxlfp8.safetensors",
    dtype=torch.float16,
)
pipe.enable_model_cpu_offload()

image = pipe("a picture of a cat holding a sign that says hello world").images[0]
image.save('sd3-single-file-t5-fp8.png')
Carregando o checkpoint de arquivo único para o Modelo Transformer do Stable Diffusion 3.5
import torch
from diffusers import SD3Transformer2DModel, StableDiffusion3Pipeline

transformer = SD3Transformer2DModel.from_single_file(
    "https://huggingface.co/stabilityai/stable-diffusion-3.5-large-turbo/blob/main/sd3.5_large.safetensors",
    dtype=torch.bfloat16,
)
pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3.5-large",
    transformer=transformer,
    dtype=torch.bfloat16,
)
pipe.enable_model_cpu_offload()
image = pipe("a cat holding a sign that says hello world").images[0]
image.save("sd35.png")
StableDiffusion3Pipeline
classe diffusers.StableDiffusion3Pipeline
< source >( transformer: SD3Transformer2DModelscheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtext_encoder: CLIPTextModelWithProjectiontokenizer: CLIPTokenizertext_encoder_2: CLIPTextModelWithProjectiontokenizer_2: CLIPTokenizertext_encoder_3: T5EncoderModeltokenizer_3: T5Tokenizerimage_encoder: SiglipVisionModel = Nonefeature_extractor: SiglipImageProcessorPil = None )
Parâmetros
- transformer (SD3Transformer2DModel) — Arquitetura de Transformer condicional (MMDiT) para desruidar os latentes da imagem codificada.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Um scheduler a ser usado em combinação com
transformerpara desruidar os latentes da imagem codificada. - vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
- text_encoder (
CLIPTextModelWithProjection) — CLIP, especificamente a variante clip-vit-large-patch14, com uma camada de projeção adicional que é inicializada com uma matriz diagonal comhidden_sizecomo sua dimensão. - text_encoder_2 (
CLIPTextModelWithProjection) — CLIP, especificamente a variante laion/CLIP-ViT-bigG-14-laion2B-39B-b160k. - text_encoder_3 (
T5EncoderModel) — Codificador de texto congelado. O Stable Diffusion 3 usa T5, especificamente a variante t5-v1_1-xxl. - tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - tokenizer_2 (
CLIPTokenizer) — Segundo Tokenizer da classe CLIPTokenizer. - tokenizer_3 (
T5TokenizerFast) — Tokenizer da classe T5Tokenizer. - image_encoder (
SiglipVisionModel, opcional) — Modelo de Visão pré-treinado para IP Adapter. - feature_extractor (
SiglipImageProcessor, opcional) — Processador de imagem para IP Adapter.
__call__
< source >( prompt: str | list[str] = Noneprompt_2: str | list[str] | None = Noneprompt_3: str | list[str] | None = Noneheight: int | None = Nonewidth: int | None = Nonenum_inference_steps: int = 28sigmas: list[float] | None = Noneguidance_scale: float = 7.0negative_prompt: str | list[str] | None = Nonenegative_prompt_2: str | list[str] | None = Nonenegative_prompt_3: str | list[str] | None = Nonenum_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.FloatTensor] = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonenegative_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneip_adapter_image_embeds: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truejoint_attention_kwargs: dict[str, typing.Any] | None = Noneclip_skip: int | None = Nonecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']max_sequence_length: int = 256skip_guidance_layers: list = Noneskip_layer_guidance_scale: float = 2.8skip_layer_guidance_stop: float = 0.2skip_layer_guidance_start: float = 0.01mu: float | None = None ) → ~pipelines.stable_diffusion_3.StableDiffusion3PipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str], opcional) — O prompt ou os prompts para orientar a geração da imagem. Se não for definido, é necessário passarprompt_embedsem vez disso. - prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts a serem enviados paratokenizer_2etext_encoder_2. Se não definido,promptserá usado no lugar - prompt_3 (
stroulist[str], opcional) — O prompt ou os prompts a serem enviados paratokenizer_3etext_encoder_3. Se não definido,promptserá usado no lugar - height (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A altura em pixels da imagem gerada. Isso é definido como 1024 por padrão para os melhores resultados. - width (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A largura em pixels da imagem gerada. O padrão é 1024 para os melhores resultados. - num_inference_steps (
int, opcional, padrão 50) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - sigmas (
list[float], opcional) — Sigmas personalizados para usar no processo de desruidamento com agendadores que suportam um argumentosigmasem seu métodoset_timesteps. Se não definido, o comportamento padrão quandonum_inference_stepsé passado será usado. - guidance_scale (
float, opcional, padrão 7.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2 do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - negative_prompt (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem. Se não for definido, é necessário passarnegative_prompt_embedsem vez disso. Ignorado quando não se usa orientação (ou seja, ignorado seguidance_scalefor menor que1). - negative_prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts que não devem guiar a geração da imagem a serem enviados paratokenizer_2etext_encoder_2. Se não definido,negative_prompté usado no lugar - negative_prompt_3 (
stroulist[str], opcional) — O prompt ou os prompts que não devem guiar a geração da imagem a serem enviados paratokenizer_3etext_encoder_3. Se não definido,negative_prompté usado no lugar - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.FloatTensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - negative_prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto negativas pré-geradas. Pode ser usado para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não for fornecido, negative_prompt_embeds será gerado a partir do argumento de entradanegative_prompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - negative_pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto negativo pré-gerados. Pode ser usado para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompt. Se não for fornecido, os pooled negative_prompt_embeds serão gerados a partir do argumento de entradanegative_prompt. - ip_adapter_image (
PipelineImageInput, opcional) — Entrada de imagem opcional para trabalhar com IP Adapters. - ip_adapter_image_embeds (
torch.Tensor, opcional) — Incorporações de imagem pré-geradas para IP-Adapter. Deve ser um tensor de forma(batch_size, num_images, emb_dim). Deve conter a incorporação de imagem negativa sedo_classifier_free_guidanceestiver definido comoTrue. Se não for fornecido, as incorporações são calculadas a partir do argumento de entradaip_adapter_image. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre PIL:PIL.Image.Imageounp.array. - return_dict (
bool, opcional, padrãoTrue) — Indica se deve retornar um~pipelines.stable_diffusion_3.StableDiffusion3PipelineOutputem vez de uma tupla simples. - joint_attention_kwargs (
dict, opcional) — Um dicionário de kwargs que, se especificado, é passado aoAttentionProcessorconforme definido emself.processorem diffusers.models.attention_processor. - clip_skip (
int, opcional) — Número de camadas a serem ignoradas do CLIP ao calcular os embeddings do prompt. Um valor de 1 significa que a saída da camada pré-final será usada para calcular os embeddings do prompt. - callback_on_step_end (
Callable, opcional) — Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargsincluirá uma lista de todos os tensores, conforme especificado porcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, opcional) — A lista de entradas de tensor para a funçãocallback_on_step_end. Os tensores especificados na lista serão passados como argumentocallback_kwargs. Você só poderá incluir variáveis listadas no atributo._callback_tensor_inputsda sua classe de pipeline. - max_sequence_length (
intpadrão 256) — Comprimento máximo da sequência a ser usado com oprompt. - skip_guidance_layers (
list[int], opcional) — Uma lista de inteiros que especifica as camadas a serem ignoradas durante o guidance. Se não for fornecida, todas as camadas serão usadas para o guidance. Se fornecida, o guidance será aplicado apenas às camadas especificadas na lista. O valor recomendado pela StabiltyAI para o Stable Diffusion 3.5 Medium é [7, 8, 9]. - skip_layer_guidance_scale (
int, opcional) — A escala da orientação para as camadas especificadas emskip_guidance_layers. A orientação será aplicada às camadas especificadas emskip_guidance_layerscom uma escala deskip_layer_guidance_scale. A orientação será aplicada ao restante das camadas com uma escala de1. - skip_layer_guidance_stop (
int, opcional) — O passo em que a orientação para as camadas especificadas emskip_guidance_layersserá interrompida. A orientação será aplicada às camadas especificadas emskip_guidance_layersaté a fração especificada emskip_layer_guidance_stop. O valor recomendado pela StabiltyAI para o Stable Diffusion 3.5 Medium é 0.2. - skip_layer_guidance_start (
int, opcional) — O passo em que a orientação para as camadas especificadas emskip_guidance_layerscomeçará. A orientação será aplicada às camadas especificadas emskip_guidance_layersa partir da fração especificada emskip_layer_guidance_start. O valor recomendado pela StabiltyAI para o Stable Diffusion 3.5 Medium é 0.01. - mu (
float, opcional) — valor demuusado paradynamic_shifting.
Retorna
~pipelines.stable_diffusion_3.StableDiffusion3PipelineOutput ou tuple
~pipelines.stable_diffusion_3.StableDiffusion3PipelineOutput se return_dict for True, caso contrário, uma
tuple. Ao retornar uma tupla, o primeiro elemento é uma lista com as imagens geradas.
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> import torch
>>> from diffusers import StableDiffusion3Pipeline

>>> pipe = StableDiffusion3Pipeline.from_pretrained(
...     "stabilityai/stable-diffusion-3-medium-diffusers", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")
>>> prompt = "A cat holding a sign that says hello world"
>>> image = pipe(prompt).images[0]
>>> image.save("sd3.png")
encode_image
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]device: device ) → torch.Tensor
Codifica a imagem fornecida em uma representação de características usando um codificador de imagem pré-treinado.
encode_prompt
< source >( prompt: str | list[str]prompt_2: str | list[str]prompt_3: str | list[str]device: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1do_classifier_free_guidance: bool = Truenegative_prompt: str | list[str] | None = Nonenegative_prompt_2: str | list[str] | None = Nonenegative_prompt_3: str | list[str] | None = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonenegative_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneclip_skip: int | None = Nonemax_sequence_length: int = 256lora_scale: float | None = None )
Parâmetros
- prompt (
stroulist[str], opcional) — prompt a ser codificado - prompt_2 (
stroulist[str], opcional) — O prompt ou prompts a serem enviados para otokenizer_2e otext_encoder_2. Se não definido,prompté usado em todos os text-encoders - prompt_3 (
stroulist[str], opcional) — O prompt ou os prompts a serem enviados para otokenizer_3e otext_encoder_3. Se não definido,prompté usado em todos os text-encoders - device — (
torch.device): dispositivo torch - num_images_per_prompt (
int) — número de imagens que devem ser geradas por prompt - do_classifier_free_guidance (
bool) — se deve usar classifier free guidance ou não - negative_prompt (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem. Se não for definido, é necessário passarnegative_prompt_embedsem vez disso. Ignorado quando não se usa orientação (ou seja, ignorado seguidance_scalefor menor que1). - negative_prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem a serem enviados paratokenizer_2etext_encoder_2. Se não definido,negative_prompté usado em todos os text-encoders. - negative_prompt_3 (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem a serem enviados paratokenizer_3etext_encoder_3. Se não definido,negative_prompté usado em todos os text-encoders. - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - negative_prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto negativas pré-geradas. Pode ser usado para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não for fornecido, negative_prompt_embeds será gerado a partir do argumento de entradanegative_prompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - negative_pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto negativo pré-gerados. Pode ser usado para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompt. Se não for fornecido, os pooled negative_prompt_embeds serão gerados a partir do argumento de entradanegative_prompt. - clip_skip (
int, opcional) — Número de camadas a serem ignoradas do CLIP ao calcular os embeddings do prompt. Um valor de 1 significa que a saída da camada pré-final será usada para calcular os embeddings do prompt. - lora_scale (
float, opcional) — Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
prepare_ip_adapter_image_embeds
< source >( ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneip_adapter_image_embeds: typing.Optional[torch.Tensor] = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1do_classifier_free_guidance: bool = True )
Parâmetros
- ip_adapter_image (
PipelineImageInput, opcional) — A imagem de entrada para extrair os recursos para o IP-Adapter. - ip_adapter_image_embeds (
torch.Tensor, opcional) — Incorporações de imagem pré-computadas. - device — (
torch.device, opcional): Dispositivo Torch. - num_images_per_prompt (
int, padrão 1) — Número de imagens que devem ser geradas por prompt. - do_classifier_free_guidance (
bool, padrão True) — Se deve ou não usar classifier free guidance.
Prepara embeddings de imagem para uso no IP-Adapter.
É necessário passar ip_adapter_image ou ip_adapter_image_embeds.