
Diffusers documentation
Marigold Computer Vision
Marigold Computer Vision
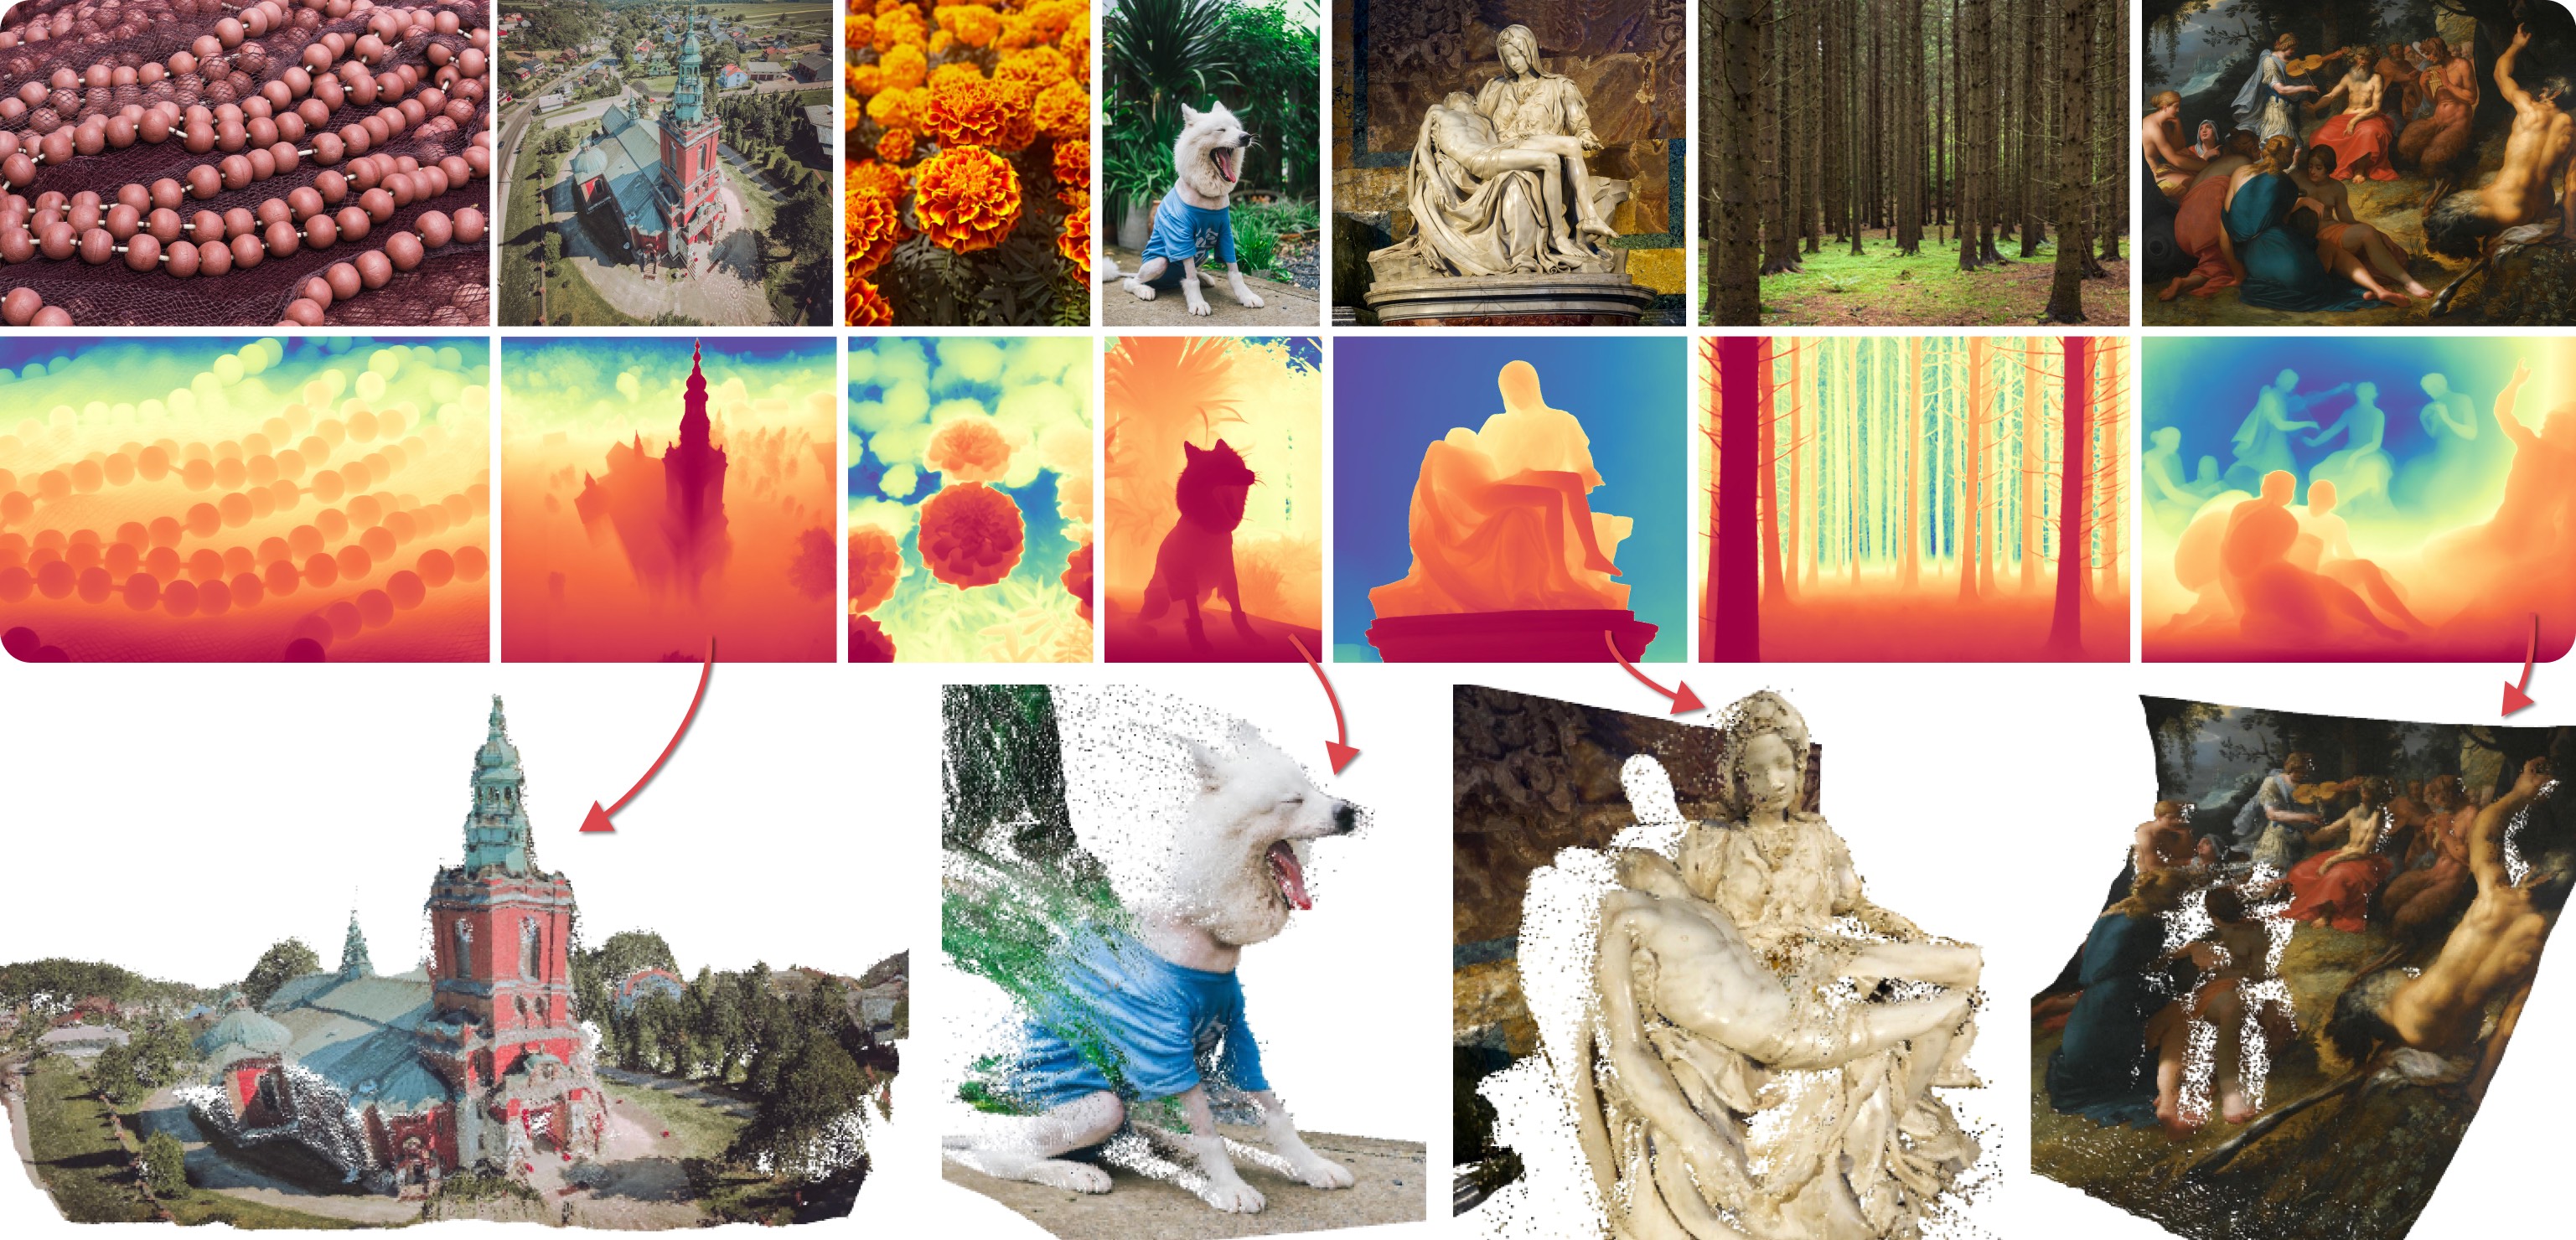
Marigold se propuso en Repurposing Diffusion-Based Image Generators for Monocular Depth Estimation, un artículo Oral de CVPR 2024 de Bingxin Ke, Anton Obukhov, Shengyu Huang, Nando Metzger, Rodrigo Caye Daudt y Konrad Schindler. La idea central es reutilizar el prior generativo de los Modelos de Difusión Latente de Texto a Imagen (LDM) para tareas tradicionales de visión por computadora. Este enfoque se exploró mediante el ajuste fino de Stable Diffusion para Monocular Depth Estimation, como se muestra en la imagen de arriba.
Marigold se amplió posteriormente en el artículo de seguimiento, Marigold: Affordable Adaptation of Diffusion-Based Image Generators for Image Analysis, autoría de Bingxin Ke, Kevin Qu, Tianfu Wang, Nando Metzger, Shengyu Huang, Bo Li, Anton Obukhov y Konrad Schindler. Este trabajo expandió Marigold para soportar nuevas modalidades como Surface Normals y Intrinsic Image Decomposition (IID), introdujo un protocolo de entrenamiento para Latent Consistency Models (LCM) y demostró la capacidad de procesamiento en High-Resolution (HR).
Los modelos de Marigold iniciales (
v1-0y anteriores) estaban optimizados para obtener los mejores resultados con al menos 10 pasos de inferencia. Los modelos LCM se desarrollaron posteriormente para permitir una inferencia de alta calidad en solo 1 a 4 pasos. Los modelos de Marigoldv1-1y posteriores utilizan el programador DDIM para lograr resultados óptimos en tan solo 1 a 4 pasos.
Pipelines disponibles
Cada pipeline está diseñado para una tarea específica de visión por computadora, procesa una imagen RGB de entrada y genera una predicción correspondiente. Actualmente, se han implementado las siguientes tareas de visión por computadora:
| Pipeline | Puntos de control de modelos recomendados | Spaces (Aplicaciones interactivas) | Modalidades predichas |
|---|---|---|---|
| MarigoldDepthPipeline | prs-eth/marigold-depth-v1-1 | Estimación de profundidad | Profundidad, Disparidad |
| MarigoldNormalsPipeline | prs-eth/marigold-normals-v1-1 | Estimación de normales de superficie | Normales de superficie |
| MarigoldIntrinsicsPipeline | prs-eth/marigold-iid-appearance-v1-1, prs-eth/marigold-iid-lighting-v1-1 | Descomposición de imagen intrínseca | Albedo, Materiales, Iluminación |
Puntos de control disponibles
Todos los puntos de control originales están disponibles bajo la organización PRS-ETH en Hugging Face. Están diseñados para su uso con pipelines de diffusers y el original codebase, que también puede utilizarse para entrenar nuevos puntos de control de modelos. A continuación se presenta un resumen de los puntos de control recomendados, todos los cuales producen resultados fiables con 1 a 4 pasos.
| Checkpoint | Modalidad | Comentario |
|---|---|---|
| prs-eth/marigold-depth-v1-1 | Profundidad | La predicción de profundidad invariante a afinidades asigna a cada píxel un valor entre 0 (plano cercano) y 1 (plano lejano), donde ambos planos son determinados por el modelo durante la inferencia. |
| prs-eth/marigold-normals-v0-1 | Normales | Las predicciones de normales de superficie son vectores 3D de longitud unitaria en el espacio de la cámara de la pantalla, con valores en el rango de -1 a 1. |
| prs-eth/marigold-iid-appearance-v1-1 | Intrínsecos | La descomposición de InteriorVerse está compuesta por el Albedo y dos propiedades de material BRDF: Roughness y Metallicity. |
| prs-eth/marigold-iid-lighting-v1-1 | Intrínsecos | Descomposición de una imagen en HyperSim está compuesta por el Albedo $A$, la iluminación difusa $S$ y el residuo no difuso $R$: $I = A*S+R$. |
Asegúrate de consultar la guía de Schedulers para aprender a explorar el equilibrio entre la velocidad y la calidad del scheduler, y consulta la sección reuse components across pipelines para aprender a cargar de forma eficiente los mismos componentes en varios pipelines. Además, para saber más sobre cómo reducir el uso de memoria de este pipeline, consulta la sección [“Reduce memory usage”] aquí.
Los pipelines de Marigold se diseñaron y probaron con el scheduler integrado en el checkpoint del modelo. El número óptimo de pasos de inferencia varía según el scheduler, y no existe un valor universal que funcione mejor en todos los casos. Para adaptarse a esto, el parámetro
num_inference_stepsen el método__call__del pipeline tiene un valor predeterminado deNone(consulte la referencia de la API). A menos que se establezca explícitamente, hereda el valor del campodefault_denoising_stepsen el archivo de configuración del checkpoint (model_index.json). Esto garantiza predicciones de alta calidad al invocar el pipeline solo con el argumentoimage.
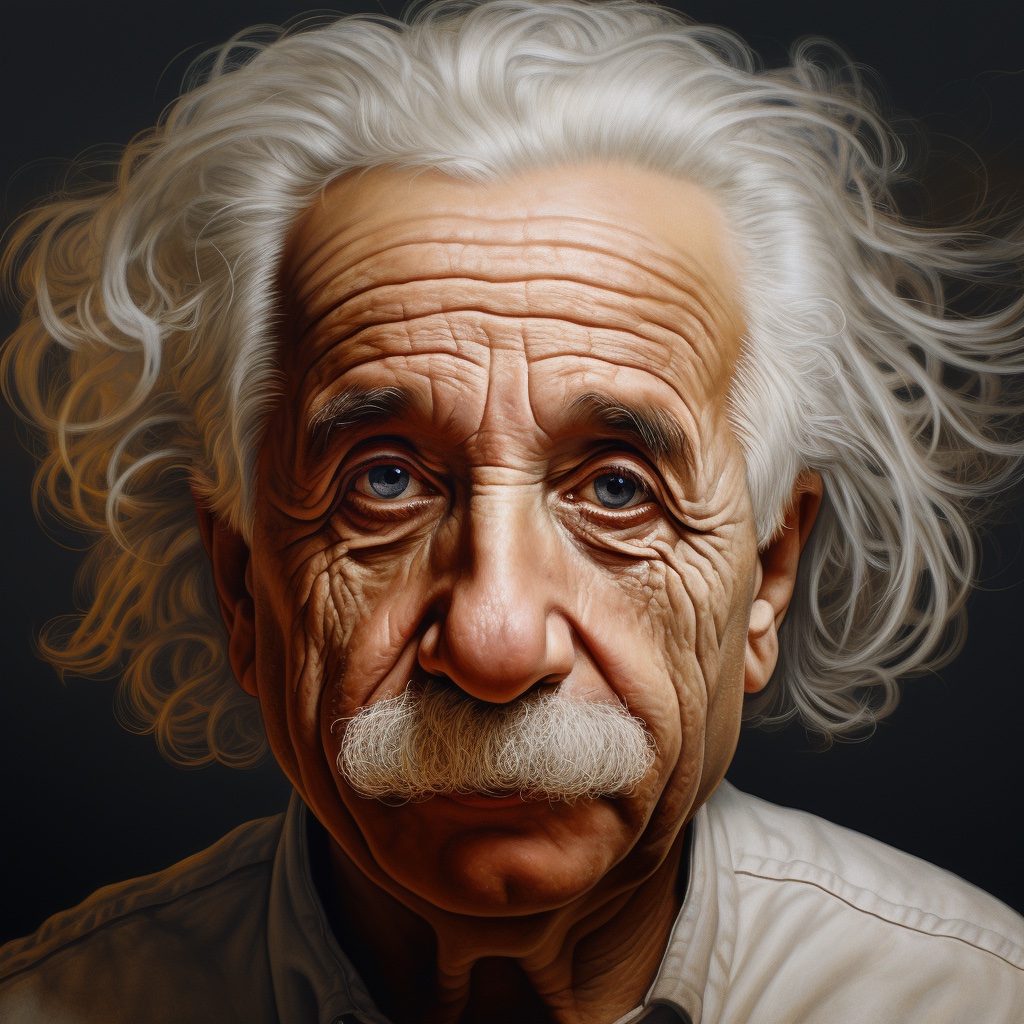
Los ejemplos a continuación se presentan principalmente para la predicción de profundidad, pero pueden aplicarse universalmente a otras modalidades admitidas. Mostramos las predicciones utilizando la misma imagen de entrada de Albert Einstein generada por Midjourney. Esto facilita la comparación de las visualizaciones de las predicciones entre las distintas modalidades y puntos de control.
Predicción de profundidad
Para obtener una predicción de profundidad, carga el punto de control prs-eth/marigold-depth-v1-1 en MarigoldDepthPipeline,
pasa la imagen por el pipeline y guarda las predicciones:
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(image)

vis = pipe.image_processor.visualize_depth(depth.prediction)
vis[0].save("einstein_depth.png")

depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
depth_16bit[0].save("einstein_depth_16bit.png")
La función visualize_depth() aplica uno de los colormaps de matplotlib (Spectral por defecto) para mapear los valores de píxel predichos de un rango de profundidad de un solo canal [0, 1] a una imagen RGB.
Con el colormap Spectral, los píxeles con profundidad cercana se pintan de rojo y los píxeles lejanos, de azul.
El archivo PNG de 16 bits almacena los valores de un solo canal mapeados linealmente desde el rango [0, 1] hasta [0, 65535].
A continuación se muestran las predicciones en bruto y las visualizadas. Las áreas más oscuras y cercanas (bigote) son más fáciles de distinguir en
la visualización.


Estimación de normales de superficie
Carga el punto de control prs-eth/marigold-normals-v1-1 en MarigoldNormalsPipeline, procesa la imagen a través de la tubería y guarda las predicciones:
import diffusers
import torch

pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
    "prs-eth/marigold-normals-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

normals = pipe(image)

vis = pipe.image_processor.visualize_normals(normals.prediction)
vis[0].save("einstein_normals.png")
La función visualize_normals() mapea la predicción tridimensional, con valores de píxeles en el rango [-1, 1], a una imagen RGB.
La función de visualización admite la inversión de los ejes de las normales de la superficie para hacer que la visualización sea compatible con otras
elecciones del sistema de referencia.
Conceptualmente, cada píxel se pinta según el vector de la normal de la superficie en el sistema de referencia, donde el eje X
apunta a la derecha, el eje Y apunta hacia arriba y el eje Z apunta hacia el espectador.
A continuación se muestra la predicción visualizada:

En este ejemplo, la punta de la nariz casi con seguridad tiene un punto en la superficie en el que el vector normal de la superficie apunta directamente hacia el espectador, lo que significa que sus coordenadas son [0, 0, 1].
Este vector se mapea al RGB [128, 128, 255], que corresponde al color violeta-azulado.
De manera similar, una normal de superficie en la mejilla de la parte derecha de la imagen tiene un componente X grande, lo que aumenta el tono rojo.
Los puntos en los hombros que apuntan hacia arriba con un Y grande promueven el color verde.
Descomposición de imagen intrínseca
Marigold ofrece dos modelos para la Descomposición de Imágenes Intrínsecas (IID): “Appearance” y “Lighting”. Cada modelo produce mapas de Albedo, derivados de las anotaciones de InteriorVerse y Hypersim, respectivamente.
- El modelo “Appearance” también estima las propiedades de Material: Roughness y Metallicity.
- El modelo “Lighting” genera Diffuse Shading y Non-diffuse Residual.
A continuación se muestra el código de ejemplo que guarda las predicciones realizadas por el modelo “Appearance”:
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["roughness"].save("einstein_roughness.png")
vis[0]["metallicity"].save("einstein_metallicity.png")
Otro ejemplo que muestra las predicciones realizadas por el modelo “Lighting”:
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["shading"].save("einstein_shading.png")
vis[0]["residual"].save("einstein_residual.png")
Ambos modelos comparten el mismo pipeline mientras admiten diferentes tipos de descomposición.
La parametrización exacta de la descomposición (p. ej., espacio sRGB vs. espacio lineal) se almacena en el diccionario pipe.target_properties, que se pasa a la función visualize_intrinsics().
A continuación se muestran algunos ejemplos que ilustran las salidas de descomposición predichas. Todas las modalidades pueden inspeccionarse en el Espacio Intrinsic Image Decomposition.


Acelerar la inferencia
Los fragmentos de inicio rápido anteriores ya están optimizados para calidad y velocidad: cargan el punto de control, utilizan la variante fp16 de pesos y cómputo, y ejecutan el número predeterminado (4) de pasos de difusión de desruido.
El primer paso para acelerar la inferencia, a costa de la calidad de la predicción, es reducir los pasos de difusión de desruido al mínimo:
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=1)
Con este cambio, la llamada pipe se completa en 280 ms en una GPU RTX 3090.
Internamente, la imagen de entrada se codifica primero con el codificador VAE de Stable Diffusion, seguido de un único paso de desruido realizado por la U-Net.
Finalmente, el latente de predicción se decodifica con el decodificador VAE al espacio de píxeles.
En esta configuración, dos de las tres llamadas a módulos están dedicadas a convertir entre los espacios de píxeles y latentes del LDM.
Dado que el espacio latente de Marigold es compatible con Stable Diffusion 2.0, la inferencia puede acelerarse más de 3 veces,
reduciendo el tiempo de llamada a 85 ms en una RTX 3090, mediante el uso de un sustituto ligero del VAE de SD.
Tenga en cuenta que el uso de un VAE ligero puede reducir ligeramente la calidad visual de las predicciones.
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
+     "madebyollin/taesd", dtype=torch.float16
+ ).cuda()

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Hasta ahora, hemos optimizado el número de pasos de difusión y los componentes del modelo. Las operaciones de autoatención representan una parte significativa de los cálculos. Pueden acelerarse utilizando un procesador de atención más eficiente:
  import diffusers
  import torch
+ from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae.set_attn_processor(AttnProcessor2_0())
+ pipe.unet.set_attn_processor(AttnProcessor2_0())

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Por último, tal como se sugiere en Optimizations, habilitar torch.compile puede mejorar aún más el rendimiento dependiendo del hardware objetivo.
Sin embargo, la compilación implica un sobrecoste significativo durante la primera invocación del pipeline, por lo que solo resulta beneficioso cuando la misma instancia del pipeline se llama repetidamente, como dentro de un bucle.
  import diffusers
  import torch
  from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  pipe.vae.set_attn_processor(AttnProcessor2_0())
  pipe.unet.set_attn_processor(AttnProcessor2_0())

+ pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Maximizar la precisión y el ensembling
Los pipelines de Marigold tienen un mecanismo de ensembling integrado que combina múltiples predicciones a partir de diferentes latentes aleatorios.
Esta es una forma de fuerza bruta de mejorar la precisión de las predicciones, aprovechando la naturaleza generativa de la difusión.
La ruta de ensembling se activa automáticamente cuando el argumento ensemble_size se establece en un valor mayor o igual que 3.
Cuando se busca la máxima precisión, tiene sentido ajustar num_inference_steps simultáneamente con ensemble_size.
Los valores recomendados varían entre puntos de control, pero dependen principalmente del tipo de programador.
El efecto del ensembling se aprecia especialmente bien con las normales de superficie:
  import diffusers

  pipe = diffusers.MarigoldNormalsPipeline.from_pretrained("prs-eth/marigold-normals-v1-1").to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=10, ensemble_size=5)

  vis = pipe.image_processor.visualize_normals(depth.prediction)
vis[0].save("einstein_normals.png") 
Como se puede observar, todas las áreas con estructuras de grano fino, como el cabello, obtuvieron predicciones más conservadoras y, en promedio, más correctas. Tal resultado es más adecuado para tareas posteriores sensibles a la precisión, como la reconstrucción 3D.
Procesamiento de video cuadro a cuadro con consistencia temporal
Debido a la naturaleza generativa de Marigold, cada predicción es única y está definida por el ruido aleatorio muestreado para la inicialización latente. Esto se convierte en un inconveniente evidente en comparación con las redes de regresión densa de extremo a extremo tradicionales, como se ilustra en los siguientes videos:


Para abordar este problema, es posible pasar el argumento latents a los pipelines, lo que define el punto de partida de la difusión.
Empíricamente, encontramos que una combinación convexa del mismo ruido latente de punto de partida y el latente correspondiente a la predicción del fotograma anterior produce resultados suficientemente suaves, tal como se implementa en el fragmento de código a continuación:
import imageio
import diffusers
import torch
from diffusers.models.attention_processor import AttnProcessor2_0
from PIL import Image
from tqdm import tqdm

device = "cuda"  # or "mps", "xpu", "cpu"
path_in = "https://huggingface.co/spaces/prs-eth/marigold-lcm/resolve/c7adb5427947d2680944f898cd91d386bf0d4924/files/video/obama.mp4"
path_out = "obama_depth.gif"

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to(device)
pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
    "madebyollin/taesd", dtype=torch.float16
).to(device)
pipe.unet.set_attn_processor(AttnProcessor2_0())
pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
pipe.set_progress_bar_config(disable=True)

with imageio.get_reader(path_in) as reader:
    size = reader.get_meta_data()['size']
    last_frame_latent = None
    latent_common = torch.randn(
        (1, 4, 768 * size[1] // (8 * max(size)), 768 * size[0] // (8 * max(size)))
    ).to(device=device, dtype=torch.float16)

    out = []
    for frame_id, frame in tqdm(enumerate(reader), desc="Processing Video"):
        frame = Image.fromarray(frame)
        latents = latent_common
        if last_frame_latent is not None:
            latents = 0.9 * latents + 0.1 * last_frame_latent

        depth = pipe(
            frame,
            num_inference_steps=1,
            match_input_resolution=False,
            latents=latents,
            output_latent=True,
        )
        last_frame_latent = depth.latent
        out.append(pipe.image_processor.visualize_depth(depth.prediction)[0])

    diffusers.utils.export_to_gif(out, path_out, fps=reader.get_meta_data()['fps'])
Aquí, el proceso de difusión comienza desde el latente calculado dado.
La pipeline establece output_latent=True para acceder a out.latent y calcula su contribución a la inicialización del latente del siguiente fotograma.
El resultado es mucho más estable ahora:

Marigold para ControlNet
Una aplicación muy común para la predicción de profundidad con modelos de difusión se da en conjunto con ControlNet. La nitidez de la profundidad desempeña un papel crucial para obtener resultados de alta calidad con ControlNet. Como se observa en las comparaciones con otros métodos anteriores, Marigold destaca en esa tarea. El fragmento de código a continuación demuestra cómo cargar una imagen, calcular la profundidad y pasarla a ControlNet en un formato compatible:
import torch
import diffusers

device = "cuda"  # or "mps", "xpu", "cpu"
generator = torch.Generator(device=device).manual_seed(2024)
image = diffusers.utils.load_image(
    "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/controlnet_depth_source.png"
)

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", dtype=torch.float16, variant="fp16"
).to(device)

depth_image = pipe(image, generator=generator).prediction
depth_image = pipe.image_processor.visualize_depth(depth_image, color_map="binary")
depth_image[0].save("motorcycle_controlnet_depth.png")

controlnet = diffusers.ControlNetModel.from_pretrained(
    "diffusers/controlnet-depth-sdxl-1.0", dtype=torch.float16, variant="fp16"
).to(device)
pipe = diffusers.StableDiffusionXLControlNetPipeline.from_pretrained(
    "SG161222/RealVisXL_V4.0", dtype=torch.float16, variant="fp16", controlnet=controlnet
).to(device)
pipe.scheduler = diffusers.DPMSolverMultistepScheduler.from_config(pipe.scheduler.config, use_karras_sigmas=True)

controlnet_out = pipe(
    prompt="high quality photo of a sports bike, city",
    negative_prompt="",
    guidance_scale=6.5,
    num_inference_steps=25,
    image=depth_image,
    controlnet_conditioning_scale=0.7,
    control_guidance_end=0.7,
    generator=generator,
).images
controlnet_out[0].save("motorcycle_controlnet_out.png")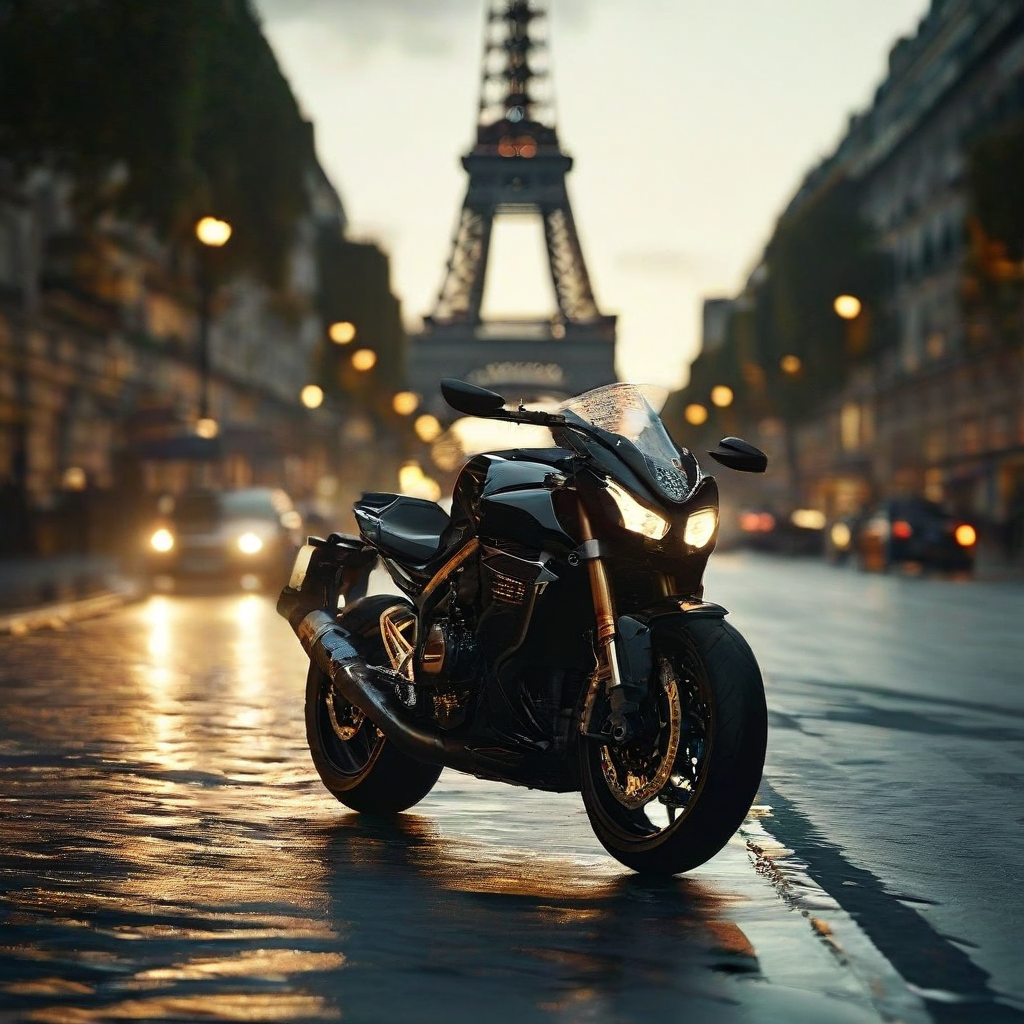


Evaluación cuantitativa
Para evaluar Marigold de forma cuantitativa en tablas de clasificación y conjuntos de datos estándar (como NYU, KITTI y otros),
siga el protocolo de evaluación descrito en el artículo: cargue el modelo de precisión completa fp32 y use los valores
adecuados para num_inference_steps y ensemble_size.
Opcionalmente, fije la semilla de aleatoriedad para garantizar la reproducibilidad.
Maximizar batch_size proporcionará la máxima utilización del dispositivo.
import diffusers
import torch

device = "cuda"  # or "mps", "xpu", "cpu"
seed = 2024

generator = torch.Generator(device=device).manual_seed(seed)
pipe = diffusers.MarigoldDepthPipeline.from_pretrained("prs-eth/marigold-depth-v1-1").to(device)

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
    image,
    num_inference_steps=4,  # set according to the evaluation protocol from the paper
    ensemble_size=10,       # set according to the evaluation protocol from the paper
    generator=generator,
)

# evaluate metrics
Uso de la incertidumbre predictiva
El mecanismo de ensembling integrado en las pipelines de Marigold combina múltiples predicciones obtenidas a partir de diferentes latentes aleatorios.
Como efecto secundario, puede utilizarse para cuantificar la incertidumbre epistémica (del modelo); basta con especificar ensemble_size mayor o igual que 3 y establecer output_uncertainty=True.
La incertidumbre resultante estará disponible en el campo uncertainty de la salida.
Puede visualizarse de la siguiente manera:
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
	image,
	ensemble_size=10,  # any number >= 3
	output_uncertainty=True,
)

uncertainty = pipe.image_processor.visualize_uncertainty(depth.uncertainty)
uncertainty[0].save("einstein_depth_uncertainty.png")


La interpretación de la incertidumbre es sencilla: los valores más altos (blanco) corresponden a píxeles donde el modelo tiene dificultades para hacer predicciones consistentes.
- El modelo de profundidad presenta la mayor incertidumbre en las discontinuidades, donde la profundidad de los objetos cambia de forma abrupta.
- El modelo de normales de superficie tiene menos confianza en estructuras de gran detalle, como el cabello, y en regiones oscuras, como el área del cuello.
- La incertidumbre del albedo se representa como una imagen RGB, ya que captura la incertidumbre de forma independiente para cada canal de color, a diferencia de la profundidad y las normales de superficie. También es mayor en las regiones sombreadas y en las discontinuidades.
API de predicción de profundidad de Marigold
clase diffusers.MarigoldDepthPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonescale_invariant: bool | None = Trueshift_invariant: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Parámetros
- unet (
UNet2DConditionModel) — U-Net condicional para desruidar el latente de profundidad, condicionado por el latente de imagen. - vae (
AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar y decodificar imágenes y predicciones hacia y desde representaciones latentes. - scheduler (
DDIMScheduleroLCMScheduler) — Un scheduler para usar en combinación conunetpara desruidar los latentes de la imagen codificada. - text_encoder (
CLIPTextModel) — Codificador de texto, para la incrustación de texto vacío. - tokenizer (
CLIPTokenizer) — Tokenizador de CLIP. - prediction_type (
str, opcional) — Tipo de predicciones realizadas por el modelo. - scale_invariant (
bool, opcional) — Una propiedad del modelo que especifica si los mapas de profundidad predichos son invariantes a la escala. Este valor debe establecerse en la configuración del modelo. Cuando se usa junto con la banderashift_invariant=True, el modelo también se denomina “afine-invariante”. NB: no se admite la sobrescritura de este valor. - shift_invariant (
bool, opcional) — Una propiedad del modelo que especifica si los mapas de profundidad predichos son invariantes al desplazamiento. Este valor debe establecerse en la configuración del modelo. Cuando se usa junto con la banderascale_invariant=True, el modelo también se denomina “invariante afín”. NB: no se admite la sobrescritura de este valor. - default_denoising_steps (
int, opcional) — El número mínimo de pasos de difusión de desruido necesarios para producir una predicción de calidad razonable con el modelo dado. Este valor debe establecerse en la configuración del modelo. Cuando se llama a la pipeline sin establecer explícitamentenum_inference_steps, se utiliza el valor predeterminado. Esto es necesario para garantizar resultados razonables con las distintas variantes de modelos compatibles con la pipeline, como aquellas que dependen de calendarios de desruido muy cortos (LCMScheduler) y aquellas con calendarios de difusión completos (DDIMScheduler). - default_processing_resolution (
int, opcional) — El valor recomendado del parámetroprocessing_resolutiondel pipeline. Este valor debe establecerse en la configuración del modelo. Cuando se llama al pipeline sin establecer explícitamenteprocessing_resolution, se utiliza el valor predeterminado. Esto es necesario para garantizar resultados razonables con las distintas variantes de modelos entrenadas con valores óptimos de resolución de procesamiento variables.
Pipeline para estimación de profundidad monocular usando el método Marigold: https://marigoldmonodepth.github.io.
Este modelo hereda de DiffusionPipeline. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos los pipelines (como la descarga o el guardado, la ejecución en un dispositivo específico, etc.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldDepthOutput or tuple
Parámetros
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]),list[torch.Tensor]: Una imagen o imágenes de entrada utilizadas como entrada para la tarea de estimación de profundidad. Para arrays y tensors, el rango de valores esperado está entre[0, 1]. Es posible pasar un lote de imágenes proporcionando un array o tensor de cuatro dimensiones. Además, se puede pasar una lista de imágenes de arrays o tensors de dos o tres dimensiones. En este último caso, todos los elementos de la lista deben tener el mismo ancho y alto. - num_inference_steps (
int, opcional, valor predeterminadoNone) — Número de pasos de difusión de desruido durante la inferencia. El valor predeterminadoNoneresulta en una selección automática. - ensemble_size (
int, por defecto1) — Número de predicciones de ensemble. Valores más altos resultan en mejoras medibles y degradación visual. - processing_resolution (
int, opcional, valor predeterminadoNone) — Resolución de procesamiento efectiva. Cuando se establece en0, coincide con la dimensión mayor de la imagen de entrada. Esto produce predicciones más nítidas, pero también puede provocar la pérdida del contexto global. El valor predeterminadoNonese resuelve al valor óptimo de la configuración del modelo. - match_input_resolution (
bool, opcional, valor predeterminadoTrue) — Cuando está habilitado, la predicción de salida se redimensiona para que coincida con las dimensiones de entrada. Cuando está deshabilitado, el lado más largo de la salida será igual aprocessing_resolution. - resample_method_input (
str, opcional, por defecto"bilinear") — Método de remuestreo utilizado para redimensionar las imágenes de entrada aprocessing_resolution. Los valores aceptados son:"nearest","nearest-exact","bilinear","bicubic"o"area". - resample_method_output (
str, opcional, valor predeterminado"bilinear") — Método de remuestreo utilizado para redimensionar las predicciones de salida para que coincidan con la resolución de entrada. Los valores aceptados son"nearest","nearest-exact","bilinear","bicubic"o"area". - batch_size (
int, opcional, valor predeterminado1) — Tamaño del lote; solo es relevante al establecerensemble_sizeo al pasar un tensor de imágenes. - ensembling_kwargs (
dict, opcional, por defectoNone) — Diccionario adicional con argumentos para un control preciso del ensembling. Las siguientes opciones están disponibles:- reducción (
str, opcional, por defecto"median"): Define la función de ensembling aplicada en cada ubicación de píxel, puede ser"median"o"mean". - regularizer_strength (
float, opcional, valor predeterminado0.02): Fuerza del regularizador que arrastra las predicciones alineadas al rango unitario de 0 a 1. - max_iter (
int, opcional, valor predeterminado2): Número máximo de pasos del solver de alineación. Consulte la funciónscipy.optimize.minimize, argumentooptions. - tol (
float, opcional, valor predeterminado1e-3): Tolerancia del solver de alineación. El solver se detiene cuando se alcanza la tolerancia. - max_res (
int, opcional, valor predeterminadoNone): Resolución en la que se realiza la alineación;Nonecoincide conprocessing_resolution.
- reducción (
- latents (
torch.Tensorolist[torch.Tensor], opcional, valor predeterminadoNone) — Tensores de ruido latente para reemplazar la inicialización aleatoria. Estos pueden obtenerse de la salida de la llamada anterior a la función. - generator (
torch.Generator, olist[torch.Generator], opcional, valor predeterminadoNone) — Objeto generador de números aleatorios para garantizar la reproducibilidad. - output_type (
str, opcional, valor predeterminado"np") — Formato preferido de los campospredictionyuncertaintyopcionales de la salida. Los valores aceptados son:"np"(array de numpy) o"pt"(tensor de torch). - output_uncertainty (
bool, opcional, valor predeterminadoFalse) — Cuando está habilitado, el campouncertaintyde la salida contiene el mapa de incertidumbre predictiva, siempre que el argumentoensemble_sizese establezca en un valor superior a 2. - output_latent (
bool, opcional, valor predeterminadoFalse) — Cuando está habilitado, el campolatentde la salida contiene los códigos latentes correspondientes a las predicciones dentro del ensemble. Estos códigos se pueden guardar, modificar y usar en llamadas posteriores con el argumentolatents. - return_dict (
bool, opcional, valor predeterminadoTrue) — Indica si se debe devolver un MarigoldDepthOutput en lugar de una tupla simple.
Devuelve
MarigoldDepthOutput o tuple
Si return_dict es True, se devuelve MarigoldDepthOutput; en caso contrario, se devuelve una
tuple cuyo primer elemento es la predicción, el segundo es la incertidumbre
(o None) y el tercero es el latente (o None).
Función invocada al llamar al pipeline.
Ejemplos:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
...     "prs-eth/marigold-depth-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> depth = pipe(image)

>>> vis = pipe.image_processor.visualize_depth(depth.prediction)
>>> vis[0].save("einstein_depth.png")

>>> depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
>>> depth_16bit[0].save("einstein_depth_16bit.png")
clase diffusers.pipelines.marigold.MarigoldDepthOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Parámetros
- prediction (
np.ndarray,torch.Tensor) — Mapas de profundidad predichos con valores en el rango [0, 1]. La forma esnumimages × 1 × height × widthparatorch.Tensoronumimages × height × width × 1paranp.ndarray. - uncertainty (
None,np.ndarray,torch.Tensor) — Mapas de incertidumbre calculados a partir del ensemble, con valores en el rango [0, 1]. La forma esnumimages × 1 × height × widthparatorch.Tensoronumimages × height × width × 1paranp.ndarray. - latent (
None,torch.Tensor) — Latent features corresponding to the predictions, compatible with thelatentsargument of the pipeline. The shape isnumimages * numensemble × 4 × latentheight × latentwidth.
Clase de salida para el pipeline de predicción de profundidad monocular de Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_depth
< source >( depth: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]val_min: float = 0.0val_max: float = 1.0color_map: str = 'Spectral' )
Parámetros
- depth (
PIL.Image.Image | np.ndarray | torch.Tensor | list[PIL.Image.Image, list[np.ndarray], -- list[torch.Tensor]]): Mapas de profundidad. - val_min (
float, opcional, valor predeterminado0.0) — Valor mínimo del rango de profundidad visualizado. - val_max (
float, opcional, valor predeterminado1.0) — Valor máximo del rango de profundidad visualizado. - color_map (
str, opcional, valor predeterminado"Spectral") — Mapa de colores utilizado para convertir una predicción de profundidad de un solo canal en una representación con color.
Visualiza mapas de profundidad, como las predicciones de MarigoldDepthPipeline.
Devuelve: list[PIL.Image.Image] con la visualización de los mapas de profundidad.
API de estimación de normales de Marigold
clase diffusers.MarigoldNormalsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Noneuse_full_z_range: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Parámetros
- unet (
UNet2DConditionModel) — U-Net condicional para desruidar el latente de normales, condicionado por el latente de imagen. - vae (
AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar y decodificar imágenes y predicciones hacia y desde representaciones latentes. - scheduler (
DDIMScheduleroLCMScheduler) — Un scheduler para usar en combinación conunetpara desruidar los latentes de la imagen codificada. - text_encoder (
CLIPTextModel) — Codificador de texto, para la incrustación de texto vacío. - tokenizer (
CLIPTokenizer) — Tokenizador de CLIP. - prediction_type (
str, opcional) — Tipo de predicciones realizadas por el modelo. - use_full_z_range (
bool, opcional) — Si las normales predichas por este modelo utilizan el rango completo de la dimensión Z, o solo su mitad positiva. - default_denoising_steps (
int, opcional) — El número mínimo de pasos de difusión de desruido necesarios para producir una predicción de calidad razonable con el modelo dado. Este valor debe establecerse en la configuración del modelo. Cuando se llama a la pipeline sin establecer explícitamentenum_inference_steps, se utiliza el valor predeterminado. Esto es necesario para garantizar resultados razonables con las distintas variantes de modelos compatibles con la pipeline, como aquellas que dependen de calendarios de desruido muy cortos (LCMScheduler) y aquellas con calendarios de difusión completos (DDIMScheduler). - default_processing_resolution (
int, opcional) — El valor recomendado del parámetroprocessing_resolutiondel pipeline. Este valor debe establecerse en la configuración del modelo. Cuando se llama al pipeline sin establecer explícitamenteprocessing_resolution, se utiliza el valor predeterminado. Esto es necesario para garantizar resultados razonables con las distintas variantes de modelos entrenadas con valores óptimos de resolución de procesamiento variables.
Pipeline para la estimación de normales monoculares usando el método Marigold: https://marigoldmonodepth.github.io.
Este modelo hereda de DiffusionPipeline. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos los pipelines (como la descarga o el guardado, la ejecución en un dispositivo específico, etc.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldNormalsOutput or tuple
Parámetros
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]),list[torch.Tensor]: Una imagen o imágenes de entrada utilizadas como entrada para la tarea de estimación de normales. Para arrays y tensores, el rango de valores esperado está entre[0, 1]. Es posible pasar un lote de imágenes proporcionando un array o tensor de cuatro dimensiones. Además, se puede pasar una lista de imágenes de arrays o tensores de dos o tres dimensiones. En este último caso, todos los elementos de la lista deben tener el mismo ancho y alto. - num_inference_steps (
int, opcional, valor predeterminadoNone) — Número de pasos de difusión de desruido durante la inferencia. El valor predeterminadoNoneresulta en una selección automática. - ensemble_size (
int, por defecto1) — Número de predicciones de ensemble. Valores más altos resultan en mejoras medibles y degradación visual. - processing_resolution (
int, opcional, valor predeterminadoNone) — Resolución de procesamiento efectiva. Cuando se establece en0, coincide con la dimensión mayor de la imagen de entrada. Esto produce predicciones más nítidas, pero también puede provocar la pérdida del contexto global. El valor predeterminadoNonese resuelve al valor óptimo de la configuración del modelo. - match_input_resolution (
bool, opcional, valor predeterminadoTrue) — Cuando está habilitado, la predicción de salida se redimensiona para que coincida con las dimensiones de entrada. Cuando está deshabilitado, el lado más largo de la salida será igual aprocessing_resolution. - resample_method_input (
str, opcional, por defecto"bilinear") — Método de remuestreo utilizado para redimensionar las imágenes de entrada aprocessing_resolution. Los valores aceptados son:"nearest","nearest-exact","bilinear","bicubic"o"area". - resample_method_output (
str, opcional, valor predeterminado"bilinear") — Método de remuestreo utilizado para redimensionar las predicciones de salida para que coincidan con la resolución de entrada. Los valores aceptados son"nearest","nearest-exact","bilinear","bicubic"o"area". - batch_size (
int, opcional, valor predeterminado1) — Tamaño del lote; solo es relevante al establecerensemble_sizeo al pasar un tensor de imágenes. - ensembling_kwargs (
dict, opcional, el valor predeterminado esNone) — Diccionario adicional con argumentos para un control preciso del ensembling. Las siguientes opciones están disponibles:- reducción (
str, opcional, por defecto"closest"): Define la función de ensembling aplicada en cada ubicación de píxel, puede ser"closest"o"mean".
- reducción (
- latents (
torch.Tensor, opcional, valor predeterminadoNone) — Tensores de ruido latente para reemplazar la inicialización aleatoria. Estos pueden obtenerse de la salida de la llamada anterior a la función. - generator (
torch.Generator, olist[torch.Generator], opcional, valor predeterminadoNone) — Objeto generador de números aleatorios para garantizar la reproducibilidad. - output_type (
str, opcional, valor predeterminado"np") — Formato preferido de los campospredictionyuncertaintyopcionales de la salida. Los valores aceptados son:"np"(array de numpy) o"pt"(tensor de torch). - output_uncertainty (
bool, opcional, valor predeterminadoFalse) — Cuando está habilitado, el campouncertaintyde la salida contiene el mapa de incertidumbre predictiva, siempre que el argumentoensemble_sizese establezca en un valor superior a 2. - output_latent (
bool, opcional, valor predeterminadoFalse) — Cuando está habilitado, el campolatentde la salida contiene los códigos latentes correspondientes a las predicciones dentro del ensemble. Estos códigos se pueden guardar, modificar y usar en llamadas posteriores con el argumentolatents. - return_dict (
bool, opcional, valor predeterminadoTrue) — Indica si se debe devolver un MarigoldNormalsOutput en lugar de una tupla simple.
Devuelve
MarigoldNormalsOutput o tuple
Si return_dict es True, se devuelve MarigoldNormalsOutput; en caso contrario, se devuelve una
tuple cuyo primer elemento es la predicción, el segundo es la incertidumbre
(o None) y el tercero es el latente (o None).
Función invocada al llamar al pipeline.
Ejemplos:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
...     "prs-eth/marigold-normals-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> normals = pipe(image)

>>> vis = pipe.image_processor.visualize_normals(normals.prediction)
>>> vis[0].save("einstein_normals.png")
clase diffusers.pipelines.marigold.MarigoldNormalsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Parámetros
- prediction (
np.ndarray,torch.Tensor) — Normales predichas con valores en el rango [-1, 1]. La forma esnumimages × 3 × height × widthparatorch.Tensoronumimages × height × width × 3paranp.ndarray. - uncertainty (
None,np.ndarray,torch.Tensor) — Mapas de incertidumbre calculados a partir del ensemble, con valores en el rango [0, 1]. La forma esnumimages × 1 × height × widthparatorch.Tensoronumimages × height × width × 1paranp.ndarray. - latent (
None,torch.Tensor) — Latent features corresponding to the predictions, compatible with thelatentsargument of the pipeline. The shape isnumimages * numensemble × 4 × latentheight × latentwidth.
Clase de salida para el pipeline de predicción de normales monoculares de Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_normals
< source >( normals: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]flip_x: bool = Falseflip_y: bool = Falseflip_z: bool = False )
Parámetros
- normals (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — Normales de la superficie. - flip_x (
bool, opcional, valor predeterminadoFalse) — Invierte el eje X del sistema de referencia de las normales. La dirección predeterminada es a la derecha. - flip_y (
bool, opcional, valor predeterminadoFalse) — Invierte el eje Y del sistema de referencia de las normales. La dirección predeterminada es hacia arriba. - flip_z (
bool, opcional, valor predeterminadoFalse) — Invierte el eje Z del sistema de referencia de las normales. La dirección predeterminada es hacia el observador.
Visualiza normales de superficie, como las predicciones de MarigoldNormalsPipeline.
Devuelve: list[PIL.Image.Image] con la visualización de normales de superficie.
API de descomposición de imagen intrínseca de Marigold
clase diffusers.MarigoldIntrinsicsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonetarget_properties: dict[str, typing.Any] | None = Nonedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Parámetros
- unet (
UNet2DConditionModel) — U-Net condicional para desruidar el latente de los objetivos, condicionado por el latente de la imagen. - vae (
AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar y decodificar imágenes y predicciones hacia y desde representaciones latentes. - scheduler (
DDIMScheduleroLCMScheduler) — Un scheduler para usar en combinación conunetpara desruidar los latentes de la imagen codificada. - text_encoder (
CLIPTextModel) — Codificador de texto, para la incrustación de texto vacío. - tokenizer (
CLIPTokenizer) — Tokenizador de CLIP. - prediction_type (
str, opcional) — Tipo de predicciones realizadas por el modelo. - target_properties (
dict[str, Any], opcional) — Propiedades de las modalidades predichas, comotarget_names, unalist[str]utilizada para definir el número, el orden y los nombres de las modalidades predichas, y cualquier otro metadato que pueda ser necesario para interpretar las predicciones. - default_denoising_steps (
int, opcional) — El número mínimo de pasos de difusión de desruido necesarios para producir una predicción de calidad razonable con el modelo dado. Este valor debe establecerse en la configuración del modelo. Cuando se llama a la pipeline sin establecer explícitamentenum_inference_steps, se utiliza el valor predeterminado. Esto es necesario para garantizar resultados razonables con las distintas variantes de modelos compatibles con la pipeline, como aquellas que dependen de calendarios de desruido muy cortos (LCMScheduler) y aquellas con calendarios de difusión completos (DDIMScheduler). - default_processing_resolution (
int, opcional) — El valor recomendado del parámetroprocessing_resolutiondel pipeline. Este valor debe establecerse en la configuración del modelo. Cuando se llama al pipeline sin establecer explícitamenteprocessing_resolution, se utiliza el valor predeterminado. Esto es necesario para garantizar resultados razonables con las distintas variantes de modelos entrenadas con valores óptimos de resolución de procesamiento variables.
Pipeline para la Descomposición de Imágenes Intrínsecas (IID) usando el método Marigold: https://marigoldcomputervision.github.io.
Este modelo hereda de DiffusionPipeline. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos los pipelines (como la descarga o el guardado, la ejecución en un dispositivo específico, etc.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldIntrinsicsOutput or tuple
Parámetros
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]),list[torch.Tensor]: Una imagen o imágenes de entrada utilizadas como entrada para la tarea de descomposición intrínseca. Para matrices y tensores, el rango de valores esperado está entre[0, 1]. Es posible pasar un lote de imágenes proporcionando una matriz o un tensor de cuatro dimensiones. Además, se puede pasar una lista de imágenes de matrices o tensores de dos o tres dimensiones. En este último caso, todos los elementos de la lista deben tener el mismo ancho y alto. - num_inference_steps (
int, opcional, valor predeterminadoNone) — Número de pasos de difusión de desruido durante la inferencia. El valor predeterminadoNoneresulta en una selección automática. - ensemble_size (
int, por defecto1) — Número de predicciones de ensemble. Valores más altos resultan en mejoras medibles y degradación visual. - processing_resolution (
int, opcional, valor predeterminadoNone) — Resolución de procesamiento efectiva. Cuando se establece en0, coincide con la dimensión mayor de la imagen de entrada. Esto produce predicciones más nítidas, pero también puede provocar la pérdida del contexto global. El valor predeterminadoNonese resuelve al valor óptimo de la configuración del modelo. - match_input_resolution (
bool, opcional, valor predeterminadoTrue) — Cuando está habilitado, la predicción de salida se redimensiona para que coincida con las dimensiones de entrada. Cuando está deshabilitado, el lado más largo de la salida será igual aprocessing_resolution. - resample_method_input (
str, opcional, por defecto"bilinear") — Método de remuestreo utilizado para redimensionar las imágenes de entrada aprocessing_resolution. Los valores aceptados son:"nearest","nearest-exact","bilinear","bicubic"o"area". - resample_method_output (
str, opcional, valor predeterminado"bilinear") — Método de remuestreo utilizado para redimensionar las predicciones de salida para que coincidan con la resolución de entrada. Los valores aceptados son"nearest","nearest-exact","bilinear","bicubic"o"area". - batch_size (
int, opcional, valor predeterminado1) — Tamaño del lote; solo es relevante al establecerensemble_sizeo al pasar un tensor de imágenes. - ensembling_kwargs (
dict, opcional, el valor predeterminado esNone) — Diccionario adicional con argumentos para un control preciso del ensembling. Las siguientes opciones están disponibles:- reducción (
str, opcional, por defecto"median"): Define la función de ensembling aplicada en cada ubicación de píxel, puede ser"median"o"mean".
- reducción (
- latents (
torch.Tensor, opcional, valor predeterminadoNone) — Tensores de ruido latente para reemplazar la inicialización aleatoria. Estos pueden obtenerse de la salida de la llamada anterior a la función. - generator (
torch.Generator, olist[torch.Generator], opcional, valor predeterminadoNone) — Objeto generador de números aleatorios para garantizar la reproducibilidad. - output_type (
str, opcional, valor predeterminado"np") — Formato preferido de los campospredictionyuncertaintyopcionales de la salida. Los valores aceptados son:"np"(array de numpy) o"pt"(tensor de torch). - output_uncertainty (
bool, opcional, valor predeterminadoFalse) — Cuando está habilitado, el campouncertaintyde la salida contiene el mapa de incertidumbre predictiva, siempre que el argumentoensemble_sizese establezca en un valor superior a 2. - output_latent (
bool, opcional, valor predeterminadoFalse) — Cuando está habilitado, el campolatentde la salida contiene los códigos latentes correspondientes a las predicciones dentro del ensemble. Estos códigos se pueden guardar, modificar y usar en llamadas posteriores con el argumentolatents. - return_dict (
bool, opcional, valor predeterminadoTrue) — Indica si se debe devolver un MarigoldIntrinsicsOutput en lugar de una tupla simple.
Devuelve
MarigoldIntrinsicsOutput o tuple
Si return_dict es True, se devuelve MarigoldIntrinsicsOutput; en caso contrario, se devuelve una
tuple cuyo primer elemento es la predicción, el segundo es la incertidumbre
(o None) y el tercero es el latente (o None).
Función invocada al llamar al pipeline.
Ejemplos:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
...     "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)

>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["roughness"].save("einstein_roughness.png")
>>> vis[0]["metallicity"].save("einstein_metallicity.png")>>> import diffusers
>>> import torch
>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
... "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")
>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)
>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["shading"].save("einstein_shading.png")
>>> vis[0]["residual"].save("einstein_residual.png")clase diffusers.pipelines.marigold.MarigoldIntrinsicsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Parámetros
- prediction (
np.ndarray,torch.Tensor) — Intrínsecos de imagen predichos con valores en el rango [0, 1]. La forma es(numimages * numtargets) × 3 × height × widthparatorch.Tensoro(numimages * numtargets) × height × width × 3paranp.ndarray, dondenumtargetscorresponde al número de modalidades objetivo predichas de la descomposición de la imagen intrínseca. - uncertainty (
None,np.ndarray,torch.Tensor) — Mapas de incertidumbre calculados a partir del ensemble, con valores en el rango [0, 1]. La forma es(numimages * numtargets) × 3 × height × widthparatorch.Tensoro(numimages * numtargets) × height × width × 3paranp.ndarray. - latent (
None,torch.Tensor) — Latent features corresponding to the predictions, compatible with thelatentsargument of the pipeline. The shape is(numimages * numensemble) × (numtargets * 4) × latentheight × latentwidth.
Clase de salida para el pipeline de Marigold Intrinsic Image Decomposition.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_intrinsics
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]target_properties: dictcolor_map: str | dict[str, str] = 'binary' )
Parámetros
- prediction (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — Descomposición de imagen intrínseca. - target_properties (
dict[str, Any]) — Propiedades de descomposición. Entradas esperadas:target_names: list[str]y un diccionario con las clavesprediction_space: str,sub_target_names: list[str | Null](debe tener 3 entradas, null para las modalidades ausentes),up_to_scale: bool, una para cada objetivo y subobjetivo. - color_map (
str | dict[str, str], opcional, valor predeterminado"Spectral") — Mapa de colores utilizado para convertir predicciones de un solo canal en representaciones con color. Cuando se pasa un diccionario, cada modalidad puede colorearse con su propio mapa de colores.
Visualiza la descomposición de imágenes intrínsecas, como las predicciones de MarigoldIntrinsicsPipeline.
Devuelve: list[dict[str, PIL.Image.Image]] con la visualización de la descomposición de la imagen intrínseca.