Diffusers documentation
IP-Adapter
IP-Adapter
يوجّه IP-Adapter نموذج انتشار مُدرَّب مسبقًا باستخدام صورة مرجعية مع الحفاظ على موجه نصي. يقوم بتجميد النموذج الأساسي وإضافة مجموعة صغيرة من طبقات الانتباه المتقاطع للصورة، مما يجعله عمليًا لمطابقة موضوع أو أسلوب من صورة دون الحاجة إلى ضبط دقيق.
text prompt                         reference image
    |                                     |
 text encoder                        image encoder
    |                                     |
    v                                     v
 text cross-attn  (frozen)          IP-Adapter cross-attn
    \                                     /
     \                                   /
      +-------->  denoiser  <-----------+
                  (frozen base)
عادةً ما تكون نقاط التفتيش الخاصة بـ IP-Adapter بحجم ~100MB لأنها تخزن أوزان المُكيّف (adapter) وليس نموذجًا كاملًا. قم بتحميل خط أنابيب أساسي (base pipeline) أولاً، ثم حمّل المُكيّف باستخدام load_ip_adapter().
تتوفر محولات IP-Adapters للعديد من النماذج مثل Flux وStable Diffusion 3 وغيرها. تستخدم الأمثلة في هذا الدليل Stable Diffusion وStable Diffusion XL.
استخدم set_ip_adapter_scale() للتحكم في مدى قوة توجيه IP-Adapter لعملية التوليد. يُطبَّق المُكيّف بقوة كاملة عند 1.0؛ بينما يُوازن 0.5 عادةً بين موجهات النص والصورة.
تُظهر الأمثلة أدناه نموذج IP-Adapter في مهام شائعة.
import torch
from diffusers import AutoPipelineForText2Image
from diffusers.utils import load_image

pipeline = AutoPipelineForText2Image.from_pretrained(
  "stabilityai/stable-diffusion-xl-base-1.0",
  dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name="ip-adapter_sdxl.bin"
)
pipeline.set_ip_adapter_scale(0.8)
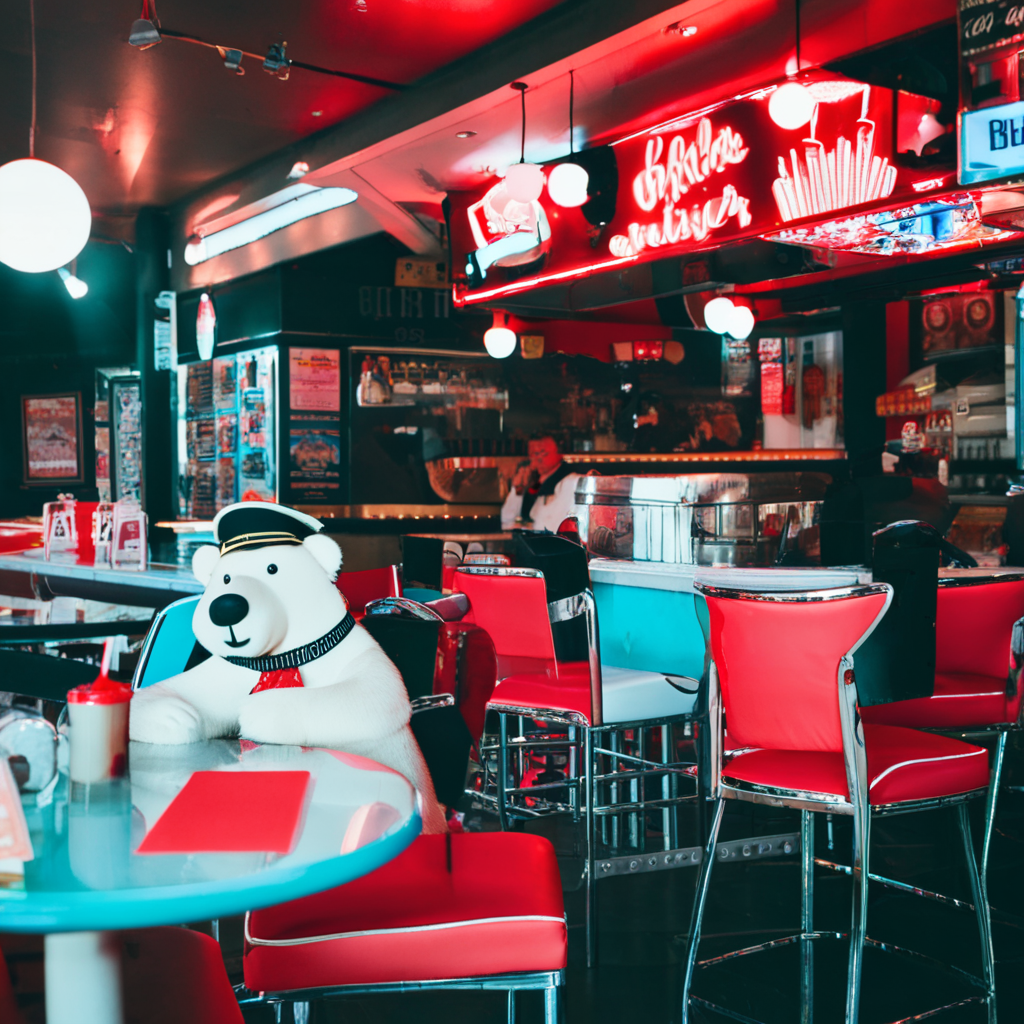
مرّر صورة إلى ip_adapter_image مع وصف نصي لتوليد صورة.
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_diner.png")
pipeline(
    prompt="a polar bear sitting in a chair drinking a milkshake",
    ip_adapter_image=image,
    negative_prompt="deformed, ugly, wrong proportion, low res, bad anatomy, worst quality, low quality",
).images[0]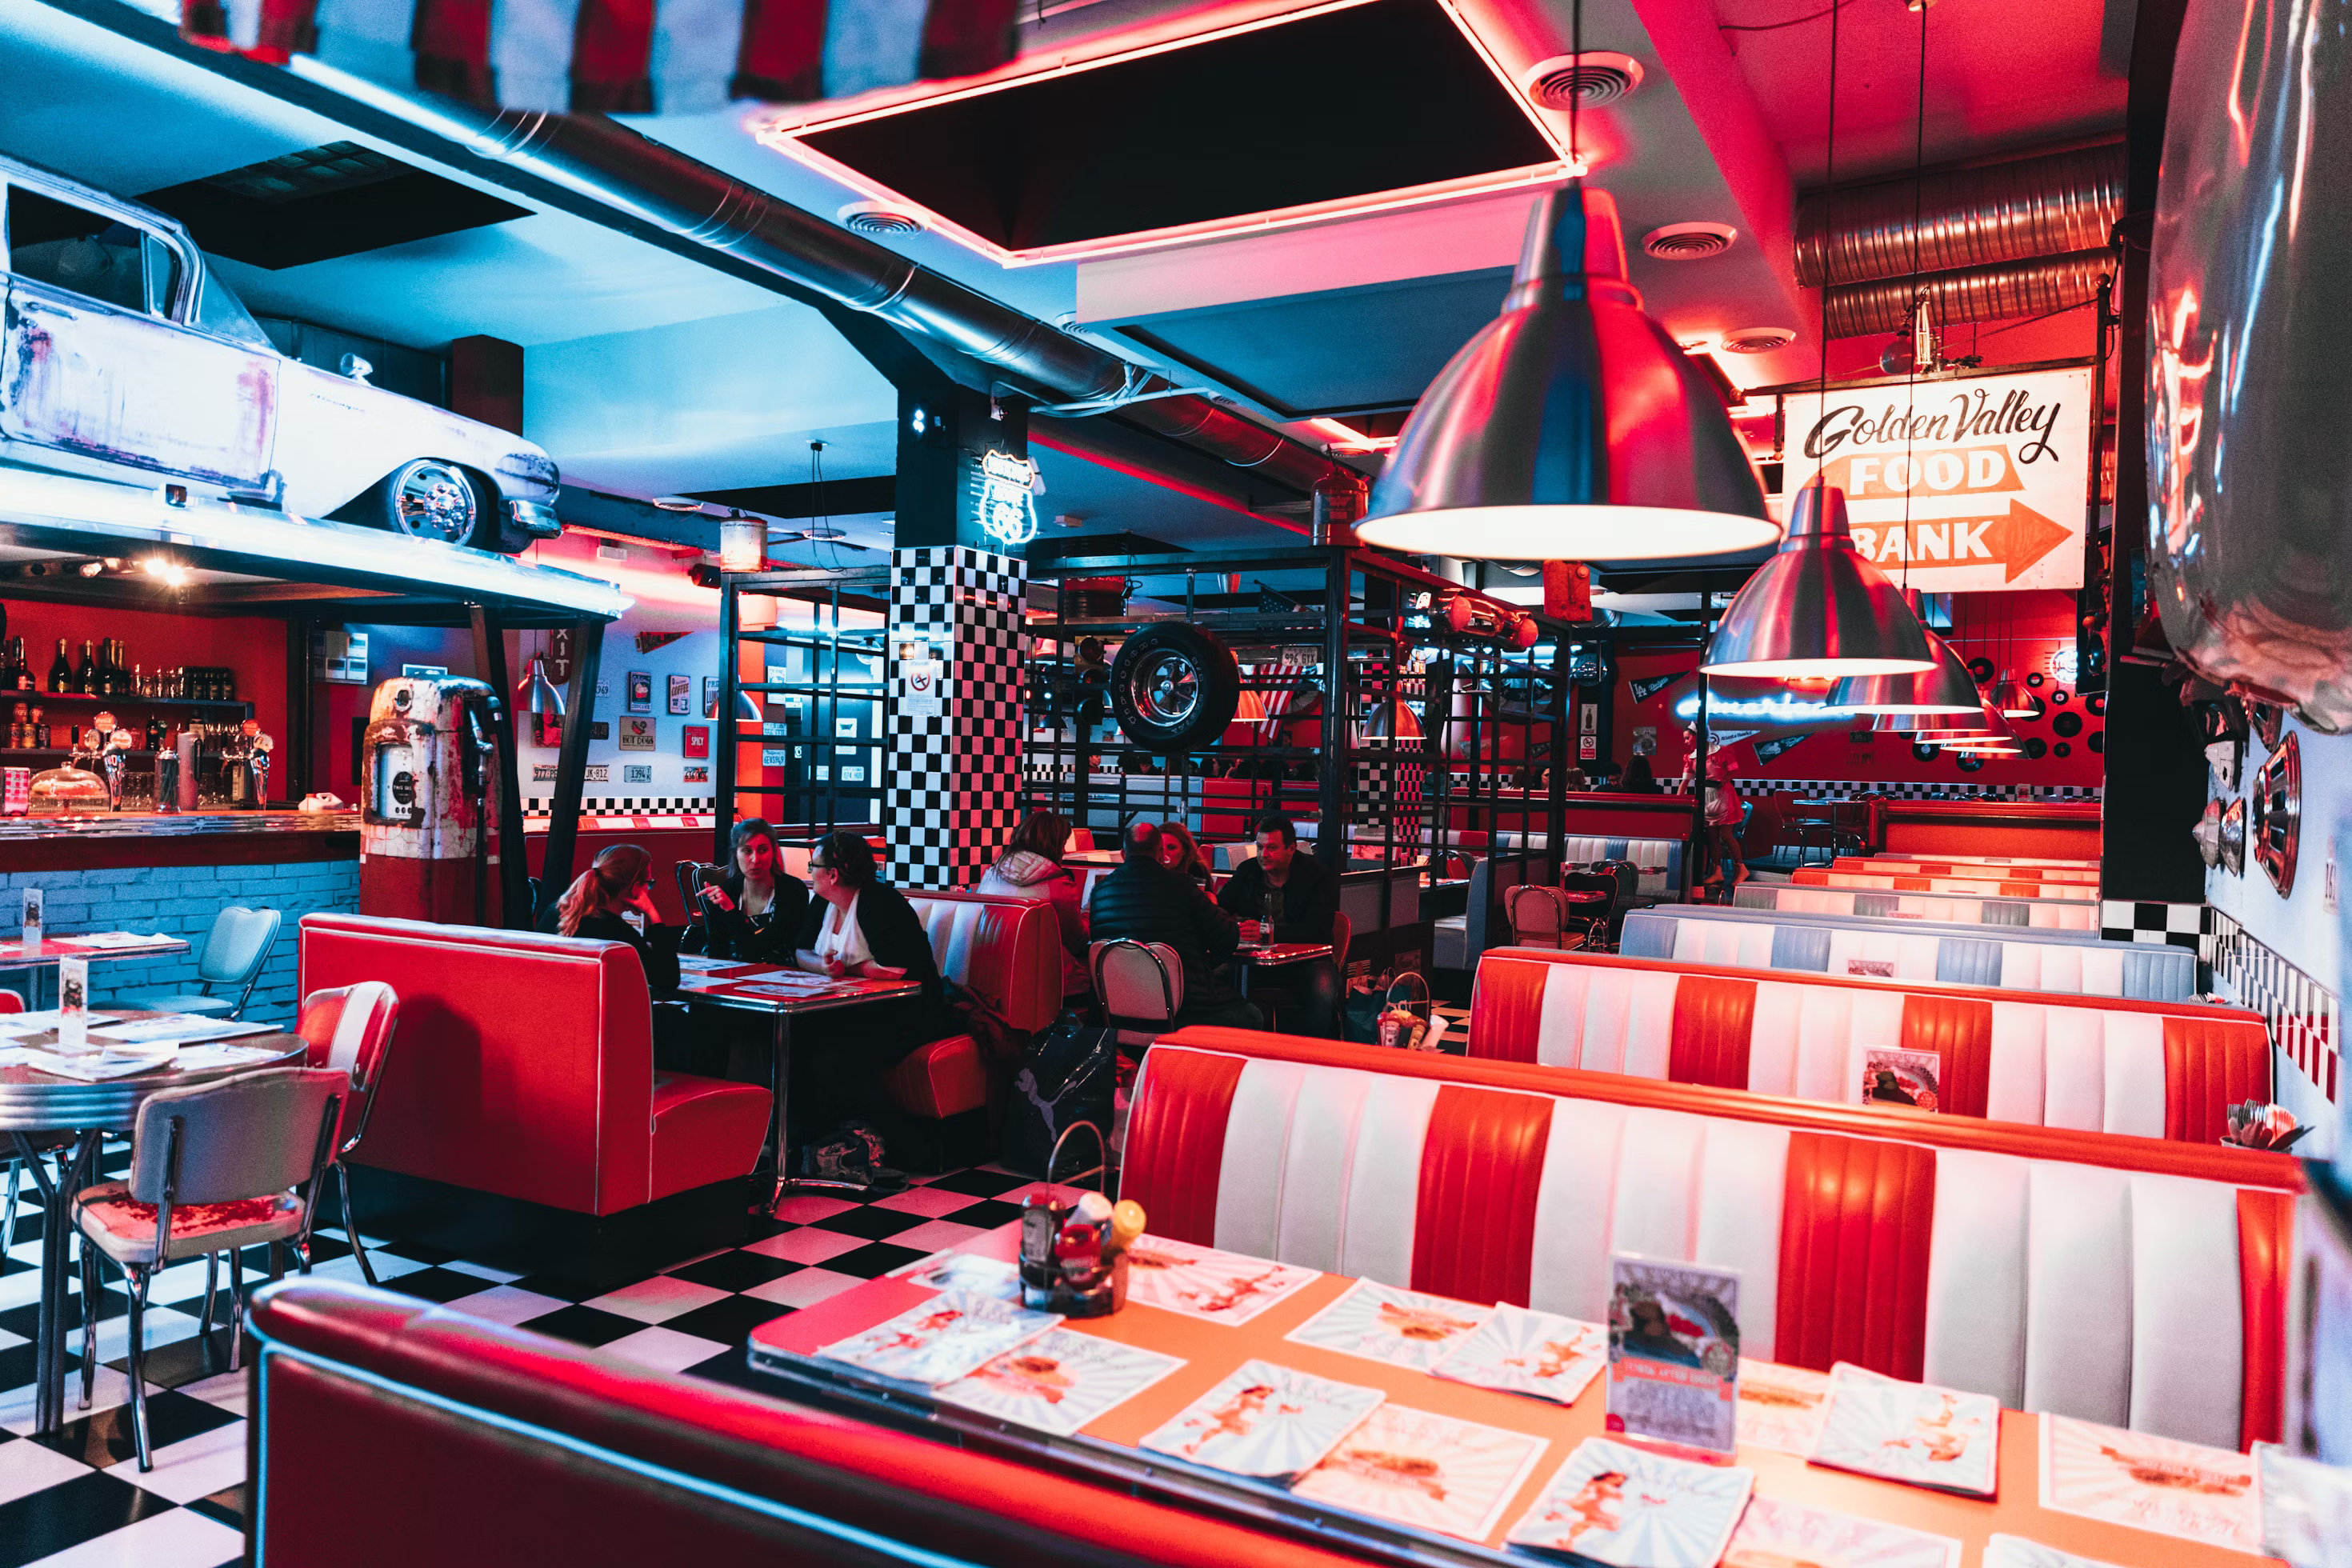
import torch
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import load_image

pipeline = AutoPipelineForImage2Image.from_pretrained(
  "stabilityai/stable-diffusion-xl-base-1.0",
  dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name="ip-adapter_sdxl.bin"
)
pipeline.set_ip_adapter_scale(0.8)

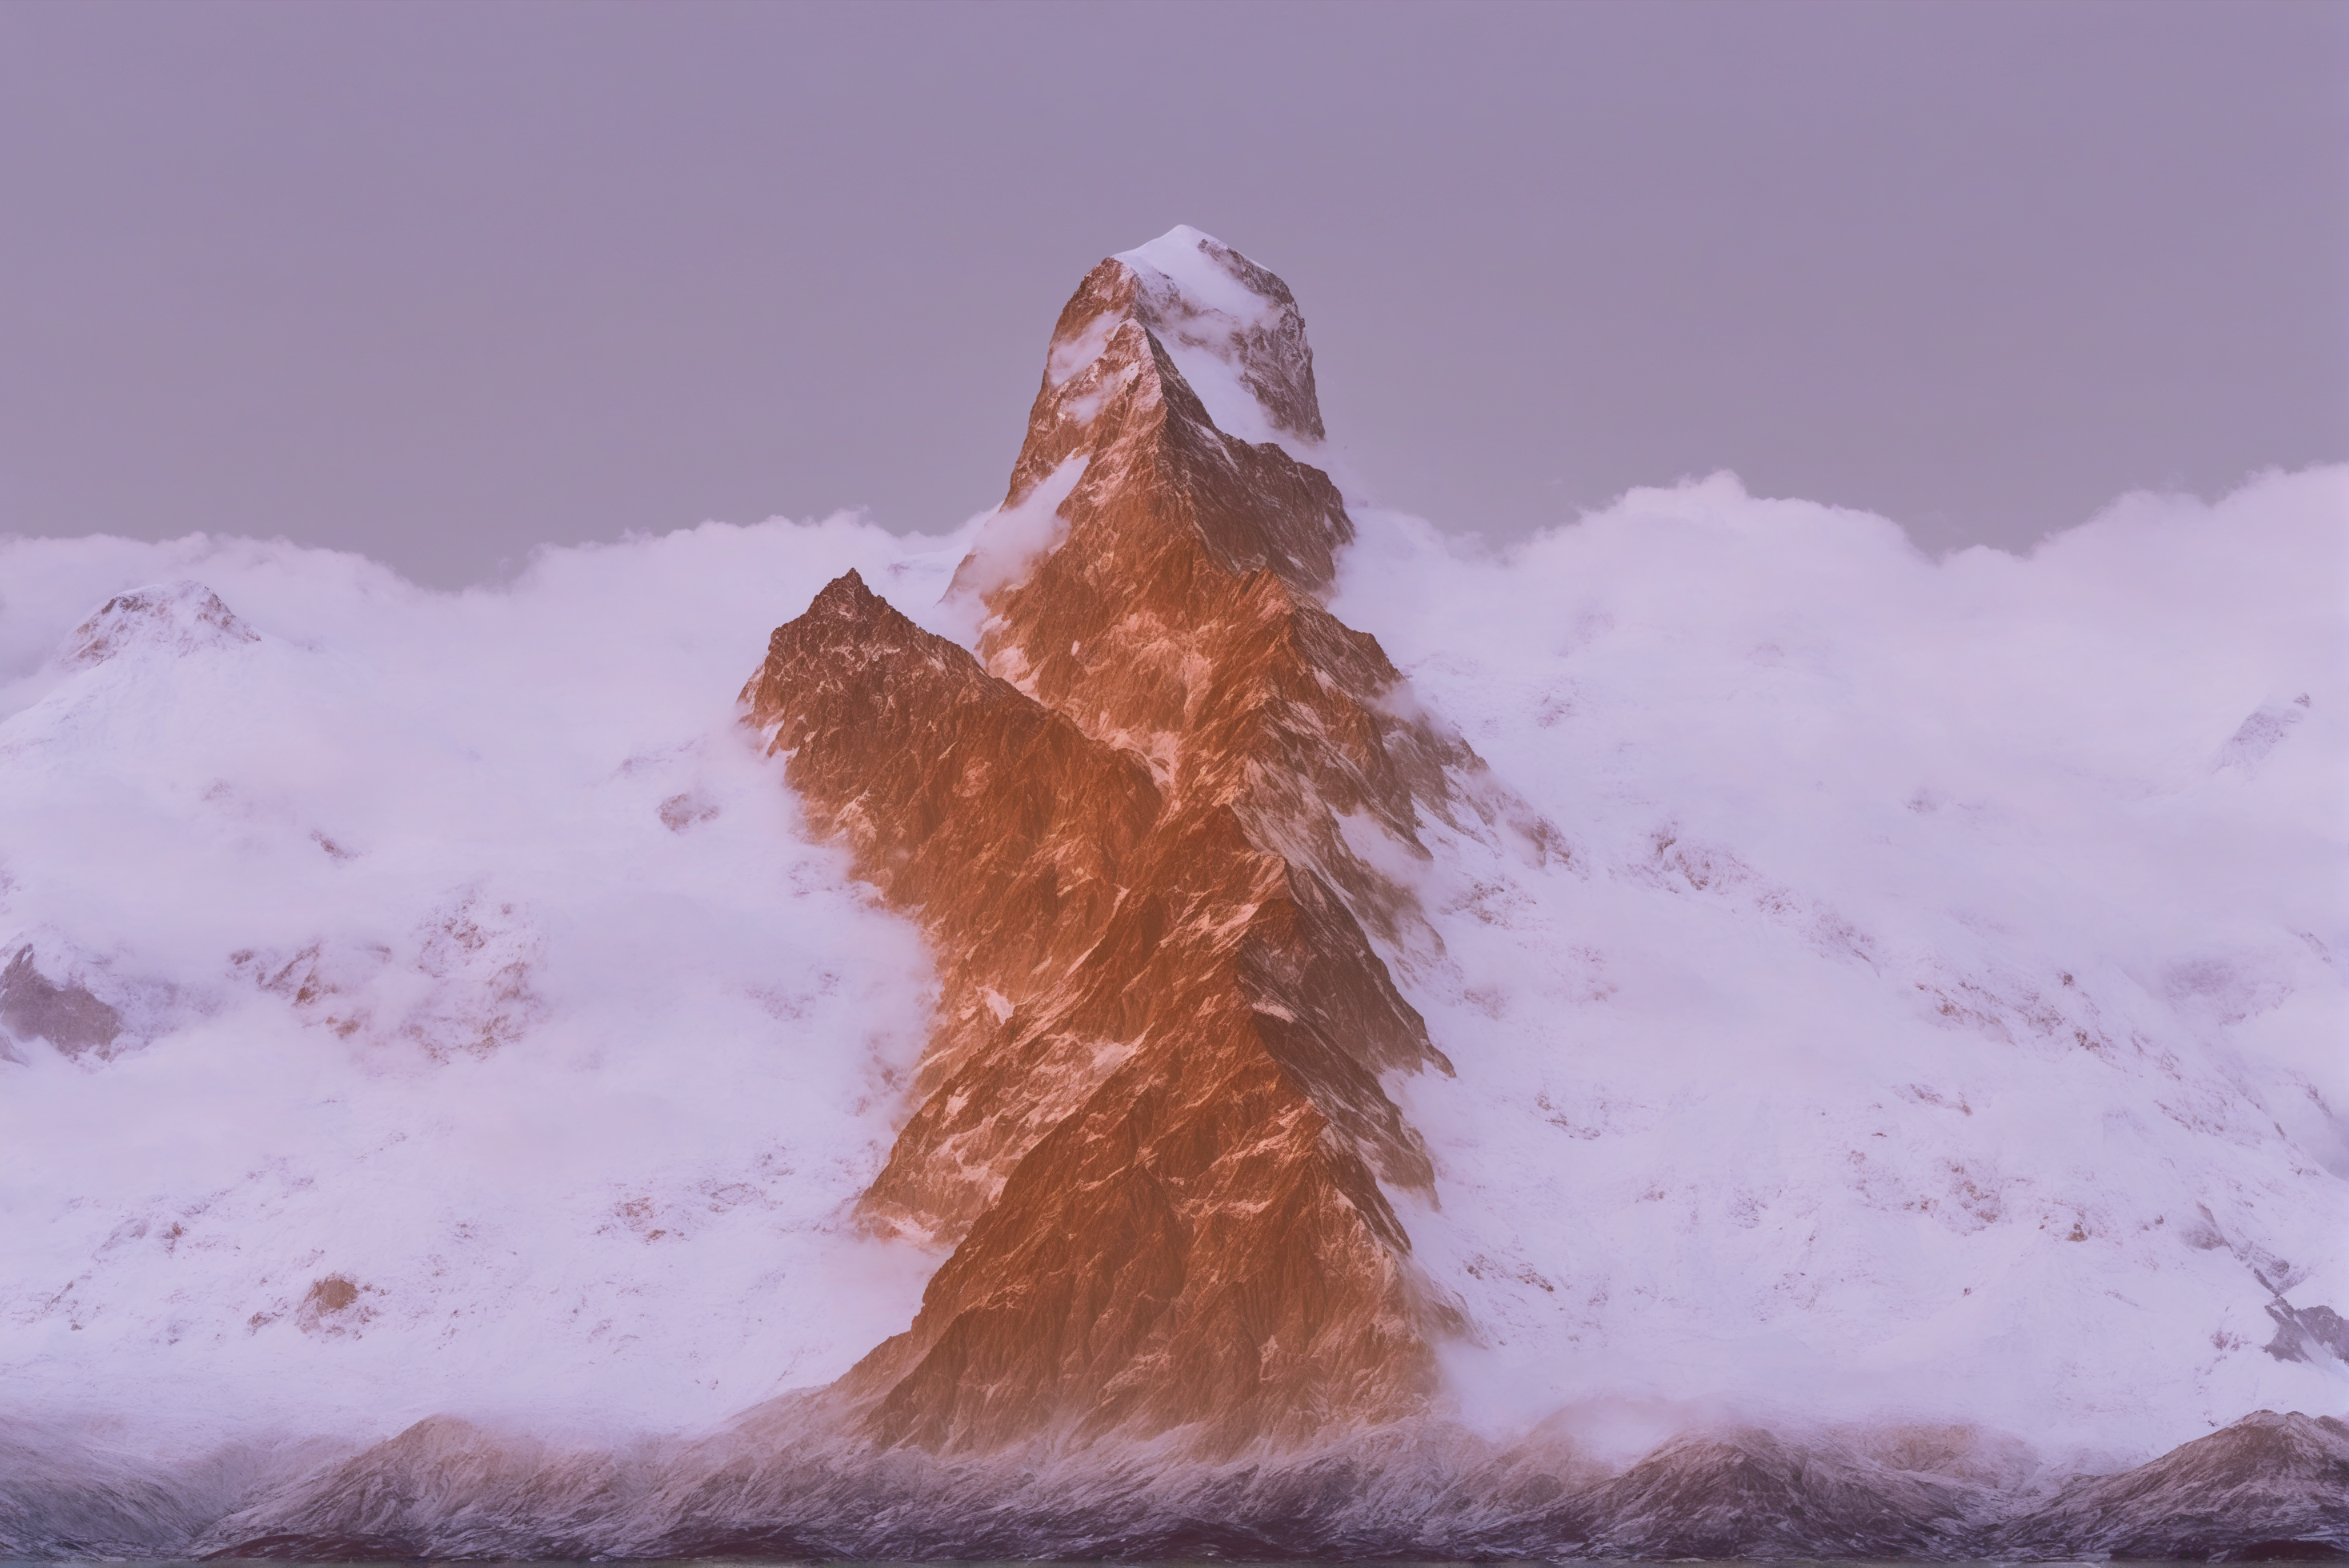
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_bear_1.png")
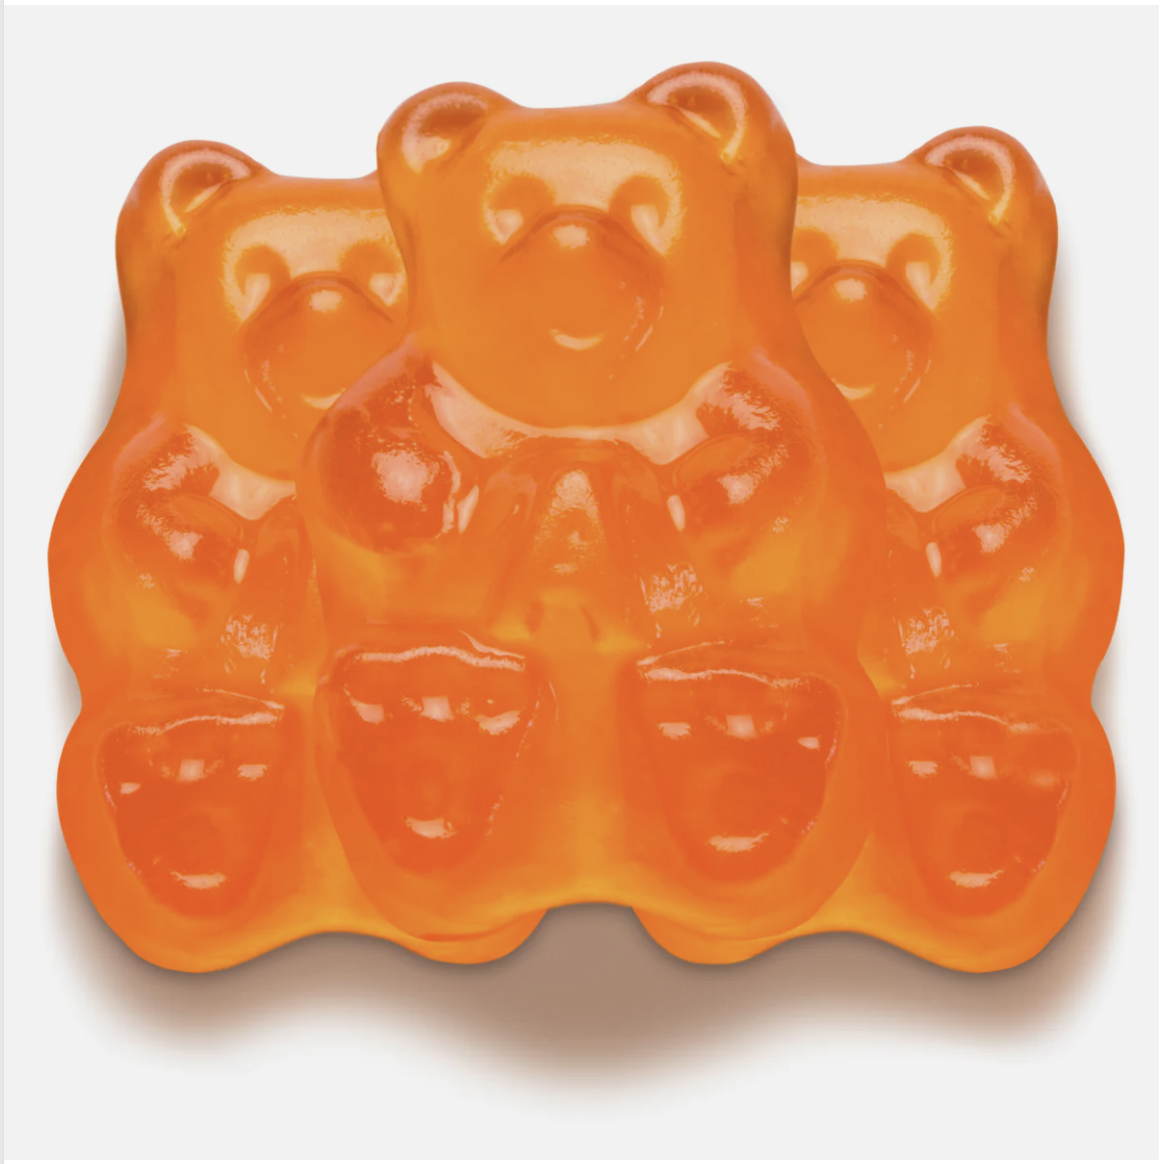
ip_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_gummy.png")
pipeline(
    prompt="best quality, high quality",
    image=image,
    ip_adapter_image=ip_image,
    strength=0.5,
).images[0]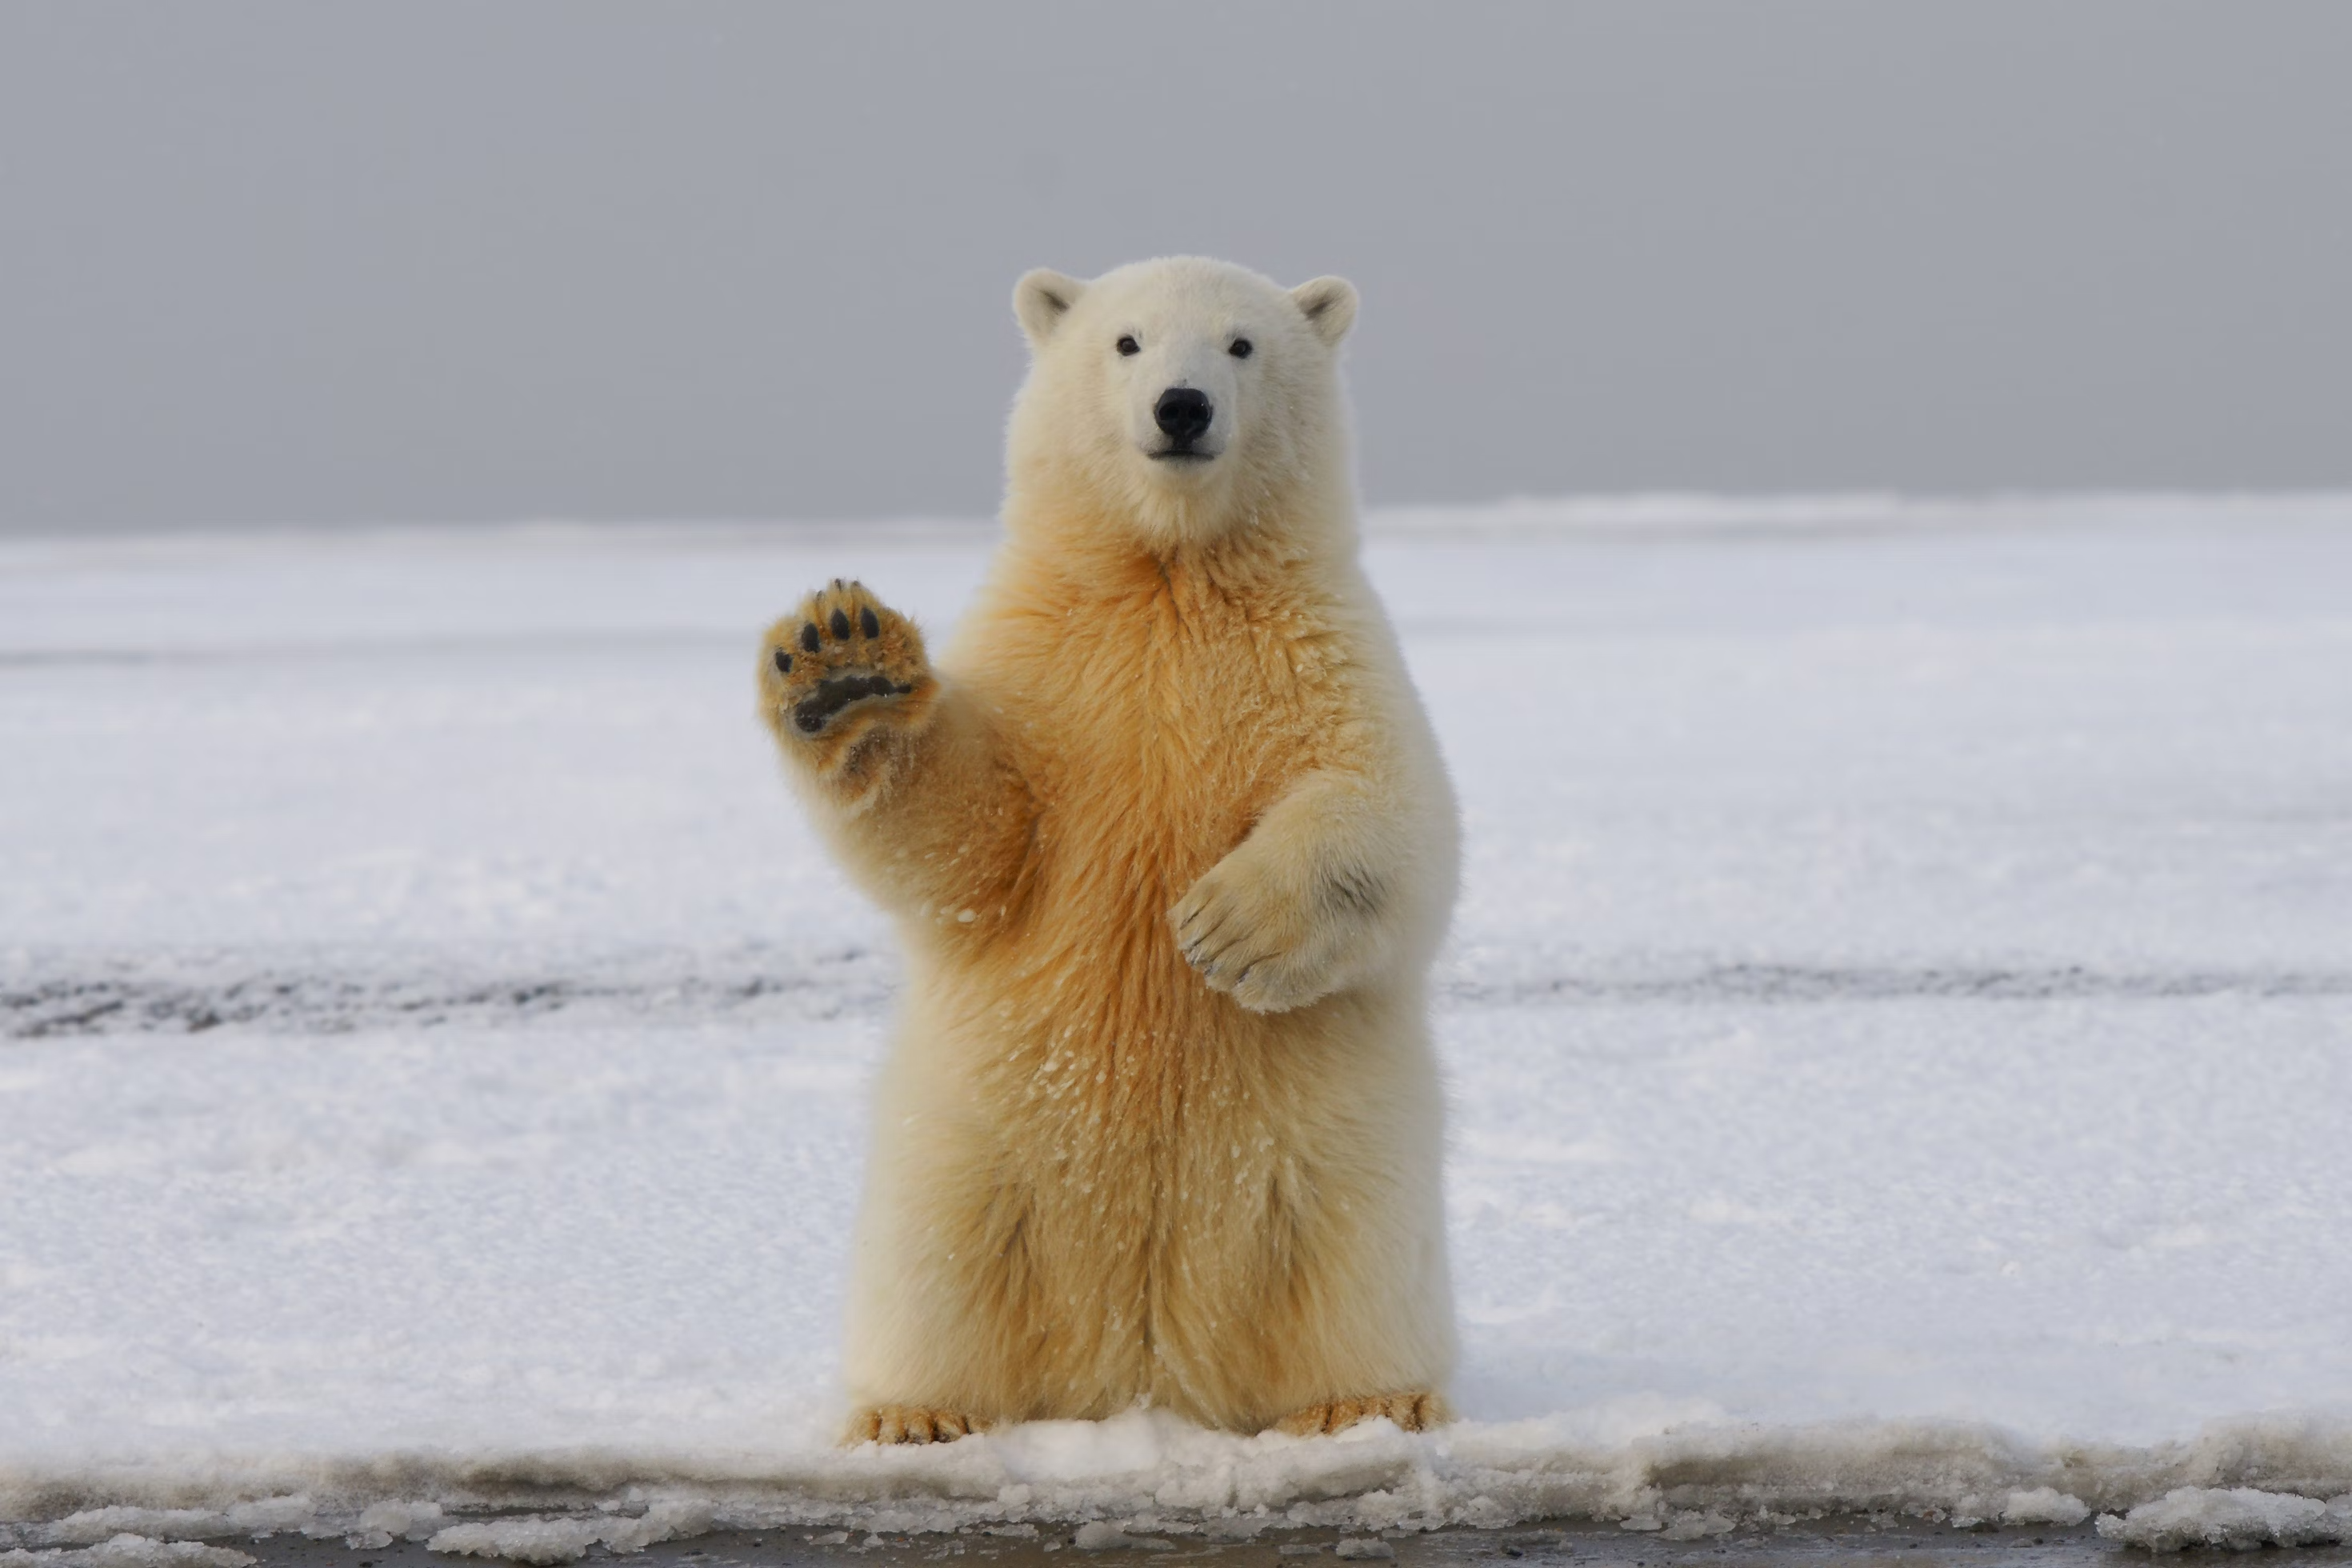
import torch
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image

pipeline = AutoPipelineForInpainting.from_pretrained(
  "stabilityai/stable-diffusion-xl-base-1.0",
  dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name="ip-adapter_sdxl.bin"
)
pipeline.set_ip_adapter_scale(0.6)

mask_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_mask.png")
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_bear_1.png")
ip_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_gummy.png")
pipeline(
    prompt="a cute gummy bear waving",
    image=image,
    mask_image=mask_image,
    ip_adapter_image=ip_image,
).images[0] 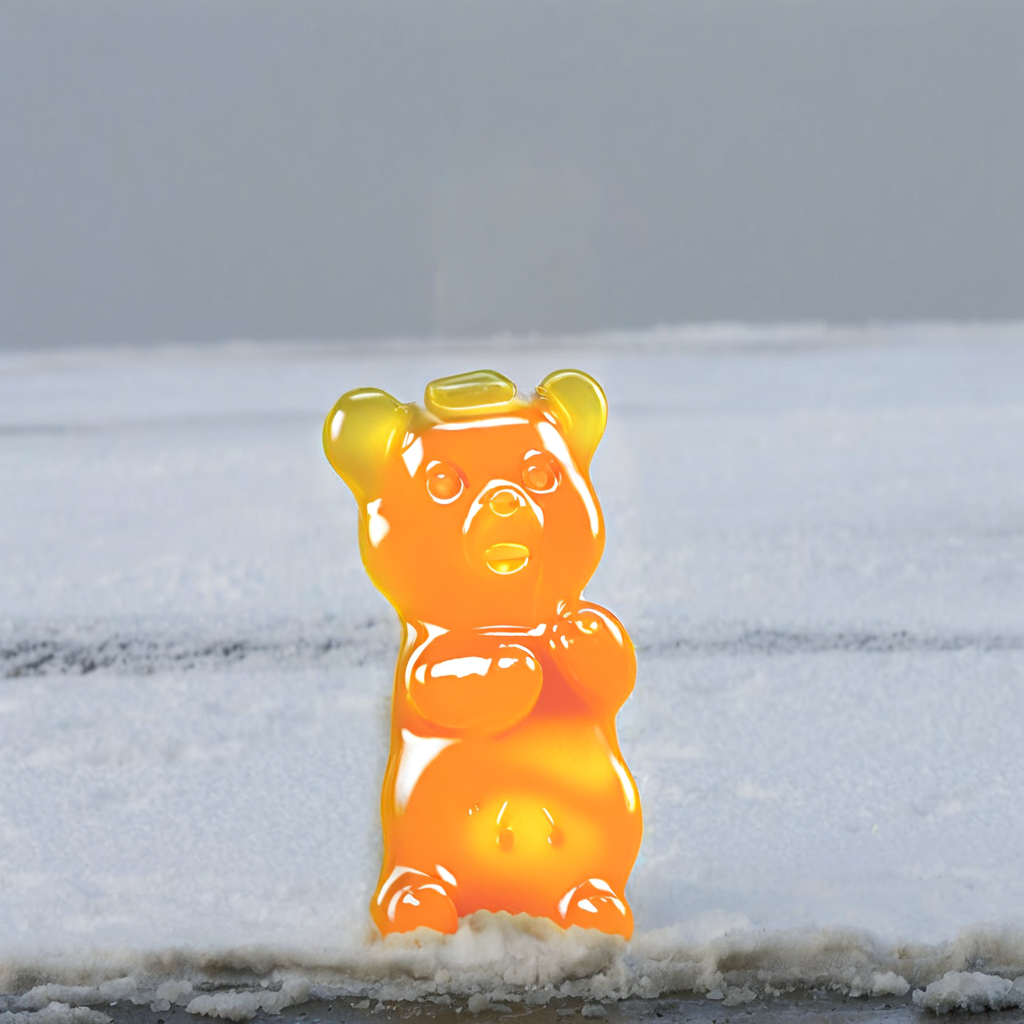
تُعدّ طريقة enable_model_cpu_offload() مفيدة لتقليل استهلاك الذاكرة، وينبغي تفعيلها بعد تحميل IP-Adapter. وإلا، فسيتم نقل مُشفِّر الصور الخاص بـ IP-Adapter إلى وحدة المعالجة المركزية (CPU) أيضاً، مما يؤدي إلى إرجاع خطأ.
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
from diffusers.utils import load_image

adapter = MotionAdapter.from_pretrained(
  "guoyww/animatediff-motion-adapter-v1-5-2",
  dtype=torch.float16
)
pipeline = AnimateDiffPipeline.from_pretrained(
  "emilianJR/epiCRealism",
  motion_adapter=adapter,
  dtype=torch.float16
)
scheduler = DDIMScheduler.from_pretrained(
    "emilianJR/epiCRealism",
    subfolder="scheduler",
    clip_sample=False,
    timestep_spacing="linspace",
    beta_schedule="linear",
    steps_offset=1,
)
pipeline.scheduler = scheduler
pipeline.vae.enable_slicing()
pipeline.load_ip_adapter("h94/IP-Adapter", subfolder="models", weight_name="ip-adapter_sd15.bin")
pipeline.enable_model_cpu_offload()

ip_adapter_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_inpaint.png")
pipeline(
    prompt="A cute gummy bear waving",
    negative_prompt="bad quality, worse quality, low resolution",
    ip_adapter_image=ip_adapter_image,
    num_frames=16,
    guidance_scale=7.5,
    num_inference_steps=50,
).frames[0] 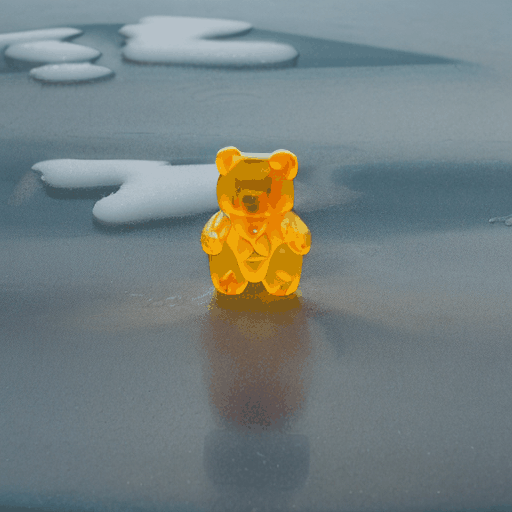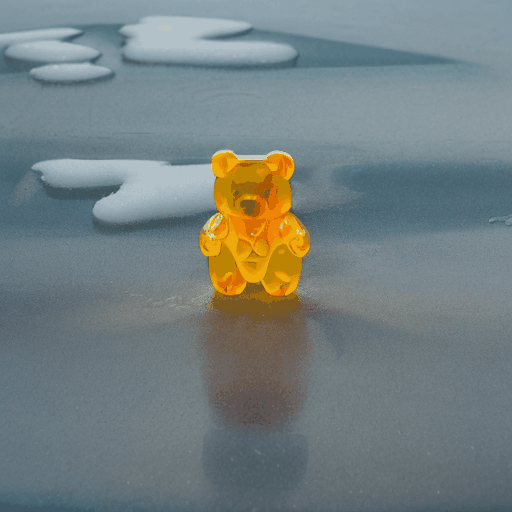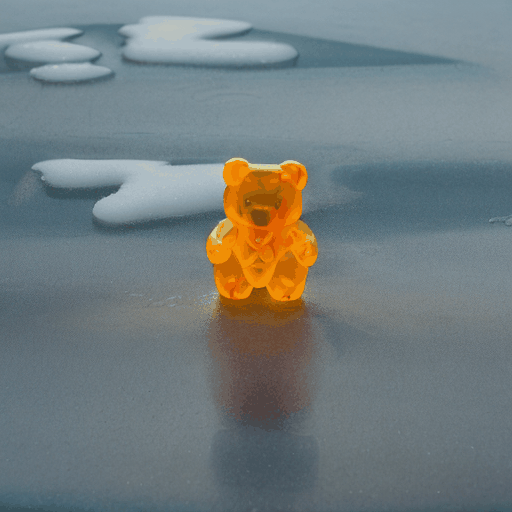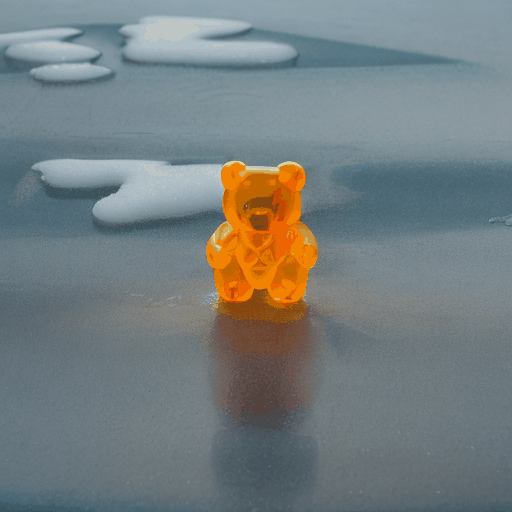
نسخ نقاط التفتيش
استخدم Plus عندما تكون التفاصيل من الصورة المرجعية هي الأهم. استخدم FaceID عندما تحتاج إلى تمثيلات هوية من InsightFace بدلاً من تمثيلات الصور من CLIP.
import torch
from transformers import CLIPVisionModelWithProjection
from diffusers import AutoPipelineForText2Image

image_encoder = CLIPVisionModelWithProjection.from_pretrained(
    "h94/IP-Adapter",
    subfolder="models/image_encoder",
    dtype=torch.float16
)

pipeline = AutoPipelineForText2Image.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    image_encoder=image_encoder,
    dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name="ip-adapter-plus_sdxl_vit-h.safetensors"
)
تستخدم نقاط التفتيش الخاصة بـ FaceID تمثيلات الوجه من InsightFace بدلاً من تمثيلات الصور من CLIP. استخدم DDIMScheduler أو EulerDiscreteScheduler لنماذج FaceID. استخرج تمثيلات الوجه وقم بتمريرها كقائمة من الموترات إلى ip_adapter_image_embeds.
# pip install insightface
import cv2
import numpy as np
import torch
from diffusers import StableDiffusionPipeline, DDIMScheduler
from diffusers.utils import load_image
from insightface.app import FaceAnalysis

pipeline = StableDiffusionPipeline.from_pretrained(
    "stable-diffusion-v1-5/stable-diffusion-v1-5",
    dtype=torch.float16,
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.scheduler = DDIMScheduler.from_config(pipeline.scheduler.config)
pipeline.load_ip_adapter(
  "h94/IP-Adapter-FaceID",
  subfolder=None,
  weight_name="ip-adapter-faceid_sd15.bin",
  image_encoder_folder=None
)
pipeline.set_ip_adapter_scale(0.6)

image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_mask_girl1.png")

ref_images_embeds = []
app = FaceAnalysis(name="buffalo_l", providers=['CUDAExecutionProvider', 'CPUExecutionProvider'])
app.prepare(ctx_id=0, det_size=(640, 640))
image = cv2.cvtColor(np.asarray(image), cv2.COLOR_RGB2BGR)
faces = app.get(image)
image = torch.from_numpy(faces[0].normed_embedding)
ref_images_embeds.append(image.unsqueeze(0))
ref_images_embeds = torch.stack(ref_images_embeds, dim=0).unsqueeze(0)
neg_ref_images_embeds = torch.zeros_like(ref_images_embeds)
id_embeds = torch.cat([neg_ref_images_embeds, ref_images_embeds]).to(dtype=torch.float16, device="cuda")

pipeline(
    prompt="A photo of a girl",
    ip_adapter_image_embeds=[id_embeds],
    negative_prompt="monochrome, lowres, bad anatomy, worst quality, low quality",
).images[0]
في FaceID Plus، حمّل CLIPVisionModelWithProjection كمُشفِّر للصور.
import torch
from transformers import CLIPVisionModelWithProjection
from diffusers import AutoPipelineForText2Image

image_encoder = CLIPVisionModelWithProjection.from_pretrained(
    "laion/CLIP-ViT-H-14-laion2B-s32B-b79K",
    dtype=torch.float16,
)

pipeline = AutoPipelineForText2Image.from_pretrained(
    "stable-diffusion-v1-5/stable-diffusion-v1-5",
    image_encoder=image_encoder,
    dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline.load_ip_adapter(
  "h94/IP-Adapter-FaceID",
  subfolder=None,
  weight_name="ip-adapter-faceid-plus_sd15.bin"
)
تحتاج FaceID Plus و Plus v2 أيضًا إلى تضمينات صور CLIP بالإضافة إلى تضمينات InsightFace. بعد إعداد تضمينات الوجه، قم بتشفير الصورة المرجعية ثم إسناد تضمينات CLIP إلى طبقة الإسقاط للصورة.
import torch
from diffusers.utils import load_image

ip_adapter_images = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_mask_girl1.png")
num_images = 1
clip_embeds = pipeline.prepare_ip_adapter_image_embeds(
    ip_adapter_image=[ip_adapter_images],
    ip_adapter_image_embeds=None,
    device=torch.device("cuda"),
    num_images_per_prompt=num_images,
    do_classifier_free_guidance=True,
)[0]

pipeline.unet.encoder_hid_proj.image_projection_layers[0].clip_embeds = clip_embeds.to(dtype=torch.float16)
# set to True if using IP-Adapter FaceID Plus v2
pipeline.unet.encoder_hid_proj.image_projection_layers[0].shortcut = False
تضمينات الصور
يقوم prepare_ip_adapter_image_embeds() بتشفير صور IP-Adapter إلى تمثيلات (embeddings) يمكنك حفظها وإعادة استخدامها. احسبها مسبقًا مرة واحدة بدلاً من تحميل وتشفير نفس الصور في كل مرة تشغّل فيها خط المعالجة (pipeline).
import torch
from diffusers import AutoPipelineForText2Image
from diffusers.utils import load_image

pipeline = AutoPipelineForText2Image.from_pretrained(
  "stabilityai/stable-diffusion-xl-base-1.0",
  dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name="ip-adapter_sdxl.bin"
)

image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_bear_1.png")
image_embeds = pipeline.prepare_ip_adapter_image_embeds(
    ip_adapter_image=image,
    ip_adapter_image_embeds=None,
    device="cuda",
    num_images_per_prompt=1,
    do_classifier_free_guidance=True,
)

torch.save(image_embeds, "image_embeds.ipadpt")
أعد تحميل تضمينات الصور عن طريق تمريرها إلى معامل ip_adapter_image_embeds. اضبط image_encoder_folder على None لأنك لم تعد بحاجة إلى مشفّر الصور لتوليد تضمينات الصور.
يمكنك أيضًا تحميل تمثيلات الصور من مصادر أخرى مثل ComfyUI.
pipeline = AutoPipelineForText2Image.from_pretrained(
  "stabilityai/stable-diffusion-xl-base-1.0",
  dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  image_encoder_folder=None,
  weight_name="ip-adapter_sdxl.bin"
)
pipeline.set_ip_adapter_scale(0.8)
image_embeds = torch.load("image_embeds.ipadpt")
pipeline(
    prompt="a polar bear sitting in a chair drinking a milkshake",
    ip_adapter_image_embeds=image_embeds,
    negative_prompt="deformed, ugly, wrong proportion, low res, bad anatomy, worst quality, low quality",
    num_inference_steps=100,
).images[0]
إخفاء
يتيح القناع الثنائي إسناد صورة IP-Adapter إلى منطقة محددة من الصورة الناتجة، مما يجعله مفيدًا لتكوين صور IP-Adapter متعددة. تتطلب كل صورة IP-Adapter قناعًا ثنائيًا.
قم بتحميل IPAdapterMaskProcessor لمعالجة أقنعة الصور مسبقًا. للحصول على أفضل النتائج، قم بتوفير قيم height وwidth الناتجة لضمان تحديد حجم الأقنعة ذات نسب الأبعاد المختلفة بشكل مناسب. إذا كانت أقنعة الإدخال تطابق بالفعل نسبة أبعاد الصورة المولّدة، فلا حاجة إلى تعيين height وwidth.
import torch
from diffusers import AutoPipelineForText2Image
from diffusers.image_processor import IPAdapterMaskProcessor
from diffusers.utils import load_image

pipeline = AutoPipelineForText2Image.from_pretrained(
  "stabilityai/stable-diffusion-xl-base-1.0",
  dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

mask1 = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_mask_mask1.png")
mask2 = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_mask_mask2.png")

processor = IPAdapterMaskProcessor()
masks = processor.preprocess([mask1, mask2], height=1024, width=1024)

قدّم صور IP-Adapter ومقاييسها على شكل قائمة. مرّر الأقنعة المُعالجة مسبقًا إلى cross_attention_kwargs في خطّ الأنابيب.
face_image1 = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_mask_girl1.png")
face_image2 = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_mask_girl2.png")

pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name=["ip-adapter-plus-face_sdxl_vit-h.safetensors"]
)
pipeline.set_ip_adapter_scale([[0.7, 0.7]])

ip_images = [[face_image1, face_image2]]
masks = [masks.reshape(1, masks.shape[0], masks.shape[2], masks.shape[3])]

pipeline(
  prompt="2 girls",
  ip_adapter_image=ip_images,
  negative_prompt="monochrome, lowres, bad anatomy, worst quality, low quality",
  cross_attention_kwargs={"ip_adapter_masks": masks}
).images[0]


وصفات
IP-Adapter يمكن دمجه مع محوِّلات أو خطوط أنابيب أخرى، مثل عدة محوِّلات، أو ControlNet، أو InstantStyle، أو LCM ذي الخطوات القليلة، عندما لا تكون صورة مرجعية واحدة كافية.
عدة محولات IP
دمج عدة IP-Adapters لتوليد صور بأساليب أكثر تنوعًا. على سبيل المثال، يمكنك استخدام IP-Adapter Face لتوليد وجوه وشخصيات متسقة، واستخدام IP-Adapter Plus لتوليد تلك الوجوه بأساليب محددة.
حمّل مُشفِّر الصور باستخدام CLIPVisionModelWithProjection.
import torch
from diffusers import AutoPipelineForText2Image, DDIMScheduler
from transformers import CLIPVisionModelWithProjection
from diffusers.utils import load_image

image_encoder = CLIPVisionModelWithProjection.from_pretrained(
    "h94/IP-Adapter",
    subfolder="models/image_encoder",
    dtype=torch.float16,
)
حمّل نموذجًا أساسيًا ومجدولًا والمُكيّفات التالية IP-Adapters.
- يستخدم ip-adapter-plus_sdxl_vit-h تضمينات الباتشات ومشفّر صور ViT-H
- يستخدم ip-adapter-plus-face_sdxl_vit-h تضمينات الباتشات ومشفّر صور ViT-H، لكنه مشروط بصور وجوه مقصوصة
pipeline = AutoPipelineForText2Image.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    dtype=torch.float16,
    image_encoder=image_encoder,
)
pipeline.scheduler = DDIMScheduler.from_config(pipeline.scheduler.config)
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name=["ip-adapter-plus_sdxl_vit-h.safetensors", "ip-adapter-plus-face_sdxl_vit-h.safetensors"]
)
pipeline.set_ip_adapter_scale([0.7, 0.3])
# enable_model_cpu_offload to reduce memory usage
pipeline.enable_model_cpu_offload()
حمّل صورة ومجلدًا يحتوي على صور بأسلوب معين لتطبيقه.
face_image = load_image("https://huggingface.co/datasets/YiYiXu/testing-images/resolve/main/women_input.png")
style_folder = "https://huggingface.co/datasets/YiYiXu/testing-images/resolve/main/style_ziggy"
style_images = [load_image(f"{style_folder}/img{i}.png") for i in range(10)]

مرّر صور النمط والوجه كقائمة إلى ip_adapter_image.
generator = torch.Generator(device="cpu").manual_seed(0)

pipeline(
    prompt="wonderwoman",
    ip_adapter_image=[style_images, face_image],
    negative_prompt="monochrome, lowres, bad anatomy, worst quality, low quality",
).images[0]
التحكم الهيكلي
للتحكم الهيكلي، ادمج IP-Adapter مع ControlNet المشروط بخرائط العمق، وخرائط الحواف، وتقديرات الوضعية، وغيرها.
يُحمّل المثال أدناه نقطة تحقق ControlNetModel مشروطة على خرائط العمق ويجمعها مع IP-Adapter.
import torch
from diffusers.utils import load_image
from diffusers import StableDiffusionControlNetPipeline, ControlNetModel

controlnet = ControlNetModel.from_pretrained(
  "lllyasviel/control_v11f1p_sd15_depth",
  dtype=torch.float16
)

pipeline = StableDiffusionControlNetPipeline.from_pretrained(
    "stable-diffusion-v1-5/stable-diffusion-v1-5",
    controlnet=controlnet,
    dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="models",
  weight_name="ip-adapter_sd15.bin"
)
مرّر خريطة العمق وصورة IP-Adapter إلى خط الأنابيب.
depth_map = load_image("https://huggingface.co/datasets/YiYiXu/testing-images/resolve/main/depth.png")
ip_adapter_image = load_image("https://huggingface.co/datasets/YiYiXu/testing-images/resolve/main/statue.png")
pipeline(
  prompt="best quality, high quality",
  image=depth_map,
  ip_adapter_image=ip_adapter_image,
  negative_prompt="monochrome, lowres, bad anatomy, worst quality, low quality",
).images[0]


التحكم في النمط والتخطيط
للتحكم في الأسلوب والتخطيط، ادمج IP-Adapter مع InstantStyle. يفصل InstantStyle بين الأسلوب (اللون، الملمس، الإحساس العام) والمحتوى، ويطبّق الأسلوب فقط في الكتل الخاصة بالأسلوب حتى تبقى مناطق المحتوى سليمة. ومنح ذلك اتساقاً أقوى للأسلوب وتحكماً أوضح في التخطيط.
فعّل IP-Adapter في طبقات محددة فقط باستخدام set_ip_adapter_scale(). يُظهر المثال أدناه تفعيله في كتلة block_2 السفلية (التخطيط) وكتلة block_0 العلوية (النمط) في النموذج.
import torch
from diffusers import AutoPipelineForText2Image
from diffusers.utils import load_image

pipeline = AutoPipelineForText2Image.from_pretrained(
  "stabilityai/stable-diffusion-xl-base-1.0",
  dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name="ip-adapter_sdxl.bin"
)

scale = {
    "down": {"block_2": [0.0, 1.0]},
    "up": {"block_0": [0.0, 1.0, 0.0]},
}
pipeline.set_ip_adapter_scale(scale)
حمّل صورة النمط وأنشئ صورة.
style_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/0052a70beed5bf71b92610a43a52df6d286cd5f3/diffusers/rabbit.jpg")

pipeline(
    prompt="a cat, masterpiece, best quality, high quality",
    ip_adapter_image=style_image,
    negative_prompt="text, watermark, lowres, low quality, worst quality, deformed, glitch, low contrast, noisy, saturation, blurry",
    guidance_scale=5,
).images[0]

تقارن الأرقام أدناه تفعيل InstantStyle الخاص بالأسلوب فقط (حتى block_0) مع تشغيل IP-Adapter في جميع الطبقات. عادةً ما يتبع وضع جميع الطبقات موجه الصورة بشكل أقوى وقد يقلل من التنوع. يُفضَّل مقياس الأسلوب فقط عندما تريد سلوك InstantStyle الذي يحافظ على التخطيط.
لا تحتاج إلى تحديد جميع الطبقات في قاموس
scale. تُضبط الطبقات غير المدرجة على 0، مما يعني تعطيل IP-Adapter.
scale = {
    "up": {"block_0": [0.0, 1.0, 0.0]},
}
pipeline.set_ip_adapter_scale(scale)

pipeline(
    prompt="a cat, masterpiece, best quality, high quality",
    ip_adapter_image=style_image,
    negative_prompt="text, watermark, lowres, low quality, worst quality, deformed, glitch, low contrast, noisy, saturation, blurry",
    guidance_scale=5,
).images[0]

التوليد الفوري
ادمج IP-Adapter مع LoRA الخاص بـ LCM لتوليد الصور في عدد قليل من الخطوات.
import torch
from diffusers import DiffusionPipeline, LCMScheduler
from diffusers.utils import load_image

pipeline = DiffusionPipeline.from_pretrained(
  "sd-dreambooth-library/herge-style",
  dtype=torch.float16
)
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="models",
  weight_name="ip-adapter_sd15.bin"
)
pipeline.load_lora_weights("latent-consistency/lcm-lora-sdv1-5")
pipeline.scheduler = LCMScheduler.from_config(pipeline.scheduler.config)
pipeline.enable_model_cpu_offload()

pipeline.set_ip_adapter_scale(0.4)
ip_adapter_image = load_image("https://user-images.githubusercontent.com/24734142/266492875-2d50d223-8475-44f0-a7c6-08b51cb53572.png")
pipeline(
    prompt="herge_style woman in armor, best quality, high quality",
    ip_adapter_image=ip_adapter_image,
    num_inference_steps=4,
    guidance_scale=1,
).images[0]