
Accelerate documentation
DeepSpeed
DeepSpeed
DeepSpeed реализует всё, что описано в статье ZeRO. Среди ключевых оптимизаций:
- Разделение состояния оптимизатора (ZeRO stage 1)
- Разделение градиентов (ZeRO stage 2)
- Разделение параметров (ZeRO stage 3)
- Пользовательская обработка обучения с смешанной точностью
- Набор быстрых оптимизаторов на основе CUDA-расширений
- ZeRO-Offload на CPU и диск/NVMe
- Иерархическое разбиение параметров модели (ZeRO++)
У ZeRO-Offload есть собственная статья: ZeRO-Offload: Democratizing Billion-Scale Model Training. Поддержка NVMe описана в статье ZeRO-Infinity: Breaking the GPU Memory Wall for Extreme Scale Deep Learning.
DeepSpeed ZeRO-2 используется преимущественно только для обучения, так как его функции не приносят пользы при инференсе.
DeepSpeed ZeRO-3 можно использовать и для инференса, поскольку он позволяет загружать огромные модели на несколько GPU, что было бы невозможно на одном GPU.
Accelerate интегрирует DeepSpeed двумя способами:
- Интеграция функций DeepSpeed через указание
deepspeed config fileвaccelerate config. Достаточно предоставить собственный файл конфигурации или использовать наш шаблон. Основная часть этого документа посвящена именно этой функции. Она поддерживает все основные возможности DeepSpeed и предоставляет пользователю значительную гибкость. В зависимости от конфигурации может потребоваться изменить несколько строк кода. - Интеграция через
deepspeed_plugin. Это поддерживает подмножество функций DeepSpeed и использует параметры по умолчанию для остальных настроек. Пользователю не нужно менять код, что подходит тем, кто устраивает большинство настроек DeepSpeed по умолчанию.
Что интегрировано?
Обучение:
- Accelerate интегрирует все возможности DeepSpeed ZeRO. Сюда входят все этапы ZeRO 1, 2 и 3, а также ZeRO-Offload, ZeRO-Infinity (позволяет выгружать данные на диск/NVMe) и ZeRO++.
Ниже приведено краткое описание Data Parallelism с использованием ZeRO - Zero Redundancy Optimizer, а также диаграмма из этой статьи в блоге
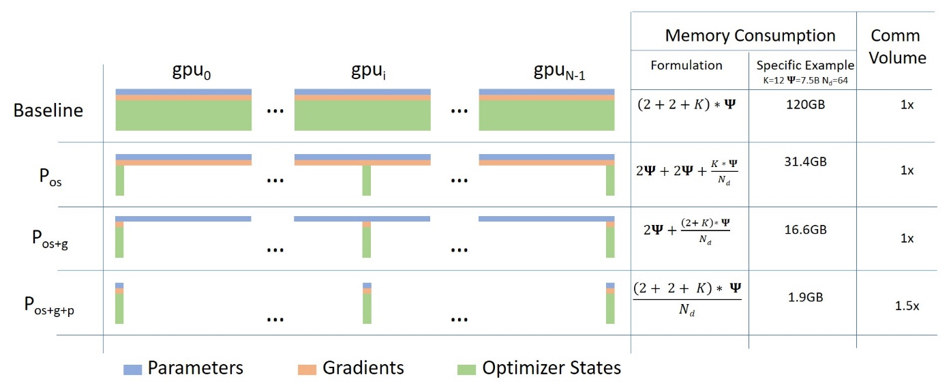
(Источник: ссылка)
a. Этап 1 : Размещение состояний оптимизатора по рабочим процессам/GPU с параллелизмом данных
b. Этап 2: разделение состояний оптимизатора и градиентов между рабочими процессами/GPU с параллелизмом данных
c. Stage 3: Разбивает состояния оптимизатора + градиенты + параметры модели между рабочими процессами/GPU с параллелизмом данных
d. Optimizer Offload: выгружает градиенты и состояния оптимизатора на CPU/диск, расширяя возможности ZERO Stage 2
e. Param Offload: выгружает параметры модели в CPU/на диск, расширяя возможности ZERO Stage 3
f. Иерархическое разделение: обеспечивает эффективное обучение на нескольких узлах с использованием параллельного обучения по данным между узлами и шардирования ZeRO-3 внутри узла, построено на основе ZeRO Stage 3.
Note: With respect to Disk Offload, the disk should be an NVME for decent speed but it technically works on any DiskВывод:
- DeepSpeed ZeRO Inference поддерживает ZeRO stage 3 с ZeRO-Infinity. Он использует тот же протокол ZeRO, что и обучение, но не применяет оптимизатор и планировщик скорости обучения, а актуальна только stage 3. Подробнее: ZeRO Inference.
Как это работает?
Предварительные требования: установите версию DeepSpeed >=0.6.5. Подробности см. в разделе Установка DeepSpeed.
Сначала мы рассмотрим простую в использовании интеграцию через accelerate config.
Затем перейдём к более гибкой и функциональной интеграции с помощью deepspeed config file.
Плагин DeepSpeed для Accelerate
На вашем(их) компьютере(ах) просто выполните:
accelerate config
и отвечайте на задаваемые вопросы. Вас спросят, хотите ли вы использовать файл конфигурации для DeepSpeed, на что следует ответить «нет». Затем ответьте на следующие вопросы, чтобы создать базовую конфигурацию DeepSpeed. В результате будет создан файл конфигурации, который будет автоматически использоваться для корректной настройки параметров по умолчанию при выполнении
accelerate launch my_script.py --args_to_my_script
Например, вот как запустить пример NLP examples/nlp_example.py (из корня репозитория) с DeepSpeed Plugin:
Пример плагина DeepSpeed для ZeRO Stage-2
compute_environment: LOCAL_MACHINE
deepspeed_config:
 gradient_accumulation_steps: 1
 gradient_clipping: 1.0
 offload_optimizer_device: none
 offload_param_device: none
 zero3_init_flag: true
 zero_stage: 2
distributed_type: DEEPSPEED
fsdp_config: {}
machine_rank: 0
main_process_ip: null
main_process_port: null
main_training_function: main
mixed_precision: fp16
num_machines: 1
num_processes: 2
use_cpu: falseaccelerate launch examples/nlp_example.py --mixed_precision fp16
Пример плагина DeepSpeed для ZeRO Stage-3 с выгрузкой на CPU
compute_environment: LOCAL_MACHINE
deepspeed_config:
  gradient_accumulation_steps: 1
  gradient_clipping: 1.0
  offload_optimizer_device: cpu
  offload_param_device: cpu
  zero3_init_flag: true
  zero3_save_16bit_model: true
  zero_stage: 3
distributed_type: DEEPSPEED
fsdp_config: {}
machine_rank: 0
main_process_ip: null
main_process_port: null
main_training_function: main
mixed_precision: fp16
num_machines: 1
num_processes: 2
use_cpu: falseaccelerate launch examples/nlp_example.py --mixed_precision fp16
В настоящее время Accelerate поддерживает следующую конфигурацию через CLI:
`zero_stage`: [0] Disabled, [1] optimizer state partitioning, [2] optimizer+gradient state partitioning and [3] optimizer+gradient+parameter partitioning
`gradient_accumulation_steps`: Number of training steps to accumulate gradients before averaging and applying them.
`gradient_clipping`: Enable gradient clipping with value.
`offload_optimizer_device`: [none] Disable optimizer offloading, [cpu] offload optimizer to CPU, [nvme] offload optimizer to NVMe SSD. Only applicable with ZeRO >= Stage-2.
`offload_optimizer_nvme_path`: Decides Nvme Path to offload optimizer states. If unspecified, will default to 'none'.
`offload_param_device`: [none] Disable parameter offloading, [cpu] offload parameters to CPU, [nvme] offload parameters to NVMe SSD. Only applicable with ZeRO Stage-3.
`offload_param_nvme_path`: Decides Nvme Path to offload parameters. If unspecified, will default to 'none'.
`zero3_init_flag`: Decides whether to enable `deepspeed.zero.Init` for constructing massive models. Only applicable with ZeRO Stage-3.
`zero3_save_16bit_model`: Decides whether to save 16-bit model weights when using ZeRO Stage-3.
`mixed_precision`: `no` for FP32 training, `fp16` for FP16 mixed-precision training and `bf16` for BF16 mixed-precision training.
`deepspeed_moe_layer_cls_names`: Comma-separated list of transformer Mixture-of-Experts (MoE) layer class names (case-sensitive) to wrap ,e.g, `MixtralSparseMoeBlock`, `Qwen2MoeSparseMoeBlock`, `JetMoEAttention,JetMoEBlock` ...
`deepspeed_hostfile`: DeepSpeed hostfile for configuring multi-node compute resources.
`deepspeed_exclusion_filter`: DeepSpeed exclusion filter string when using mutli-node setup.
`deepspeed_inclusion_filter`: DeepSpeed inclusion filter string when using mutli-node setup.
`deepspeed_multinode_launcher`: DeepSpeed multi-node launcher to use, e.g. `pdsh`, `standard`, `openmpi`, `mvapich`, `mpich`, `slurm`, `nossh` (requires DeepSpeed >= 0.14.5). If unspecified, will default to `pdsh`.
`deepspeed_config_file`: path to the DeepSpeed config file in `json` format. See the next section for more details on this.
Чтобы настроить дополнительные параметры, необходимо использовать файл конфигурации DeepSpeed.
Файл конфигурации DeepSpeed
На вашем(их) компьютере(ах) просто выполните:
accelerate config
и отвечайте на задаваемые вопросы. Вас спросят, хотите ли вы использовать файл конфигурации для deepspeed, на что нужно ответить «да» и указать путь к файлу конфигурации deepspeed. В результате будет создан файл конфигурации, который будет автоматически использоваться для корректной настройки параметров по умолчанию при выполнении
accelerate launch my_script.py --args_to_my_script
Например, вот как запустить пример NLP examples/by_feature/deepspeed_with_config_support.py (из корня репозитория) с использованием конфигурационного файла DeepSpeed:
Пример файла конфигурации DeepSpeed для ZeRO Stage-2
compute_environment: LOCAL_MACHINE
deepspeed_config:
 deepspeed_config_file: /home/ubuntu/accelerate/examples/deepspeed_config_templates/zero_stage2_config.json
 zero3_init_flag: true
distributed_type: DEEPSPEED
fsdp_config: {}
machine_rank: 0
main_process_ip: null
main_process_port: null
main_training_function: main
mixed_precision: fp16
num_machines: 1
num_processes: 2
use_cpu: false
содержимым zero_stage2_config.json является:
{
    "fp16": {
        "enabled": true,
        "loss_scale": 0,
        "loss_scale_window": 1000,
        "initial_scale_power": 16,
        "hysteresis": 2,
        "min_loss_scale": 1
    },
    "optimizer": {
        "type": "AdamW",
        "params": {
            "lr": "auto",
            "weight_decay": "auto",
            "torch_adam": true,
            "adam_w_mode": true
        }
    },
    "scheduler": {
        "type": "WarmupDecayLR",
        "params": {
            "warmup_min_lr": "auto",
            "warmup_max_lr": "auto",
            "warmup_num_steps": "auto",
            "total_num_steps": "auto"
        }
    },
    "zero_optimization": {
        "stage": 2,
        "allgather_partitions": true,
        "allgather_bucket_size": 2e8,
        "overlap_comm": true,
        "reduce_scatter": true,
        "reduce_bucket_size": "auto",
        "contiguous_gradients": true
    },
    "gradient_accumulation_steps": 1,
    "gradient_clipping": "auto",
    "steps_per_print": 2000,
    "train_batch_size": "auto",
    "train_micro_batch_size_per_gpu": "auto",
    "wall_clock_breakdown": false
}accelerate launch examples/by_feature/deepspeed_with_config_support.py \
--config_name "gpt2-large" \
--tokenizer_name "gpt2-large" \
--dataset_name "wikitext" \
--dataset_config_name "wikitext-2-raw-v1" \
--block_size 128 \
--output_dir "./clm/clm_deepspeed_stage2_accelerate" \
--learning_rate 5e-4 \
--per_device_train_batch_size 24 \
--per_device_eval_batch_size 24 \
--num_train_epochs 3 \
--with_tracking \
--report_to "wandb"\Пример файла конфигурации DeepSpeed для ZeRO Stage-3 с выгрузкой на CPU
compute_environment: LOCAL_MACHINE
deepspeed_config:
 deepspeed_config_file: /home/ubuntu/accelerate/examples/deepspeed_config_templates/zero_stage3_offload_config.json
 zero3_init_flag: true
distributed_type: DEEPSPEED
fsdp_config: {}
machine_rank: 0
main_process_ip: null
main_process_port: null
main_training_function: main
mixed_precision: fp16
num_machines: 1
num_processes: 2
use_cpu: false
содержимым zero_stage3_offload_config.json является:
{
    "fp16": {
        "enabled": true,
        "loss_scale": 0,
        "loss_scale_window": 1000,
        "initial_scale_power": 16,
        "hysteresis": 2,
        "min_loss_scale": 1
    },
    "optimizer": {
        "type": "AdamW",
        "params": {
            "lr": "auto",
            "weight_decay": "auto"
        }
    },
    "scheduler": {
        "type": "WarmupDecayLR",
        "params": {
            "warmup_min_lr": "auto",
            "warmup_max_lr": "auto",
            "warmup_num_steps": "auto",
            "total_num_steps": "auto"
        }
    },
    "zero_optimization": {
        "stage": 3,
        "offload_optimizer": {
            "device": "cpu",
            "pin_memory": true
        },
        "offload_param": {
            "device": "cpu",
            "pin_memory": true
        },
        "overlap_comm": true,
        "contiguous_gradients": true,
        "reduce_bucket_size": "auto",
        "stage3_prefetch_bucket_size": "auto",
        "stage3_param_persistence_threshold": "auto",
        "sub_group_size": 1e9,
        "stage3_max_live_parameters": 1e9,
        "stage3_max_reuse_distance": 1e9,
        "stage3_gather_16bit_weights_on_model_save": "auto"
    },
    "gradient_accumulation_steps": 1,
    "gradient_clipping": "auto",
    "steps_per_print": 2000,
    "train_batch_size": "auto",
    "train_micro_batch_size_per_gpu": "auto",
    "wall_clock_breakdown": false
}accelerate launch examples/by_feature/deepspeed_with_config_support.py \
--config_name "gpt2-large" \
--tokenizer_name "gpt2-large" \
--dataset_name "wikitext" \
--dataset_config_name "wikitext-2-raw-v1" \
--block_size 128 \
--output_dir "./clm/clm_deepspeed_stage3_offload_accelerate" \
--learning_rate 5e-4 \
--per_device_train_batch_size 32 \
--per_device_eval_batch_size 32 \
--num_train_epochs 3 \
--with_tracking \
--report_to "wandb"\Пример конфигурации ZeRO++ Вы можете использовать возможности ZeRO++, задав соответствующие параметры конфигурации. Обратите внимание, что ZeRO++ является расширением ZeRO Stage 3. Вот как можно изменить файл конфигурации, согласно туториалу DeepSpeed по ZeRO++:
{
    "zero_optimization": {
        "stage": 3,
        "reduce_bucket_size": "auto",

        "zero_quantized_weights": true,
        "zero_hpz_partition_size": 8,
        "zero_quantized_gradients": true,

        "contiguous_gradients": true,
        "overlap_comm": true
    }
}
Для иерархического разбиения размер части zero_hpz_partition_size в идеале должен быть установлен в значение количества GPU на узле. (Например, приведённый выше файл конфигурации предполагает 8 GPU на узле)
Важные изменения в коде при использовании файла конфигурации DeepSpeed
DeepSpeed Optimizers and Schedulers. Для получения дополнительной информации о них см. документацию DeepSpeed Optimizers и DeepSpeed Schedulers. Ниже мы рассмотрим изменения, необходимые в коде при использовании этих компонентов.
a. DS Optim + DS Scheduler: случай, когда в файле конфигурации DeepSpeed присутствуют оба ключа
optimizerиscheduler. В этой ситуации они будут использованы, и пользователю необходимо применятьaccelerate.utils.DummyOptimиaccelerate.utils.DummySchedulerдля замены оптимизаторов и планировщиков PyTorch/кастомных в своем коде. Ниже приведен фрагмент изexamples/by_feature/deepspeed_with_config_support.py, демонстрирующий это:# Creates Dummy Optimizer if `optimizer` was specified in the config file else creates Adam Optimizer optimizer_cls = ( torch.optim.AdamW if accelerator.state.deepspeed_plugin is None or "optimizer" not in accelerator.state.deepspeed_plugin.deepspeed_config else DummyOptim ) optimizer = optimizer_cls(optimizer_grouped_parameters, lr=args.learning_rate) # Creates Dummy Scheduler if `scheduler` was specified in the config file else creates `args.lr_scheduler_type` Scheduler if ( accelerator.state.deepspeed_plugin is None or "scheduler" not in accelerator.state.deepspeed_plugin.deepspeed_config ): lr_scheduler = get_scheduler( name=args.lr_scheduler_type, optimizer=optimizer, num_warmup_steps=args.num_warmup_steps, num_training_steps=args.max_train_steps, ) else: lr_scheduler = DummyScheduler( optimizer, total_num_steps=args.max_train_steps, warmup_num_steps=args.num_warmup_steps )b. Свой оптимизатор + свой планировщик: случай, когда в файле конфигурации DeepSpeed отсутствуют ключи
optimizerиscheduler. В этой ситуации пользователю не требуется вносить изменения в код, и именно этот случай возникает при использовании интеграции через DeepSpeed Plugin. В приведённом выше примере видно, что код остаётся без изменений, если в файле конфигурации DeepSpeed отсутствуют ключиoptimizerиscheduler.c. Свой оптимизатор + планировщик DS: случай, когда в файле конфигурации DeepSpeed присутствует только ключ
scheduler. В этой ситуации пользователю необходимо использоватьaccelerate.utils.DummySchedulerдля замены планировщика PyTorch/своего планировщика в коде.d. DS Optim + Custom Scheduler: случай, когда в файле конфигурации DeepSpeed присутствует только ключ
optimizer. Это приведёт к ошибке, так как DS Scheduler можно использовать только вместе с DS Optim.Обратите внимание на значения
autoв приведённых выше файлах конфигурации DeepSpeed. Они обрабатываются автоматически методомprepareна основе модели, загрузчиков данных, фиктивного оптимизатора и фиктивных планировщиков, переданных в методprepare. Обрабатываются методомprepareтолько поляauto, указанные в приведённых выше примерах, остальные необходимо явно указать пользователю.
Значения auto вычисляются следующим образом:
reduce_bucket_size:hidden_size * hidden_sizestage3_prefetch_bucket_size:int(0.9 * hidden_size * hidden_size)stage3_param_persistence_threshold:10 * hidden_size
Для работы функции auto с этими тремя параметрами конфигурации Accelerate использует model.config.hidden_size или max(model.config.hidden_sizes) в качестве hidden_size. Если ни одно из этих значений недоступно, запуск завершится с ошибкой, и вам придётся задать эти три параметра конфигурации вручную. Помните, что первые два параметра конфигурации — это буферы коммуникации: чем они больше, тем эффективнее будет обмен данными, но тем больше видеопамяти GPU они будут потреблять, поэтому это настраиваемый компромисс между производительностью и ресурсами.
Особенности использования файла конфигурации DeepSpeed
Ниже приведён пример скрипта, использующего deepspeed_config_file в различных сценариях.
Код test.py:
from accelerate import Accelerator
from accelerate.state import AcceleratorState


def main():
    accelerator = Accelerator()
    accelerator.print(f"{AcceleratorState()}")


if __name__ == "__main__":
    main()
Сценарий 1: вручную изменённый файл конфигурации accelerate, содержащий deepspeed_config_file наряду с другими параметрами.
- Содержимое конфигурации
accelerate:
command_file: null
commands: null
compute_environment: LOCAL_MACHINE
deepspeed_config:
  gradient_accumulation_steps: 1
  gradient_clipping: 1.0
  offload_optimizer_device: 'cpu'
  offload_param_device: 'cpu'
  zero3_init_flag: true
  zero3_save_16bit_model: true
  zero_stage: 3
  deepspeed_config_file: 'ds_config.json'
distributed_type: DEEPSPEED
downcast_bf16: 'no'
dynamo_backend: 'NO'
fsdp_config: {}
gpu_ids: null
machine_rank: 0
main_process_ip: null
main_process_port: null
main_training_function: main
megatron_lm_config: {}
num_machines: 1
num_processes: 2
rdzv_backend: static
same_network: true
tpu_name: null
tpu_zone: null
use_cpu: falseds_config.json:
{
    "bf16": {
        "enabled": true
    },
    "zero_optimization": {
        "stage": 3,
        "stage3_gather_16bit_weights_on_model_save": false,
        "offload_optimizer": {
            "device": "none"
        },
        "offload_param": {
            "device": "none"
        }
    },
    "gradient_clipping": 1.0,
    "train_batch_size": "auto",
    "train_micro_batch_size_per_gpu": "auto",
    "gradient_accumulation_steps": 10,
    "steps_per_print": 2000000
}- Вывод
accelerate launch test.py:
ValueError: When using `deepspeed_config_file`, the following accelerate config variables will be ignored:
['gradient_accumulation_steps', 'gradient_clipping', 'zero_stage', 'offload_optimizer_device', 'offload_param_device',
'zero3_save_16bit_model', 'mixed_precision'].
Please specify them appropriately in the DeepSpeed config file.
If you are using an accelerate config file, remove other config variables mentioned in the above specified list.
The easiest method is to create a new config following the questionnaire via `accelerate config`.
It will only ask for the necessary config variables when using `deepspeed_config_file`.
Сценарий 2: используйте решение ошибки для создания нового accelerate config и убедитесь, что теперь ошибка неоднозначности не возникает.
- Запустите
accelerate config:
$ accelerate config
-------------------------------------------------------------------------------------------------------------------------------
In which compute environment are you running?
This machine
-------------------------------------------------------------------------------------------------------------------------------
Which type of machine are you using?
multi-GPU
How many different machines will you use (use more than 1 for multi-node training)? [1]:
Do you wish to optimize your script with torch dynamo?[yes/NO]:
Do you want to use DeepSpeed? [yes/NO]: yes
Do you want to specify a json file to a DeepSpeed config? [yes/NO]: yes
Please enter the path to the json DeepSpeed config file: ds_config.json
Do you want to enable `deepspeed.zero.Init` when using ZeRO Stage-3 for constructing massive models? [yes/NO]: yes
How many GPU(s) should be used for distributed training? [1]:4
accelerate configuration saved at ds_config_sample.yaml- Содержимое конфигурации
accelerate:
compute_environment: LOCAL_MACHINE
deepspeed_config:
  deepspeed_config_file: ds_config.json
  zero3_init_flag: true
distributed_type: DEEPSPEED
downcast_bf16: 'no'
dynamo_backend: 'NO'
fsdp_config: {}
machine_rank: 0
main_training_function: main
megatron_lm_config: {}
num_machines: 1
num_processes: 4
rdzv_backend: static
same_network: true
use_cpu: false- Вывод
accelerate launch test.py:
Distributed environment: DEEPSPEED  Backend: nccl
Num processes: 4
Process index: 0
Local process index: 0
Device: cuda:0
Mixed precision type: bf16
ds_config: {'bf16': {'enabled': True}, 'zero_optimization': {'stage': 3, 'stage3_gather_16bit_weights_on_model_save': False, 'offload_optimizer': {'device': 'none'}, 'offload_param': {'device': 'none'}}, 'gradient_clipping': 1.0, 'train_batch_size': 'auto', 'train_micro_batch_size_per_gpu': 'auto', 'gradient_accumulation_steps': 10, 'steps_per_print': inf, 'fp16': {'enabled': False}}
Сценарий 3: установите аргументы команды accelerate launch, связанные с DeepSpeed, в значение "auto" в файле конфигурации DeepSpeed и убедитесь, что всё работает как ожидается.
- Новый
ds_config.jsonс"auto"для аргументов командыaccelerate launchDeepSpeed:
{
    "bf16": {
        "enabled": "auto"
    },
    "zero_optimization": {
        "stage": "auto",
        "stage3_gather_16bit_weights_on_model_save": "auto",
        "offload_optimizer": {
            "device": "auto"
        },
        "offload_param": {
            "device": "auto"
        }
    },
    "gradient_clipping": "auto",
    "train_batch_size": "auto",
    "train_micro_batch_size_per_gpu": "auto",
    "gradient_accumulation_steps": "auto",
    "steps_per_print": 2000000
}- Вывод
accelerate launch --mixed_precision="fp16" --zero_stage=3 --gradient_accumulation_steps=5 --gradient_clipping=1.0 --offload_param_device="cpu" --offload_optimizer_device="nvme" --zero3_save_16bit_model="true" test.py:
Distributed environment: DEEPSPEED  Backend: nccl
Num processes: 4
Process index: 0
Local process index: 0
Device: cuda:0
Mixed precision type: fp16
ds_config: {'bf16': {'enabled': False}, 'zero_optimization': {'stage': 3, 'stage3_gather_16bit_weights_on_model_save': True, 'offload_optimizer': {'device': 'nvme'}, 'offload_param': {'device': 'cpu'}}, 'gradient_clipping': 1.0, 'train_batch_size': 'auto', 'train_micro_batch_size_per_gpu': 'auto', 'gradient_accumulation_steps': 5, 'steps_per_print': inf, 'fp16': {'enabled': True, 'auto_cast': True}}Примечание:
- Оставшиеся значения
"auto"обрабатываются в вызовеaccelerator.prepare(), как описано в пункте 2 разделаImportant code changes when using DeepSpeed Config File. - Значение, переданное при создании объекта
AcceleratorчерезAccelerator(gradient_accumulation_steps=k), используется только в том случае, еслиgradient_accumulation_stepsравноauto. При использовании DeepSpeed Plugin значение из него будет использовано и перезапишет значение, переданное при создании объекта Accelerator.
Сохранение и загрузка
Сохранение и загрузка моделей не изменились для ZeRO Stage-1 и Stage-2.
в режиме ZeRO Stage-3
state_dictсодержит только заглушки, поскольку веса модели распределены по нескольким GPU. У ZeRO Stage-3 есть два варианта:a. Сохранение всех весов модели в 16-битном формате для их последующей прямой загрузки с помощью
model.load_state_dict(torch.load(pytorch_model.bin)). Для этого установите значение True дляzero_optimization.stage3_gather_16bit_weights_on_model_saveв файле конфигурации DeepSpeed или установите значение True дляzero3_save_16bit_modelв плагине DeepSpeed. Обратите внимание, что этот параметр требует объединения весов на одном GPU, что может быть медленным и требовать много памяти, поэтому используйте эту функцию только при необходимости. Ниже приведен фрагмент изexamples/by_feature/deepspeed_with_config_support.py, демонстрирующий это:unwrapped_model = accelerator.unwrap_model(model) # New Code # # Saves the whole/unpartitioned fp16 model when in ZeRO Stage-3 to the output directory if # `stage3_gather_16bit_weights_on_model_save` is True in DeepSpeed Config file or # `zero3_save_16bit_model` is True in DeepSpeed Plugin. # For Zero Stages 1 and 2, models are saved as usual in the output directory. # The model name saved is `pytorch_model.bin` unwrapped_model.save_pretrained( args.output_dir, is_main_process=accelerator.is_main_process, save_function=accelerator.save, state_dict=accelerator.get_state_dict(model), )b. Чтобы получить веса 32bit, сначала сохраните модель с помощью
model.save_checkpoint(). Ниже приведен фрагмент изexamples/by_feature/deepspeed_with_config_support.py, демонстрирующий это:success = model.save_checkpoint(PATH, ckpt_id, checkpoint_state_dict) status_msg = f"checkpointing: PATH={PATH}, ckpt_id={ckpt_id}" if success: logging.info(f"Success {status_msg}") else: logging.warning(f"Failure {status_msg}")Это создаст разделы модели и оптимизатора ZeRO, а также скрипт
zero_to_fp32.pyв каталоге контрольной точки. Вы можете использовать этот скрипт для офлайн-консолидации. Он не требует файлов конфигурации или GPU. Вот пример его использования:$ cd /path/to/checkpoint_dir $ ./zero_to_fp32.py . pytorch_model.bin Processing zero checkpoint at global_step1 Detected checkpoint of type zero stage 3, world_size: 2 Saving fp32 state dict to pytorch_model.bin (total_numel=60506624)Чтобы получить 32-битную модель для сохранения/инференса, вы можете выполнить:
from deepspeed.utils.zero_to_fp32 import load_state_dict_from_zero_checkpoint

unwrapped_model = accelerator.unwrap_model(model)
fp32_model = load_state_dict_from_zero_checkpoint(unwrapped_model, checkpoint_dir)
Если вас интересует только
state_dict, выполните следующее:from deepspeed.utils.zero_to_fp32 import get_fp32_state_dict_from_zero_checkpoint state_dict = get_fp32_state_dict_from_zero_checkpoint(checkpoint_dir)Обратите внимание, что все эти функции требуют ~2x объема памяти (оперативной памяти) от размера итогового контрольного пункта.
ZeRO Inference
DeepSpeed ZeRO Inference поддерживает ZeRO stage 3 с ZeRO-Infinity. Он использует тот же протокол ZeRO, что и обучение, но не использует оптимизатор и lr scheduler, а актуален только stage 3. С интеграцией accelerate вам нужно просто подготовить модель и dataloader, как показано ниже:
model, eval_dataloader = accelerator.prepare(model, eval_dataloader)
Несколько важных оговорок
- Текущая интеграция не поддерживает Pipeline Parallelism в DeepSpeed.
- Текущая интеграция не поддерживает
mpu, что ограничивает параллелизм тензоров, доступный в Megatron-LM. - Текущая интеграция не поддерживает несколько моделей.
Multi-node DeepSpeed
DeepSpeed поддерживает многоузловый вывод и обучение с использованием различных загрузчиков. Вы можете указать другой загрузчик, задав параметр deepspeed_multinode_launcher в командной строке или в файле конфигурации DeepSpeed.
В настоящее время accelerate поддерживает передачу конфигурации для следующих многоузловых запускателей DeepSpeed: pdsh (по умолчанию), standard, openmpi, mvapich, mpich, slurm, nossh (требуется DeepSpeed >= 0.14.5).
Для получения дополнительной информации о различных запускателях обратитесь к документации DeepSpeed. По умолчанию DeepSpeed пытается использовать SSH без пароля с основного узла на другие узлы для выполнения команды запуска. В этой конфигурации команду accelerate launch необходимо запускать только на основном узле. Если используется запускатель nossh, команду accelerate launch нужно запускать на каждом узле, используя скопированную конфигурацию.
Ресурсы DeepSpeed
Документация по внутренним компонентам, связанным с DeepSpeed, доступна здесь.
Статьи:
- ZeRO: оптимизация памяти для обучения моделей с триллионом параметров
- ZeRO-Offload: Демократизация обучения моделей масштаба в миллиарды параметров
- ZeRO-Infinity: Преодоление ограничений памяти GPU для глубокого обучения в экстремальных масштабах
- ZeRO++: чрезвычайно эффективная коллективная коммуникация для обучения гигантских моделей
Наконец, помните, что Accelerate лишь интегрирует DeepSpeed, поэтому, если у вас возникнут проблемы или вопросы, связанные с использованием DeepSpeed, пожалуйста, создайте issue в DeepSpeed GitHub.
Update on GitHubДля тех, кто интересуется сходствами и различиями между FSDP и DeepSpeed, ознакомьтесь с концептуальным руководством здесь!