# VideoMAE
## Обзор
Модель VideoMAE была предложена в работе [VideoMAE: Masked Autoencoders are Data-Efficient Learners for Self-Supervised Video Pre-Training](https://huggingface.co/papers/2203.12602) авторами Zhan Tong, Yibing Song, Jue Wang, Limin Wang. VideoMAE расширяет подход маскированных автоэнкодеров ([MAE](vit_mae)) на видео, демонстрируя наилучшие результаты на нескольких бенчмарках классификации видео.
Аннотация из статьи следующая:
*Предобучение видео-трансформеров на сверхбольших наборах данных, как правило, необходимо для достижения первоклассной производительности на относительно небольших наборах данных. В данной статье мы показываем, что видео-маскированные автоэнкодеры (VideoMAE) являются эффективными с точки зрения использования данных обучателями для самообучения видео с предобучением (SSVP). Мы вдохновлены недавним ImageMAE и предлагаем кастомизированное маскирование и восстановление видео-трубок. Оказалось, что эти простые решения эффективны для преодоления утечки информации, вызванной временной корреляцией при восстановлении видео. Мы получаем три важных вывода о SSVP: (1) Экстремально высокая доля маскирования (т. е. 90%–95%) все еще обеспечивает хорошую производительность VideoMAE. Временная избыточность содержимого видео позволяет использовать более высокий коэффициент маскирования, чем для изображений. (2) VideoMAE достигает впечатляющих результатов на очень малых наборах данных (т. е. около 3–4 тыс. видео) без использования каких-либо дополнительных данных. Это частично объясняется сложной задачей восстановления видео, которая заставляет модель обучаться высокоуровневой структуре. (3) VideoMAE показывает, что для SSVP качество данных важнее их количества. Смещение домена между набором данных для предобучения и целевым набором данных является важной проблемой в SSVP. Примечательно, что наш VideoMAE с базовым бэкбоном ViT достигает 83,9% на Kinects-400, 75,3% на Something-Something V2, 90,8% на UCF101 и 61,1% на HMDB51 без использования каких-либо дополнительных данных.*
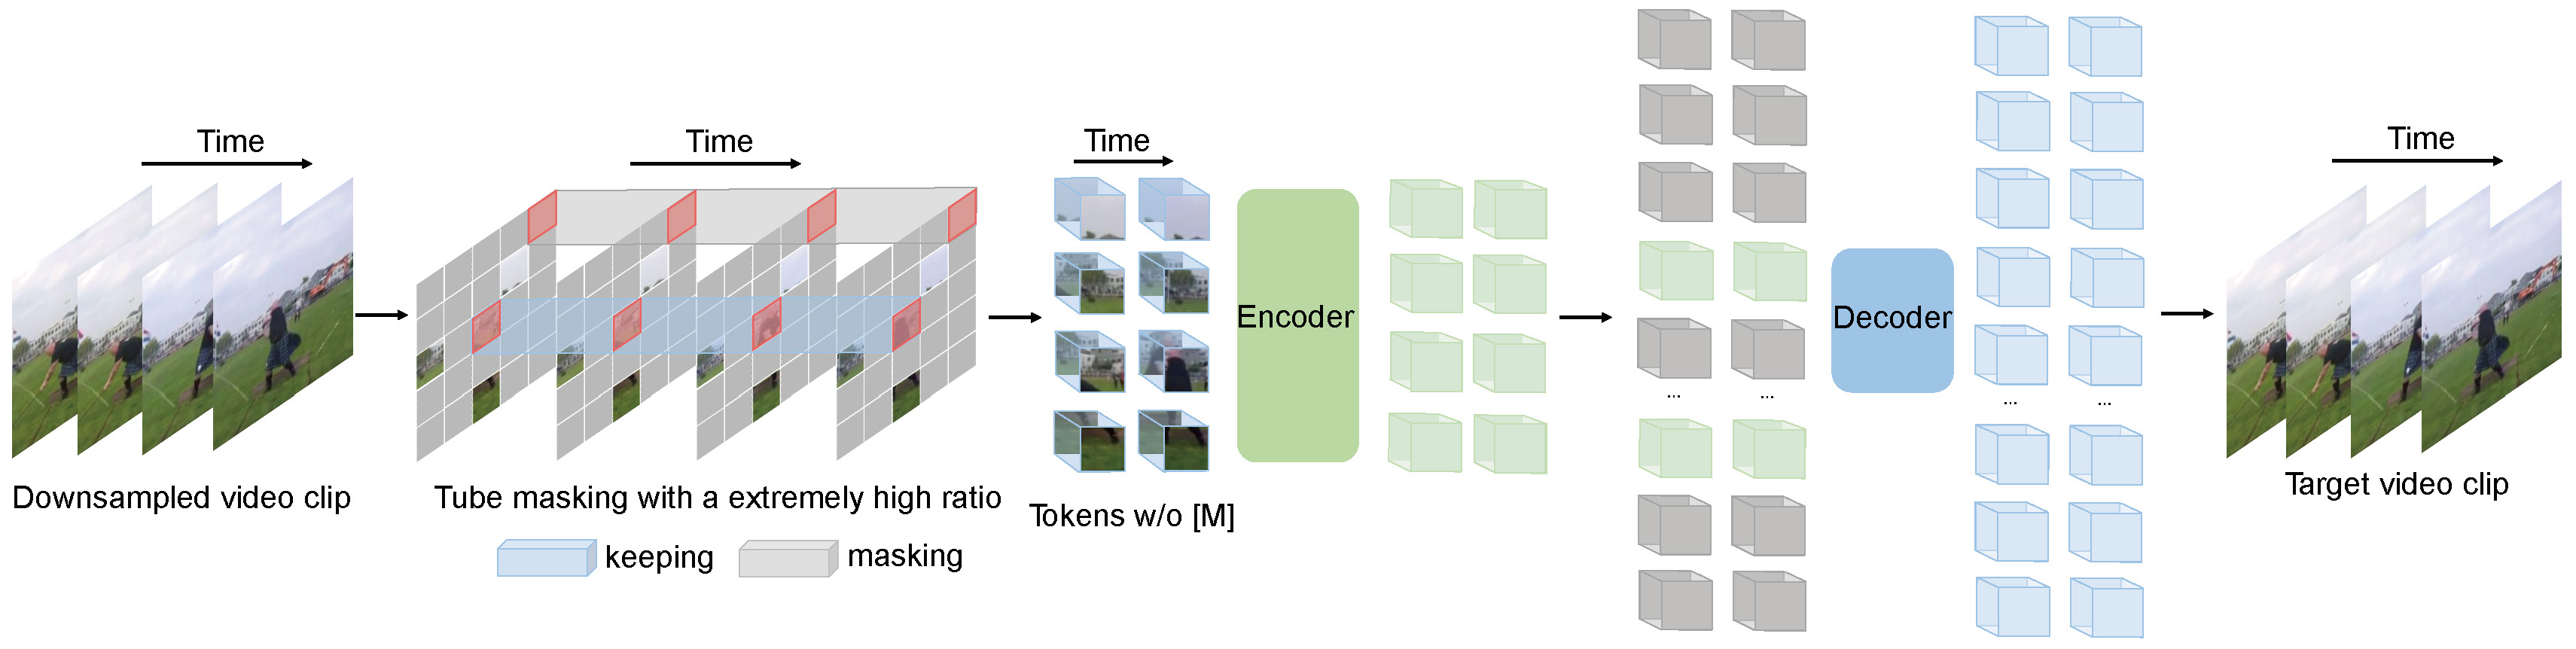 Предобучение VideoMAE. Взято из оригинальной статьи.
Эта модель была предоставлена пользователем [nielsr](https://huggingface.co/nielsr). Исходный код можно найти [здесь](https://github.com/MCG-NJU/VideoMAE).
## Использование масштабированного внимания на основе скалярного произведения (SDPA)
PyTorch включает в себя нативный оператор масштабированного внимания на основе скалярного произведения (SDPA) в составе `torch.nn.functional`. Эта функция объединяет несколько реализаций, которые могут применяться в зависимости от входных данных и используемого оборудования. Подробнее см. в [официальной документации](https://pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention.html) или на странице [GPU Inference](https://huggingface.co/docs/transformers/main/en/perf_infer_gpu_one#pytorch-scaled-dot-product-attention).
SDPA используется по умолчанию для `torch>=2.1.1`, когда доступна соответствующая реализация, но вы также можете установить `attn_implementation="sdpa"` в `from_pretrained()`, чтобы явно запросить использование SDPA.
```python
from transformers import VideoMAEForVideoClassification
model = VideoMAEForVideoClassification.from_pretrained("MCG-NJU/videomae-base-finetuned-kinetics", attn_implementation="sdpa", device_map="auto")
...
```
Для достижения максимального ускорения мы рекомендуем загружать модель в половинной точности (например, `torch.float16` или `torch.bfloat16`).
На локальном бенчмарке (A100-40GB, PyTorch 2.3.0, ОС Ubuntu 22.04) с `float32` и моделью `MCG-NJU/videomae-base-finetuned-kinetics` мы наблюдали следующие ускорения при инференсе.
| Размер пакета | Среднее время вывода (мс), режим eager | Среднее время инференса (мс), модель sdpa | Ускорение, Sdpa / Eager (x) |
|--------------|-------------------------------------------|-------------------------------------------|------------------------------|
| 1 | 37 | 10 | 3.7 |
| 2 | 24 | 18 | 1.33 |
| 4 | 43 | 32 | 1.34 |
| 8 | 84 | 60 | 1.4 |
## Ресурсы
Список официальных ресурсов Hugging Face и сообщества (отмечены 🌎), которые помогут вам начать работу с VideoMAE. Если вы хотите предложить ресурс для включения в этот список, пожалуйста, создайте Pull Request, и мы его рассмотрим! В идеале ресурс должен демонстрировать что-то новое, а не дублировать существующие материалы.
**Классификация видео**
- [Ноутбук](https://github.com/huggingface/notebooks/blob/main/examples/video_classification.ipynb), в котором показано, как
для дообучения модели VideoMAE на собственном наборе данных.
- [Руководство по задаче классификации видео](../tasks/video_classification)
- [🤗 Space](https://huggingface.co/spaces/sayakpaul/video-classification-ucf101-subset), демонстрирующая выполнение инференса с помощью модели классификации видео.
## VideoMAEConfig[[transformers.VideoMAEConfig]]
#### transformers.VideoMAEConfig[[transformers.VideoMAEConfig]]
```python
transformers.VideoMAEConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, num_frames: int = 16, tubelet_size: int = 2, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, qv_bias: bool = True, use_mean_pooling: bool = True, decoder_num_attention_heads: int = 6, decoder_hidden_size: int = 384, decoder_num_hidden_layers: int = 4, decoder_intermediate_size: int = 1536, norm_pix_loss: bool = True)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/videomae/configuration_videomae.py#L24)
**Параметры:**
image_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `224`) : Размер (разрешение) каждого изображения.
patch_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `16`) : Размер (разрешение) каждого патча.
num_channels (`int`, *необязательный*, по умолчанию `3`) : Количество входных каналов.
num_frames (`int`, *необязательный*, по умолчанию 16) : Количество кадров в каждом видео.
tubelet_size (`int`, *необязательный*, по умолчанию 2) : Количество тублетов.
hidden_size (`int`, *optional*, по умолчанию `768`) : Размерность скрытых представлений.
num_hidden_layers (`int`, *необязательный*, по умолчанию `12`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `12`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
intermediate_size (`int`, *optional*, по умолчанию `3072`) : Размерность представлений MLP.
hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
hidden_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Вероятность dropout для всех полносвязных слоёв в эмбеддингах, энкодере и пулере.
attention_probs_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Коэффициент dropout для вероятностей внимания.
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-12`) : Значение epsilon, используемое слоями нормализации.
qv_bias (`bool`, *необязательный*, по умолчанию `True`) : Добавлять ли смещение (bias) к запросам и значениям в слоях само-внимания.
use_mean_pooling (`bool`, *необязательный*, по умолчанию `True`) : Использовать ли усреднение (mean pooling) по финальным скрытым состояниям вместо использования финального скрытого состояния токена [CLS].
decoder_num_attention_heads (`int`, *optional*, по умолчанию 6) : Количество головок внимания для каждого слоя внимания в декодере.
decoder_hidden_size (`int`, *optional*, по умолчанию 384) : Размерность декодера.
decoder_num_hidden_layers (`int`, *необязательный*, по умолчанию 4) : Количество скрытых слоев в декодере.
decoder_intermediate_size (`int`, *optional*, по умолчанию 1536) : Размерность «промежуточного» (т.е. полносвязного) слоя в декодере.
norm_pix_loss (`bool`, *необязательный*, по умолчанию `True`) : Нужно ли нормализовать пиксели целевого патча.
Это класс конфигурации для хранения настроек модели VideoMAEModel. Он используется для создания модели Videomae в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации модели [MCG-NJU/videomae-base](https://huggingface.co/MCG-NJU/videomae-base)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import VideoMAEConfig, VideoMAEModel
>>> # Initializing a VideoMAE videomae-base style configuration
>>> configuration = VideoMAEConfig()
>>> # Randomly initializing a model from the configuration
>>> model = VideoMAEModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## VideoMAEImageProcessor[[transformers.VideoMAEImageProcessor]]
#### transformers.VideoMAEImageProcessor[[transformers.VideoMAEImageProcessor]]
```python
transformers.VideoMAEImageProcessor(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/videomae/image_processing_videomae.py#L35)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 224}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 224, 'width': 224}`): Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `2`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Средние значения изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли выполнять центрированный кроп изображения.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
Создаёт процессор изображений VideoMAEImageProcessor.
#### preprocess[[transformers.VideoMAEImageProcessor.preprocess]]
```python
preprocess(videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/videomae/image_processing_videomae.py#L53)
**Параметры:**
videos (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Видео или батч видео для предобработки. Ожидается одно видео (список кадров) или батч видео (список списков кадров). Каждый кадр может быть изображением PIL, массивом numpy или тензором torch со значениями пикселей в диапазоне от 0 до 255. Если передаются кадры со значениями пикселей от 0 до 1, установите `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
## VideoMAEImageProcessorPil[[transformers.VideoMAEImageProcessorPil]]
#### transformers.VideoMAEImageProcessorPil[[transformers.VideoMAEImageProcessorPil]]
```python
transformers.VideoMAEImageProcessorPil(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/videomae/image_processing_pil_videomae.py#L33)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 224}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 224, 'width': 224}`): Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `2`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Средние значения изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли выполнять центрированный кроп изображения.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
Создаёт процессор изображений VideoMAEImageProcessor.
#### preprocess[[transformers.VideoMAEImageProcessorPil.preprocess]]
```python
preprocess(videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/videomae/image_processing_pil_videomae.py#L51)
**Параметры:**
videos (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Видео или батч видео для предобработки. Ожидается одно видео (список кадров) или батч видео (список списков кадров). Каждый кадр может быть изображением PIL, массивом numpy или тензором torch со значениями пикселей в диапазоне от 0 до 255. Если передаются кадры со значениями пикселей от 0 до 1, установите `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
## VideoMAEVideoProcessor[[transformers.VideoMAEVideoProcessor]]
#### transformers.VideoMAEVideoProcessor[[transformers.VideoMAEVideoProcessor]]
```python
transformers.VideoMAEVideoProcessor(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/videomae/video_processing_videomae.py#L25)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*, по умолчанию `True`) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 224}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `2`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Средние значения изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли выполнять центрированный кроп изображения.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 224, 'width': 224}`): Размер выходного изображения после применения `center_crop`.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
do_sample_frames (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Нужно ли выбирать кадры из видео перед обработкой или обрабатывать всё видео целиком.
video_metadata (`Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None]`, *kwargs*) : Метаданные видео, содержащие информацию о общей длительности, fps и общем количестве кадров. Будут использоваться для выборки кадров из видео или вычисления временных меток. Не передавайте метаданные, если вы не пытаетесь декодировать видео вручную перед обработкой
fps (`Annotated[int | float | None, None]`, *kwargs*) : Целевое количество кадров для выборки в секунду при `do_sample_frames=True`.
num_frames (`Annotated[int | None, None]`, *kwargs*) : Максимальное количество кадров для выборки при `do_sample_frames=True`.
return_metadata (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Нужно ли возвращать метаданные видео. Метаданные видео — это объект, содержащий информацию о длительности видео, частоте кадров, бэкенде декодирования и т. д.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Если задано, возвращает тензоры конкретного фреймворка. Допустимые значения: - `'pt'`: возвращает объекты `torch.Tensor` PyTorch. - `'np'`: возвращает объекты `np.ndarray` NumPy.
- ****kwargs** ([VideosKwargs](/docs/transformers/v5.23.0/ru/main_classes/processors#transformers.VideosKwargs), *optional*) : Дополнительные параметры обработки для каждой модальности (текст, изображения, видео, аудио). Специфичные для модели параметры перечислены выше; полный список поддерживаемых аргументов см. в классе TypedDict.
Создаёт видеопроцессор VideoMAEVideoProcessor.
#### preprocess[[transformers.VideoMAEVideoProcessor.preprocess]]
```python
preprocess(videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]]], **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/videomae/video_processing_videomae.py#L41)
**Параметры:**
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`) : Видео для предобработки. Ожидается одно видео или батч видео со значениями пикселей в диапазоне от 0 до 255. Если передаются видео со значениями пикселей от 0 до 1, установите `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
do_sample_frames (`bool`, *kwargs*, *optional*) : Нужно ли выбирать кадры из видео перед обработкой или обрабатывать всё видео целиком.
video_metadata (`Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None]`, *kwargs*) : Метаданные видео, содержащие информацию о общей длительности, fps и общем количестве кадров. Будут использоваться для выборки кадров из видео или вычисления временных меток. Не передавайте метаданные, если вы не пытаетесь декодировать видео вручную перед обработкой
fps (`Annotated[int | float | None, None]`, *kwargs*) : Целевое количество кадров для выборки в секунду при `do_sample_frames=True`.
num_frames (`Annotated[int | None, None]`, *kwargs*) : Максимальное количество кадров для выборки при `do_sample_frames=True`.
return_metadata (`bool`, *kwargs*, *optional*) : Нужно ли возвращать метаданные видео. Метаданные видео — это объект, содержащий информацию о длительности видео, частоте кадров, бэкенде декодирования и т. д.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
## VideoMAEModel[[transformers.VideoMAEModel]]
#### transformers.VideoMAEModel[[transformers.VideoMAEModel]]
```python
transformers.VideoMAEModel(config: VideoMAEConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/videomae/modeling_videomae.py#L398)
**Параметры:**
config ([VideoMAEConfig](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Videomae, выводящая «сырые» скрытые состояния без какого-либо специализированного слоя на выходе.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.VideoMAEModel.forward]]
```python
forward(pixel_values: Tensor, bool_masked_pos: typing.Optional[torch.BoolTensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/videomae/modeling_videomae.py#L417)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [VideoMAEImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEImageProcessor). Подробности см. в [VideoMAEImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) (`processor_class` использует [VideoMAEImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEImageProcessor) для обработки изображений).
bool_masked_pos (`torch.BoolTensor` формы `(batch_size, sequence_length)`, *необязательный*) : Позиции булевой маски. Указывает, какие патчи замаскированы (1), а какие нет (0). У каждого видео в батче должно быть одинаковое количество замаскированных патчей. Если `None`, то все патчи считаются. Длина последовательности равна `(num_frames // tubelet_size) * (image_size // patch_size) ** 2`.
**Возвращает:** [BaseModelOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutput) или `tuple(torch.Tensor)`
[BaseModelOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutput) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([VideoMAEConfig](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEConfig)) и входных данных.
Метод forward модели [VideoMAEModel](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> import torch
>>> from transformers import VideoMAEVideoProcessor, VideoMAEModel
>>> from huggingface_hub import hf_hub_download
>>> # replace this with your own video file
>>> video_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> video_processor = VideoMAEVideoProcessor.from_pretrained("MCG-NJU/videomae-base")
>>> model = VideoMAEModel.from_pretrained("MCG-NJU/videomae-base")
>>> # prepare video for the model
>>> inputs = video_processor(video_path, return_tensors="pt")
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 1568, 768]
```
## VideoMAEForPreTraining[[transformers.VideoMAEForPreTraining]]
`VideoMAEForPreTraining` включает декодер для самообучения без надзора.
#### transformers.VideoMAEForPreTraining[[transformers.VideoMAEForPreTraining]]
```python
transformers.VideoMAEForPreTraining(config: VideoMAEConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/videomae/modeling_videomae.py#L511)
**Параметры:**
config ([VideoMAEConfig](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Трансформер модели VideoMAE с декодером сверху для предобучения в режиме самоконтроля.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.VideoMAEForPreTraining.forward]]
```python
forward(pixel_values: Tensor, bool_masked_pos: BoolTensor, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/videomae/modeling_videomae.py#L529)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [VideoMAEImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEImageProcessor). Подробности см. в [VideoMAEImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) (`processor_class` использует [VideoMAEImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEImageProcessor) для обработки изображений).
bool_masked_pos (`torch.BoolTensor` формы `(batch_size, sequence_length)`) : Булевы позиции маски. Указывает, какие патчи замаскированы (1), а какие нет (0). Каждое видео в батче должно иметь одинаковое количество замаскированных патчей. Длина последовательности равна `(num_frames // tubelet_size) * (image_size // patch_size) ** 2`.
**Возвращает:** `VideoMAEForPreTrainingOutput` или `tuple(torch.Tensor)`
Объект `VideoMAEForPreTrainingOutput` или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([VideoMAEConfig](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEConfig)) и входных данных.
Метод forward класса [VideoMAEForPreTraining](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEForPreTraining) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`) — Потеря пиксельной реконструкции.
- **logits** (`torch.Tensor` формы `(batch_size, patch_size ** 2 * num_channels)`) -- Логиты реконструкции пикселей.
- **hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from transformers import AutoImageProcessor, VideoMAEForPreTraining
>>> import numpy as np
>>> import torch
>>> num_frames = 16
>>> video = list(np.random.randint(0, 256, (num_frames, 3, 224, 224)))
>>> image_processor = AutoImageProcessor.from_pretrained("MCG-NJU/videomae-base")
>>> model = VideoMAEForPreTraining.from_pretrained("MCG-NJU/videomae-base")
>>> pixel_values = image_processor(video, return_tensors="pt").pixel_values
>>> num_patches_per_frame = (model.config.image_size // model.config.patch_size) ** 2
>>> seq_length = (num_frames // model.config.tubelet_size) * num_patches_per_frame
>>> bool_masked_pos = torch.randint(0, 2, (1, seq_length)).bool()
>>> outputs = model(pixel_values, bool_masked_pos=bool_masked_pos)
>>> loss = outputs.loss
```
## VideoMAEForVideoClassification[[transformers.VideoMAEForVideoClassification]]
#### transformers.VideoMAEForVideoClassification[[transformers.VideoMAEForVideoClassification]]
```python
transformers.VideoMAEForVideoClassification(config: VideoMAEConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/videomae/modeling_videomae.py#L684)
**Параметры:**
config ([VideoMAEConfig](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
VideoMAE Модель-трансформер с головкой для классификации видео (линейный слой поверх усреднённых скрытых состояний всех токенов), например, для ImageNet.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.VideoMAEForVideoClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/videomae/modeling_videomae.py#L698)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [VideoMAEImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEImageProcessor). Подробности см. в [VideoMAEImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) (`processor_class` использует [VideoMAEImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEImageProcessor) для обработки изображений).
labels (`torch.LongTensor` формы `(batch_size,)`, *необязательный*) : Метки для вычисления потерь классификации/регрессии изображений. Индексы должны находиться в диапазоне `[0, ..., config.num_labels - 1]`. Если `config.num_labels == 1`, вычисляется потеря регрессии (среднеквадратичная потеря), если `config.num_labels > 1`, вычисляется потеря классификации (кросс-энтропия).
**Возвращает:** [ImageClassifierOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) или `tuple(torch.Tensor)`
Объект [ImageClassifierOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([VideoMAEConfig](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEConfig)) и входных данных.
Метод forward класса [VideoMAEForVideoClassification](/docs/transformers/v5.23.0/ru/model_doc/videomae#transformers.VideoMAEForVideoClassification) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери классификации (или регрессии, если config.num_labels==1).
- **logits** (`torch.Tensor` формы `(batch_size, config.num_labels)`) — Оценки классификации (или регрессии, если config.num_labels==1) до применения SoftMax.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или при `config.output_hidden_states=True`) — Кортеж из `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет такой слой, + один для вывода каждого этапа) формы `(batch_size, sequence_length, hidden_size)`. Скрытые состояния (также называемые картами признаков) модели на выходе каждого этапа.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается, если передано `output_attentions=True` или если `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, patch_size, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> import torch
>>> from transformers import VideoMAEVideoProcessor, VideoMAEForVideoClassification
>>> from huggingface_hub import hf_hub_download
>>> # replace this with your own video file
>>> video_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> video_processor = VideoMAEVideoProcessor.from_pretrained("MCG-NJU/videomae-base-finetuned-kinetics")
>>> model = VideoMAEForVideoClassification.from_pretrained("MCG-NJU/videomae-base-finetuned-kinetics")
>>> inputs = video_processor(video_path, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**inputs)
... logits = outputs.logits
>>> # model predicts one of the 400 Kinetics-400 classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
eating spaghetti
```