# BLIP-2
## Обзор
Модель BLIP-2 была предложена в работе [BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models](https://huggingface.co/papers/2301.12597) авторами Junnan Li, Dongxu Li, Silvio Savarese, Steven Hoi. BLIP-2 использует замороженные предобученные кодировщики изображений и большие языковые модели (LLM), обучая между ними легкий 12-слойный Transformer-кодировщик, что обеспечивает передовые результаты на различных задачах в области зрения и языка. В частности, BLIP-2 превосходит [Flamingo](https://huggingface.co/papers/2204.14198), модель с 80 миллиардами параметров, на 8,7% в задаче zero-shot VQAv2, имея в 54 раза меньше обучаемых параметров.
Аннотация из статьи следующая:
*Стоимость предобучения моделей, объединяющих зрение и язык, стала всё более неприемлемой из-за сквозного обучения моделей большого масштаба. В данной статье предлагается BLIP-2 — универсальная и эффективная стратегия предобучения, которая использует готовые замороженные предобученные энкодеры изображений и замороженные большие языковые модели для запуска предобучения зрительно-языковых моделей. BLIP-2 преодолевает разрыв между модальностями с помощью легковесного Querying Transformer, который предобучается в два этапа. На первом этапе закладывается фундамент для обучения представлений в области зрения и языка на основе замороженного энкодера изображений. На втором этапе закладывается фундамент для генеративного обучения от зрения к языку на основе замороженной языковой модели. BLIP-2 демонстрирует наилучшие результаты на различных зрительно-языковых задачах, несмотря на значительно меньшее количество обучаемых параметров по сравнению с существующими методами. Например, наша модель превосходит Flamingo80B на 8,7% в задаче zero-shot VQAv2, имея в 54 раза меньше обучаемых параметров. Мы также демонстрируем формирующиеся возможности модели по генерации текста из изображений в режиме zero-shot, способной следовать инструкциям на естественном языке.*
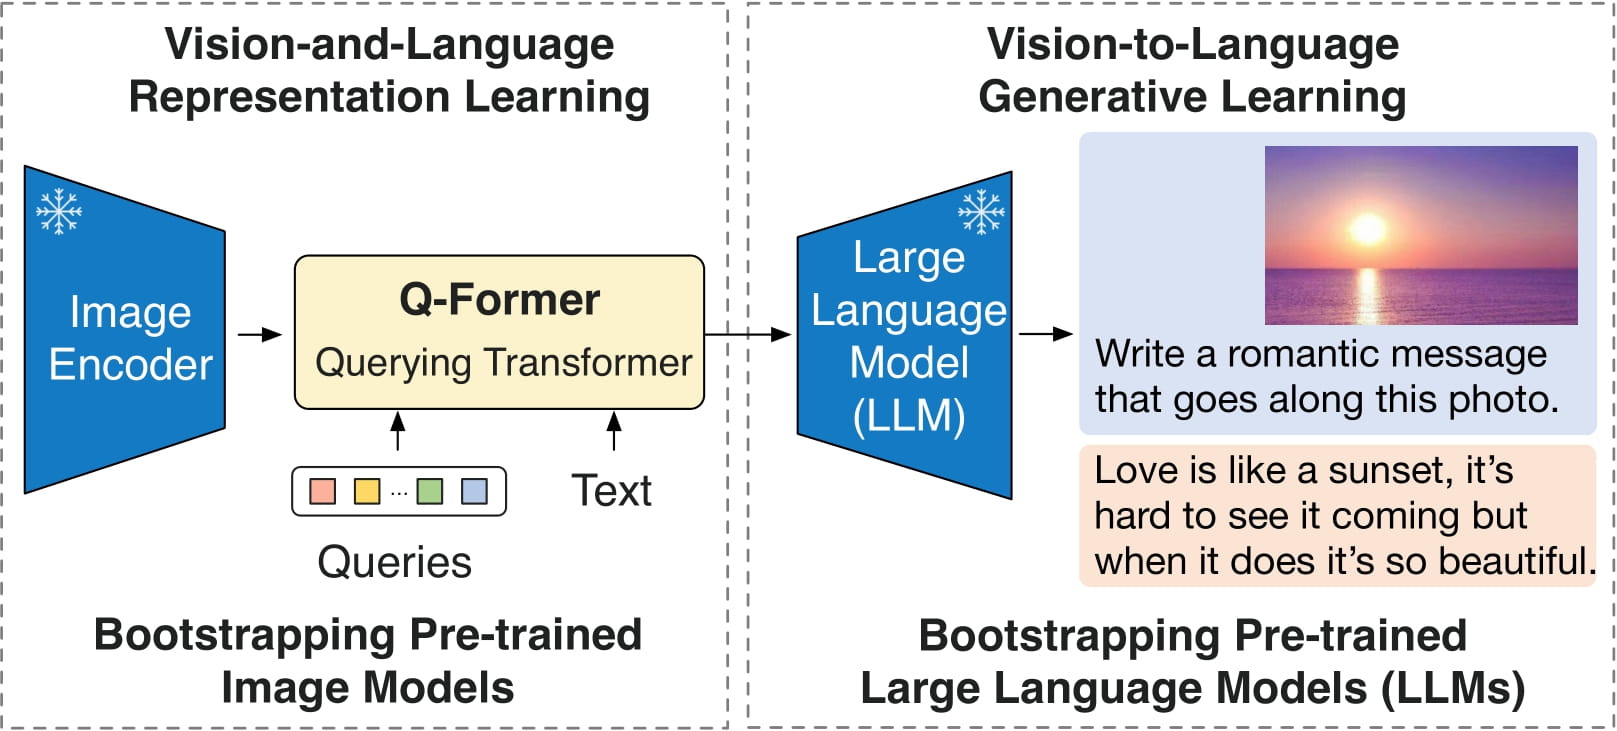 Архитектура BLIP-2. Источник — оригинальная статья.
Эта модель была предоставлена пользователем [nielsr](https://huggingface.co/nielsr). Исходный код можно найти [здесь](https://github.com/salesforce/LAVIS/tree/5ee63d688ba4cebff63acee04adaef2dee9af207).
## Советы по использованию
- BLIP-2 можно использовать для условной генерации текста по изображению и необязательному текстовому запросу. На этапе инференса рекомендуется использовать метод `generate`.
- С помощью [Blip2Processor](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Processor) можно подготовить изображения для модели и декодировать предсказанные идентификаторы токенов обратно в текст.
> [!NOTE]
> Модели BLIP после выпуска v4.46 будут выдавать предупреждения о необходимости добавить `processor.num_query_tokens = {{num_query_tokens}}` и расширить слой эмбеддингов модели для добавления специального токена ``. Если вы являетесь владельцем контрольной точки модели, настоятельно рекомендуется добавить эти атрибуты в процессор; если же модель вам не принадлежит, создайте PR. Добавление этих атрибутов означает, что BLIP будет добавлять количество токенов запроса, необходимых на каждое изображение, и расширять текст таким количеством плейсхолдеров ``, сколько будет токенов запроса. Обычно это около 500 токенов на изображение, поэтому убедитесь, что текст не обрезается, иначе произойдёт сбой при объединении эмбеддингов.
Атрибуты можно получить из конфигурации модели, например `model.config.num_query_tokens`, а расширение эмбеддингов модели выполняется по [этой ссылке](https://gist.github.com/zucchini-nlp/e9f20b054fa322f84ac9311d9ab67042).
## Ресурсы
Список официальных ресурсов Hugging Face и сообщества (отмечены значком 🌎), которые помогут вам начать работу с BLIP-2.
- Демо-ноутбуки для BLIP-2, демонстрирующие генерацию описаний изображений, визуальный вопросно-ответный диалог (VQA) и чат-подобные беседы, можно найти [здесь](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/BLIP-2).
Если вы хотите предложить ресурс для включения в этот раздел, пожалуйста, создайте Pull Request, и мы его рассмотрим! В идеале ресурс должен демонстрировать что-то новое, а не дублировать существующие материалы.
## Blip2Config[[transformers.Blip2Config]]
#### transformers.Blip2Config[[transformers.Blip2Config]]
```python
transformers.Blip2Config(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, qformer_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_query_tokens: int = 32, image_text_hidden_size: int = 256, image_token_index: int | None = None, initializer_factor: float = 1.0, initializer_range: float = 0.02)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/configuration_blip_2.py#L107)
**Параметры:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Объект конфигурации или словарь для визуального бэкбона.
qformer_config (`dict`, *необязательный*) : Словарь параметров конфигурации, используемых для инициализации [Blip2QFormerConfig](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2QFormerConfig).
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Объект конфигурации или словарь текстового бэкбона.
num_query_tokens (`int`, *необязательный*, по умолчанию 32) : Количество токенов запроса, передаваемых через Transformer.
image_text_hidden_size (`int`, *optional*, по умолчанию 256) : Размерность скрытого состояния слоя слияния изображения и текста.
image_token_index (`int`, *optional*) : Индекс токена изображения, используемый как плейсхолдер для входных изображений.
initializer_factor (`float`, *необязательный*, по умолчанию `1.0`) : Коэффициент для инициализации всех матриц весов (должен оставаться равным 1, используется внутренне для тестирования инициализации).
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
Это класс конфигурации для хранения настроек модели Blip 2. Он используется для создания модели Blip 2 в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import (
... Blip2VisionConfig,
... Blip2QFormerConfig,
... OPTConfig,
... Blip2Config,
... Blip2ForConditionalGeneration,
... )
>>> # Initializing a Blip2Config with Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2Config()
>>> # Initializing a Blip2ForConditionalGeneration (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2ForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a Blip2Config from a Blip2VisionConfig, Blip2QFormerConfig and any PreTrainedConfig
>>> # Initializing BLIP-2 vision, BLIP-2 Q-Former and language model configurations
>>> vision_config = Blip2VisionConfig()
>>> qformer_config = Blip2QFormerConfig()
>>> text_config = OPTConfig()
>>> config = Blip2Config(vision_config=vision_config, qformer_config=qformer_config, text_config=text_config)
```
## Blip2VisionConfig[[transformers.Blip2VisionConfig]]
#### transformers.Blip2VisionConfig[[transformers.Blip2VisionConfig]]
```python
transformers.Blip2VisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 1408, intermediate_size: int = 6144, num_hidden_layers: int = 39, num_attention_heads: int = 16, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 14, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/configuration_blip_2.py#L29)
**Параметры:**
hidden_size (`int`, *необязательный*, по умолчанию `1408`) : Размерность скрытых представлений.
intermediate_size (`int`, *optional*, по умолчанию `6144`) : Размерность представлений MLP.
num_hidden_layers (`int`, *необязательный*, по умолчанию `39`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `16`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
image_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `224`) : Размер (разрешение) каждого изображения.
patch_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `14`) : Размер (разрешение) каждого патча.
hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-06`) : Значение epsilon, используемое слоями нормализации.
attention_dropout (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Коэффициент dropout для вероятностей внимания.
initializer_range (`float`, *optional*, по умолчанию `1e-10`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
qkv_bias (`bool`, *необязательный*, по умолчанию `True`) : Добавлять ли смещение (bias) к запросам, ключам и значениям.
Это класс конфигурации для хранения настроек модели Blip 2. Он используется для создания модели Blip 2 в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import Blip2VisionConfig, Blip2VisionModel
>>> # Initializing a Blip2VisionConfig with Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2VisionConfig()
>>> # Initializing a Blip2VisionModel (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2VisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Blip2QFormerConfig[[transformers.Blip2QFormerConfig]]
#### transformers.Blip2QFormerConfig[[transformers.Blip2QFormerConfig]]
```python
transformers.Blip2QFormerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, cross_attention_frequency: int = 2, encoder_hidden_size: int = 1408, use_qformer_text_input: bool = False)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/configuration_blip_2.py#L64)
**Параметры:**
vocab_size (`int`, *необязательный*, по умолчанию `30522`) : Размер словаря модели. Определяет количество различных токенов, которые могут быть представлены в `input_ids`.
hidden_size (`int`, *optional*, по умолчанию `768`) : Размерность скрытых представлений.
num_hidden_layers (`int`, *необязательный*, по умолчанию `12`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `12`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
intermediate_size (`int`, *optional*, по умолчанию `3072`) : Размерность представлений MLP.
hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
hidden_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.1`) : Вероятность dropout для всех полносвязных слоев в эмбеддингах, энкодере и пулере.
attention_probs_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.1`) : Доля dropout для вероятностей внимания.
max_position_embeddings (`int`, *необязательный*, по умолчанию `512`) : Максимальная длина последовательности, с которой может использоваться данная модель.
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-12`) : Значение epsilon, используемое слоями нормализации.
pad_token_id (`int`, *необязательный*, по умолчанию `0`) : Идентификатор токена, используемый для выравнивания в словаре.
cross_attention_frequency (`int`, *optional*, по умолчанию 2) : Частота добавления кросс-внимания в слои Transformer.
encoder_hidden_size (`int`, *необязательный*, по умолчанию `1408`) : Размерность скрытых представлений.
use_qformer_text_input (`bool`, *необязательный*, по умолчанию `False`) : Использовать ли встраивания в стиле BERT.
Это класс конфигурации для хранения настроек модели Blip 2. Он используется для создания модели Blip 2 в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Примеры:
```python
>>> from transformers import Blip2QFormerConfig, Blip2QFormerModel
>>> # Initializing a BLIP-2 Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2QFormerConfig()
>>> # Initializing a model (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2QFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Blip2Processor[[transformers.Blip2Processor]]
#### transformers.Blip2Processor[[transformers.Blip2Processor]]
```python
transformers.Blip2Processor(image_processor, tokenizer, num_query_tokens = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/processing_blip_2.py#L30)
**Параметры:**
image_processor (`BlipImageProcessor`) : процессор изображений является обязательным входным параметром.
tokenizer (`GPT2Tokenizer`) : Токенизатор является обязательным входным параметром.
num_query_tokens (`int`, *optional*) : Количество токенов, используемых Qformer в качестве запросов; должно совпадать со значением в конфигурации модели.
Создаёт Blip2Processor, объединяющий image processor и tokenizer в единый процессор.
[Blip2Processor](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Processor) предоставляет все возможности [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor) и [GPT2Tokenizer](/docs/transformers/v5.23.0/ru/model_doc/gpt2#transformers.GPT2Tokenizer). Подробнее см. в документации [~BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor) и [~GPT2Tokenizer](/docs/transformers/v5.23.0/ru/model_doc/gpt2#transformers.GPT2Tokenizer).
#### __call__[[transformers.Blip2Processor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/processing_blip_2.py#L50)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *необязательный*) : Изображение для предварительной обработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
text (`Union[str, list[str]]`, *необязательный*) : Последовательность или батч последовательностей для кодирования. Каждая последовательность может быть строкой или списком строк (предтокенизированная строка). Если вы передаете предтокенизированный вход, установите `is_split_into_words=True`, чтобы избежать неоднозначности с батчированными входами.
return_mm_token_type_ids (`bool`, *kwargs*) : Нужно ли возвращать идентификаторы типов мультимодальных токенов, указывающие на позиции мультимодальных плейсхолдер-токенов.
return_text_replacement_offsets (`bool`, *kwargs*) : Нужно ли возвращать смещения символов для каждого мультимодального плейсхолдера и его замены.
return_tensors (`str` или [TensorType](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.TensorType), *optional*) : Если задано, возвращает тензоры конкретного фреймворка. Допустимые значения: - `'pt'`: возвращает объекты `torch.Tensor` PyTorch. - `'np'`: возвращает объекты `np.ndarray` NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/ru/main_classes/processors#transformers.ProcessingKwargs), *optional*) : Дополнительные параметры обработки для каждой модальности (текст, изображения, видео, аудио). Специфичные для модели параметры перечислены выше; полный список поддерживаемых аргументов см. в классе TypedDict.
**Возвращает:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *необязательный*) -- Словарь списков/массивов/тензоров, возвращаемый методами `__call__`/`encode_plus`/`batch_encode_plus` ('input_ids', 'attention_mask' и т. д.).
- **encoding** (`tokenizers.Encoding` или `Sequence[tokenizers.Encoding]`, *необязательный*) -- Если токенизатор является быстрым токенизатором, который выводит дополнительную информацию, например, отображение из пространства слов/символов в пространство токенов, то экземпляр `tokenizers.Encoding` или список экземпляров (для батчей) содержит эту информацию.
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
- **prepend_batch_axis** (`bool`, *необязательный*, по умолчанию `False`) — добавлять ли ось батча при преобразовании в тензоры (см. `tensor_type` выше). Обратите внимание, что этот параметр имеет значение, если параметр `tensor_type` задан, *иначе не влияет на результат*.
- **n_sequences** (`int`, *необязательный*) -- Количество входных последовательностей, представленных каждым кодированием (`None` для неизвестного значения, `1` для одной последовательности и `2` для пары последовательностей).
## Blip2VisionModel[[transformers.Blip2VisionModel]]
#### transformers.Blip2VisionModel[[transformers.Blip2VisionModel]]
```python
transformers.Blip2VisionModel(config: Blip2VisionConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L481)
**Параметры:**
config ([Blip2VisionConfig](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2VisionConfig)) : класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Blip 2 без дополнительных слоёв, выводящая необработанные скрытые состояния.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.Blip2VisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L501)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor). Подробности см. в [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([Blip2Processor](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Processor) использует [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor) для обработки изображений).
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) и входных данных.
Метод forward модели [Blip2VisionModel](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2VisionModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
## Blip2QFormerModel[[transformers.Blip2QFormerModel]]
#### transformers.Blip2QFormerModel[[transformers.Blip2QFormerModel]]
```python
transformers.Blip2QFormerModel(config: Blip2QFormerConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L848)
**Параметры:**
config ([Blip2QFormerConfig](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2QFormerConfig)) : класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
BLIP-2 Querying Transformer (Q-Former).
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.Blip2QFormerModel.forward]]
```python
forward(query_embeds: Tensor, query_length: int | None = None, attention_mask: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L885)
**Параметры:**
query_embeds (`torch.Tensor` с формой `(batch_size, sequence_length, hidden_size)`) : Скрытые состояния, используемые в вычислениях внимания. При кросс-внимании используются для запроса (т. е. для ключа и значения будут использоваться encoder_hidden_states).
query_length (`int`, *optional*) : Длина запроса, как правило, основанная на количестве токенов запроса. Если значение не указано, query_length будет определена по query_embeds.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
encoder_hidden_states (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) : Последовательность скрытых состояний на выходе последнего слоя кодировщика. Используется в кросс-внимании, если модель настроена как декодер.
encoder_attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отступов во входных данных кодировщика. Эта маска используется в кросс-внимании, если модель настроена как декодер. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**.
**Возвращает:** [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) и входных данных.
Метод forward модели [Blip2QFormerModel](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2QFormerModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **cross_attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается, если передано `output_attentions=True` и `config.add_cross_attention=True` или если `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания кросс-внимания декодера, после применения softmax к вниманию, используемые для вычисления взвешенного среднего в головах кросс-внимания.
- **past_key_values** (`Cache`, *необязательный*, возвращается при передаче `use_cache=True` или когда `config.use_cache=True`) -- это экземпляр [Cache](/docs/transformers/v5.23.0/ru/internal/generation_utils#transformers.Cache). Подробнее см. в нашем [руководстве по кэшированию kv](https://huggingface.co/docs/transformers/en/kv_cache).
Содержит предварительно вычисленные скрытые состояния (ключи и значения в блоках само-внимания и, при необходимости, если `config.is_encoder_decoder=True`, в блоках кросс-внимания), которые можно использовать (см. входной параметр `past_key_values`) для ускорения последовательного декодирования.
## Blip2Model[[transformers.Blip2Model]]
#### transformers.Blip2Model[[transformers.Blip2Model]]
```python
transformers.Blip2Model(config: Blip2Config)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L957)
**Параметры:**
config ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) : класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель BLIP-2 для генерации текстовых и изображенийных признаков. Модель состоит из визуального энкодера, Querying Transformer (Q-Former) и языковой модели.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.Blip2Model.forward]]
```python
forward(pixel_values: Tensor, input_ids: Tensor, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1152)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor). Подробности см. в [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([Blip2Processor](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Processor) использует [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor) для обработки изображений).
input_ids (`torch.Tensor` формы `(batch_size, sequence_length)`) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
attention_mask (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` формы `(batch_size, target_sequence_length)`, *необязательный*) : Индексы токенов входной последовательности декодера в словаре. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные ID декодера?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor` формы `(batch_size, target_sequence_length)`, *необязательный*) : Поведение по умолчанию: генерировать тензор, игнорирующий токены заполнения в `decoder_input_ids`. По умолчанию также будет использоваться каузальная маска. Актуально только в случае использования языковой модели с архитектурой «кодек-декодер» (например, T5).
labels (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Метки для вычисления потерь маскированного языкового моделирования. Индексы должны находиться в диапазоне `[0, ..., config.vocab_size]` или равняться -100 (см. docstring `input_ids`). Токены с индексами, установленными в `-100`, игнорируются (маскируются); потери вычисляются только для токенов с метками в диапазоне `[0, ..., config.vocab_size]`.
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** `Blip2ForConditionalGenerationModelOutput` или `tuple(torch.Tensor)`
Модель `Blip2ForConditionalGenerationModelOutput` или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) и входных данных.
Метод forward модели [Blip2Model](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Model) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor`, *optional*, возвращается, если задан `labels`, `torch.Tensor` формы `(1,)`) -- Потери языковой модели, полученные от языковой модели.
- **logits** (`torch.Tensor` формы `(batch_size, sequence_length, config.vocab_size)`) — Оценки предсказаний языковой модели, вычисленные головным слоем моделирования языка.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выходы визуального кодировщика.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *необязательный*) -- Выходы Q-Former (Querying Transformer).
- **language_model_outputs** (`CausalLMOutputWithPast` или `Seq2SeqLMOutput`) -- Выходные данные языковой модели.
Примеры:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import Blip2Processor, Blip2Model
>>> import torch
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b", dtype=torch.float16)
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> prompt = "Question: how many cats are there? Answer:"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device, torch.float16)
>>> outputs = model(**inputs)
```
#### get_text_features[[transformers.Blip2Model.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, decoder_input_ids: typing.Optional[torch.Tensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L994)
**Параметры:**
input_ids (`torch.Tensor` формы `(batch_size, sequence_length)`) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` формы `(batch_size, target_sequence_length)`, *необязательно*) : Индексы токенов входной последовательности декодера в словаре. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы декодера?](../glossary#decoder-input-ids) T5 использует `pad_token_id` в качестве начального токена для генерации `decoder_input_ids`. Если используется `past_key_values`, необязательно вводить только последние `decoder_input_ids` (см. `past_key_values`). Чтобы узнать больше о подготовке `decoder_input_ids` для предварительного обучения, ознакомьтесь с [Обучение T5](./t5#training).
decoder_attention_mask (`torch.BoolTensor` формы `(batch_size, target_sequence_length)`, *необязательный*) : Поведение по умолчанию: генерировать тензор, игнорирующий токены заполнения в `decoder_input_ids`. Маска причинности также будет использоваться по умолчанию.
labels (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Метки для вычисления потерь маскированного языкового моделирования. Индексы должны находиться в диапазоне `[0, ..., config.vocab_size]` или равняться -100 (см. docstring `input_ids`). Токены с индексами, установленными в `-100`, игнорируются (маскируются); потери вычисляются только для токенов с метками в диапазоне `[0, ..., config.vocab_size]`.
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) и входных данных.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> import torch
>>> from transformers import AutoTokenizer, Blip2Model
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> tokenizer = AutoTokenizer.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> inputs = tokenizer(["a photo of a cat"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.Blip2Model.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1056)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor). Подробности см. в [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([Blip2Processor](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Processor) использует [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor) для обработки изображений).
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) и входных данных.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2Model
>>> from transformers.image_utils import load_image
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_outputs = model.get_image_features(**inputs)
```
#### get_qformer_features[[transformers.Blip2Model.get_qformer_features]]
```python
get_qformer_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1087)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor). Подробности см. в [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([Blip2Processor](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Processor) использует [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor) для обработки изображений).
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** qformer_outputs (`torch.Tensor`)
Скрытые состояния последнего слоя модели Q-Former.
Примеры:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2Model
>>> from transformers.image_utils import load_image
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... qformer_outputs = model.get_qformer_features(**inputs)
```
## Blip2ForConditionalGeneration[[transformers.Blip2ForConditionalGeneration]]
#### transformers.Blip2ForConditionalGeneration[[transformers.Blip2ForConditionalGeneration]]
```python
transformers.Blip2ForConditionalGeneration(config: Blip2Config)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1460)
**Параметры:**
config ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) : класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель BLIP-2 для генерации текста по изображению и необязательному текстовому запросу. Модель состоит из визуального энкодера, Querying Transformer (Q-Former) и языковой модели.
Необязательно передать модели `input_ids`, которые служат текстовым промптом, чтобы языковая модель продолжила промпт. В противном случае языковая модель начинает генерировать текст с токена [BOS] (начало последовательности).
Обратите внимание, что чекпоинты Flan-T5 нельзя преобразовать в float16. Они были предварительно обучены с использованием bfloat16.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.Blip2ForConditionalGeneration.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1587)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor). Подробности см. в [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([Blip2Processor](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Processor) использует [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor) для обработки изображений).
input_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы токенов входной последовательности в словаре языковой модели. Входные токены можно необязательно предоставить в качестве текстового промпта, который языковая модель может продолжить. Индексы можно получить с помощью [Blip2Processor](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Processor). Подробности см. в [Blip2Processor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Processor.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
attention_mask (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` формы `(batch_size, target_sequence_length)`, *необязательный*) : Индексы токенов входной последовательности декодера в словаре. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные ID декодера?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor` формы `(batch_size, target_sequence_length)`, *необязательный*) : Поведение по умолчанию: генерировать тензор, игнорирующий токены заполнения в `decoder_input_ids`. По умолчанию также будет использоваться каузальная маска. Актуально только в случае использования языковой модели с архитектурой «кодек-декодер» (например, T5).
inputs_embeds (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательно*) : По желанию, вместо передачи `input_ids` можно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексы `input_ids` преобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели.
labels (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Метки для вычисления потерь маскированного языкового моделирования. Индексы должны находиться в диапазоне `[0, ..., config.vocab_size]` или равняться -100 (см. docstring `input_ids`). Токены с индексами, установленными в `-100`, игнорируются (маскируются); потери вычисляются только для токенов с метками в диапазоне `[0, ..., config.vocab_size]`.
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *необязательный*) : Словарь, где ключами являются поддерживаемые модальности, а значениями — закодированные выходные данные для данной модальности. Каждый закодированный выход представляет собой кортеж, состоящий из (`pooler_output`, *необязательный*: `last_hidden_states`, *необязательный*: `hidden_states`, *необязательный*: `attentions`) `pooler_output` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) — это последовательность мультимодальных признаков энкодера, объединенных в текстовые эмбеддинги.
**Возвращает:** `Blip2ForConditionalGenerationModelOutput` или `tuple(torch.Tensor)`
Модель `Blip2ForConditionalGenerationModelOutput` или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) и входных данных.
Метод forward класса [Blip2ForConditionalGeneration](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2ForConditionalGeneration) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor`, *optional*, возвращается, если задан `labels`, `torch.Tensor` формы `(1,)`) -- Потери языковой модели, полученные от языковой модели.
- **logits** (`torch.Tensor` формы `(batch_size, sequence_length, config.vocab_size)`) — Оценки предсказаний языковой модели, вычисленные головным слоем моделирования языка.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выходы визуального кодировщика.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *необязательный*) -- Выходы Q-Former (Querying Transformer).
- **language_model_outputs** (`CausalLMOutputWithPast` или `Seq2SeqLMOutput`) -- Выходные данные языковой модели.
Примеры:
Подготовка процессора, модели и входных изображений
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import Blip2Processor, Blip2ForConditionalGeneration
>>> import torch
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2ForConditionalGeneration.from_pretrained(
... "Salesforce/blip2-opt-2.7b", load_in_8bit=True, device_map={"": 0}, dtype=torch.float16
... ) # doctest: +IGNORE_RESULT
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
```
Создание подписей к изображениям (без предоставления текстового запроса):
```python
>>> inputs = processor(images=image, return_tensors="pt").to(device, torch.float16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two cats laying on a couch
```
Визуальный вопрос-ответ (prompt = question):
```python
>>> prompt = "Question: how many cats are there? Answer:"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device="cuda", dtype=torch.float16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two
```
Обратите внимание, что int8-вывод также поддерживается через [bitsandbytes](https://github.com/TimDettmers/bitsandbytes). Это значительно снижает объём памяти, используемой моделью, при сохранении того же уровня производительности.
```python
>>> model = Blip2ForConditionalGeneration.from_pretrained(
... "Salesforce/blip2-opt-2.7b", load_in_8bit=True, device_map={"": 0}, dtype=torch.bfloat16
... ) # doctest: +IGNORE_RESULT
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device="cuda", dtype=torch.bfloat16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two
```
#### generate[[transformers.Blip2ForConditionalGeneration.generate]]
```python
generate(pixel_values: Tensor, input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **generate_kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1738)
**Параметры:**
pixel_values (`torch.Tensor` формы (batch_size, num_channels, height, width)) : Входные изображения для обработки.
input_ids (`torch.LongTensor` формы (batch_size, sequence_length), *необязательный*) : Последовательность, используемая в качестве промпта для генерации.
attention_mask (`torch.LongTensor` формы (batch_size, sequence_length), *необязательный*) : Маска для исключения токенов-заполнителей из внимания
inputs_embeds (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) : Встроенное представление входных данных. Должно быть float, а не int-токены.
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли позиционное кодирование эмбеддингов изображений.
**Возвращает:** `captions (list)`
Список строк длины batch_size * num_captions.
Переопределяет функцию `generate`, чтобы использовать модель в качестве условного генератора.
#### get_image_features[[transformers.Blip2ForConditionalGeneration.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1519)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : тензоры, соответствующие входным изображениям.
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** `BaseModelOutputWithVisionQformerOutputs` или `tuple(torch.Tensor)`
Объект `BaseModelOutputWithVisionQformerOutputs` или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) и входных данных.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выходы визуального кодировщика.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *необязательный*) -- Выходы Q-Former (Querying Transformer).
Пример:
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, Blip2ForConditionalGeneration
>>> model = Blip2ForConditionalGeneration.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```
## Blip2ForImageTextRetrieval[[transformers.Blip2ForImageTextRetrieval]]
#### transformers.Blip2ForImageTextRetrieval[[transformers.Blip2ForImageTextRetrieval]]
```python
transformers.Blip2ForImageTextRetrieval(config: Blip2Config)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1832)
**Параметры:**
config ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) : класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель BLIP-2 с проекторами для изображений и текста, а также классификационным слоем наверху. Модель используется в контексте поиска по парам «изображение-текст». По заданному изображению и тексту модель возвращает вероятность того, что текст релевантен изображению.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.Blip2ForImageTextRetrieval.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, attention_mask: typing.Optional[torch.LongTensor] = None, use_image_text_matching_head: bool | None = False, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1866)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor). Подробности см. в [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([Blip2Processor](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Processor) использует [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor) для обработки изображений).
input_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы токенов входной последовательности в словаре языковой модели. Входные токены можно необязательно предоставить в качестве текстового промпта, который языковая модель может продолжить. Индексы можно получить с помощью [Blip2Processor](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Processor). Подробности см. в [Blip2Processor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Processor.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
attention_mask (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
use_image_text_matching_head (`bool`, *необязательный*) : Нужно ли возвращать оценки соответствия изображения и текста или контрастивные оценки.
output_attentions (`bool`, *необязательный*) : Нужно ли возвращать тензоры внимания всех слоев внимания. Подробнее см. `attentions` в разделе возвращаемых тензоров.
output_hidden_states (`bool`, *необязательный*) : Нужно ли возвращать скрытые состояния всех слоёв. Подробнее о `hidden_states` в разделе возвращаемых тензоров.
return_dict (`bool`, *необязательный*) : Нужно ли возвращать [ModelOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.utils.ModelOutput) вместо обычного кортежа.
**Возвращает:** `Blip2ImageTextMatchingModelOutput` или `tuple(torch.Tensor)`
`Blip2ImageTextMatchingModelOutput` или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) и входных данных.
Метод forward класса [Blip2ForImageTextRetrieval](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2ForImageTextRetrieval) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если `return_loss` равно `True`) -- Контрастивная функция потерь для сходства изображения и текста.
- **logits_per_image** (`torch.Tensor` формы `(image_batch_size, text_batch_size)`) -- Оценки масштабированного скалярного произведения между `image_embeds` и `text_embeds`. Это представляет собой оценки сходства между изображением и текстом.
- **logits_per_text** (`torch.Tensor` формы `(text_batch_size, image_batch_size)`) -- Оценки масштабированного скалярного произведения между `text_embeds` и `image_embeds`. Это представляет собой оценки сходства между текстом и изображением.
- **text_embeds** (`torch.Tensor` формы `(batch_size, output_dim`) -- Векторы текста, полученные применением слоя проекции к агрегированному выходу.
- **image_embeds** (`torch.Tensor` формы `(batch_size, output_dim`) -- Векторы изображений, полученные применением слоя проекции к агрегированному выходу.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выход модели [Blip2QFormerModel](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2QFormerModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выход [Blip2VisionModel](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2VisionModel).
Примеры:
```python
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, Blip2ForImageTextRetrieval
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> model = Blip2ForImageTextRetrieval.from_pretrained("Salesforce/blip2-itm-vit-g", dtype=torch.float16)
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "two cats laying on a pink blanket"
>>> inputs = processor(images=image, text=text, return_tensors="pt").to(device, torch.float16)
>>> itm_out = model(**inputs, use_image_text_matching_head=True)
>>> logits_per_image = torch.nn.functional.softmax(itm_out.logits_per_image, dim=1)
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(f"{probs[0][0]:.1%} that image 0 is not '{text}'")
26.9% that image 0 is not 'two cats laying on a pink blanket'
>>> print(f"{probs[0][1]:.1%} that image 0 is '{text}'")
73.0% that image 0 is 'two cats laying on a pink blanket'
>>> texts = ["a photo of a cat", "a photo of a dog"]
>>> inputs = processor(images=image, text=texts, return_tensors="pt").to(device, torch.float16)
>>> itc_out = model(**inputs, use_image_text_matching_head=False)
>>> logits_per_image = itc_out.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(f"{probs[0][0]:.1%} that image 0 is '{texts[0]}'")
55.3% that image 0 is 'a photo of a cat'
>>> print(f"{probs[0][1]:.1%} that image 0 is '{texts[1]}'")
44.7% that image 0 is 'a photo of a dog'
```
## Blip2TextModelWithProjection[[transformers.Blip2TextModelWithProjection]]
#### transformers.Blip2TextModelWithProjection[[transformers.Blip2TextModelWithProjection]]
```python
transformers.Blip2TextModelWithProjection(config: Blip2Config)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1274)
**Параметры:**
config ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) : класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Blip 2 с проекционным слоем сверху (линейный слой поверх пуллинг-вывода).
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.Blip2TextModelWithProjection.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1298)
**Параметры:**
input_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
position_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона `[0, config.n_positions - 1]`. [Что такое идентификаторы позиций?](../glossary#position-ids)
**Возвращает:** `Blip2TextModelOutput` или `tuple(torch.Tensor)`
`Blip2TextModelOutput` или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) и входных данных.
Метод forward модели [Blip2TextModelWithProjection](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2TextModelWithProjection) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **text_embeds** (`torch.Tensor` формы `(batch_size, output_dim)` *необязательный*, возвращается, если модель инициализирована с `with_projection=True`) -- Текстовые эмбеддинги, полученные применением слоя проекции к pooler_output.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor, ...]`, *необязательный*, возвращается, если передано `output_attentions=True` или если `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2TextModelWithProjection
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> model = Blip2TextModelWithProjection.from_pretrained(
... "Salesforce/blip2-itm-vit-g", dtype=torch.float16
... )
>>> model.to(device)
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> inputs = processor(text=["a photo of a cat", "a photo of a dog"], return_tensors="pt").to(device)
>>> outputs = model(**inputs)
>>> text_embeds = outputs.text_embeds
>>> print(text_embeds.shape)
torch.Size([2, 7, 256])
```
## Blip2VisionModelWithProjection[[transformers.Blip2VisionModelWithProjection]]
#### transformers.Blip2VisionModelWithProjection[[transformers.Blip2VisionModelWithProjection]]
```python
transformers.Blip2VisionModelWithProjection(config: Blip2Config)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1359)
**Параметры:**
config ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) : класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Blip 2 с проекционным слоем сверху (линейный слой поверх пуллинг-вывода).
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.Blip2VisionModelWithProjection.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1382)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor). Подробности см. в [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([Blip2Processor](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Processor) использует [BlipImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/blip#transformers.BlipImageProcessor) для обработки изображений).
**Возвращает:** `Blip2VisionModelOutput` или `tuple(torch.Tensor)`
`Blip2VisionModelOutput` или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([Blip2Config](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2Config)) и входных данных.
Метод forward модели [Blip2VisionModelWithProjection](/docs/transformers/v5.23.0/ru/model_doc/blip-2#transformers.Blip2VisionModelWithProjection) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **image_embeds** (`torch.Tensor` формы `(batch_size, output_dim)` *необязательный*, возвращается при инициализации модели с `with_projection=True`) -- Векторы изображений, полученные применением слоя проекции к pooler_output.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor, ...]`, *необязательный*, возвращается, если передано `output_attentions=True` или если `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2VisionModelWithProjection
>>> from transformers.image_utils import load_image
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> model = Blip2VisionModelWithProjection.from_pretrained(
... "Salesforce/blip2-itm-vit-g", dtype=torch.float16
... )
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt").to(device, torch.float16)
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> image_embeds = outputs.image_embeds
>>> print(image_embeds.shape)
torch.Size([1, 32, 256])
```