# Nougat
## Ikhtisar
Model Nougat diusulkan dalam [Nougat: Neural Optical Understanding for Academic Documents](https://huggingface.co/papers/2308.13418) oleh Lukas Blecher, Guillem Cucurull, Thomas Scialom, Robert Stojnic. Nougat menggunakan arsitektur yang sama dengan [Donut](donut), yaitu encoder Transformer untuk gambar dan decoder Transformer teks autoregresif untuk menerjemahkan PDF ilmiah ke markdown, sehingga memudahkan akses ke dokumen tersebut.
Abstrak dari makalah tersebut adalah sebagai berikut:
*Pengetahuan ilmiah sebagian besar disimpan dalam buku dan jurnal ilmiah, sering kali dalam bentuk PDF. Namun, format PDF menyebabkan hilangnya informasi semantik, terutama untuk ekspresi matematika. Kami mengusulkan Nougat (Neural Optical Understanding for Academic Documents), sebuah model Visual Transformer yang menjalankan tugas Optical Character Recognition (OCR) untuk memproses dokumen ilmiah menjadi bahasa markup, dan mendemonstrasikan efektivitas model kami pada dataset baru dokumen ilmiah. Pendekatan yang diusulkan menawarkan solusi menjanjikan untuk meningkatkan aksesibilitas pengetahuan ilmiah di era digital, dengan menjembatani kesenjangan antara dokumen yang dapat dibaca manusia dan teks yang dapat dibaca mesin. Kami merilis model dan kode untuk mempercepat pekerjaan masa depan dalam pengenalan teks ilmiah.*
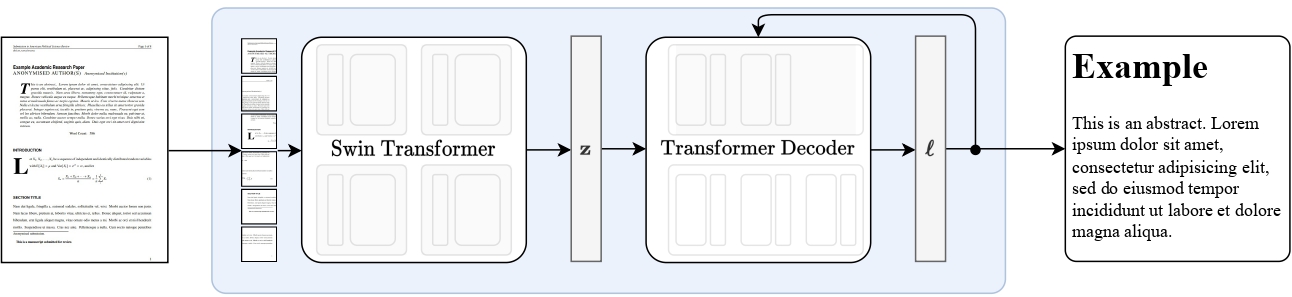 Gambaran tingkat tinggi Nougat. Diambil dari paper aslinya.
Model ini disumbangkan oleh [nielsr](https://huggingface.co/nielsr). Kode aslinya dapat ditemukan [di sini](https://github.com/facebookresearch/nougat).
## Tips penggunaan
- Cara tercepat untuk memulai dengan Nougat adalah dengan memeriksa [notebook tutorial](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Nougat), yang menunjukkan cara menggunakan model pada saat inferensi serta fine-tuning pada data kustom.
- Nougat selalu digunakan dalam kerangka [VisionEncoderDecoder](vision-encoder-decoder). Model ini identik dengan [Donut](donut) dalam hal arsitektur.
## Inferensi
Model `VisionEncoderDecoder` Nougat menerima gambar sebagai input dan memanfaatkan [generate()](/docs/transformers/v5.23.0/id/main_classes/text_generation#transformers.GenerationMixin.generate) untuk menghasilkan teks secara autoregresif berdasarkan gambar input tersebut.
Kelas [NougatImageProcessor](/docs/transformers/v5.23.0/id/model_doc/nougat#transformers.NougatImageProcessor) bertanggung jawab untuk prapemrosesan gambar input, dan [NougatTokenizerFast](/docs/transformers/v5.23.0/id/model_doc/nougat#transformers.NougatTokenizer) mendekode token target yang dihasilkan menjadi string target. Kelas [NougatProcessor](/docs/transformers/v5.23.0/id/model_doc/nougat#transformers.NougatProcessor) membungkus kelas [NougatImageProcessor](/docs/transformers/v5.23.0/id/model_doc/nougat#transformers.NougatImageProcessor) dan [NougatTokenizerFast](/docs/transformers/v5.23.0/id/model_doc/nougat#transformers.NougatTokenizer) menjadi satu instance untuk mengekstrak fitur input dan mendekode id token prediksi.
- Transkripsi PDF langkah demi langkah
```python
from huggingface_hub import hf_hub_download
from PIL import Image
from transformers import AutoModelForImageTextToText, NougatProcessor
processor = NougatProcessor.from_pretrained("facebook/nougat-base")
model = AutoModelForImageTextToText.from_pretrained("facebook/nougat-base", device_map="auto")
model.to(model.device) # doctest: +IGNORE_RESULT
# prepare PDF image for the model
filepath = hf_hub_download(repo_id="hf-internal-testing/fixtures_docvqa", filename="nougat_paper.png", repo_type="dataset")
image = Image.open(filepath)
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
# generate transcription (here we only generate 30 tokens)
outputs = model.generate(
pixel_values.to(model.device),
min_length=1,
max_new_tokens=30,
bad_words_ids=[[processor.tokenizer.unk_token_id]],
)
sequence = processor.batch_decode(outputs, skip_special_tokens=True)[0]
sequence = processor.post_process_generation(sequence, fix_markdown=False)
# note: we're using repr here such for the sake of printing the \n characters, feel free to just print the sequence
print(repr(sequence))
'\n\n# Nougat: Neural Optical Understanding for Academic Documents\n\n Lukas Blecher\n\nCorrespondence to: lblecher@'
```
Lihat [model hub](https://huggingface.co/models?filter=nougat) untuk mencari checkpoint Nougat.
Model ini identik dengan [Donut](donut) dalam hal arsitektur.
## NougatConfig[[transformers.NougatConfig]]
#### transformers.NougatConfig[[transformers.NougatConfig]]
```python
transformers.NougatConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, encoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None, decoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/configuration_nougat.py#L28)
**Parameter:**
is_encoder_decoder (`bool`, *opsional*, defaultnya `True`) : Apakah model digunakan sebagai encoder/decoder atau tidak.
encoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opsional*) : Objek config atau dictionary dari encoder backbone.
decoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opsional*) : Objek config atau dictionary dari decoder backbone.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari NougatModel. Kelas ini digunakan untuk membuat instans model Nougat sesuai dengan argumen yang ditentukan, yang mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai default akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [facebook/nougat-base](https://huggingface.co/facebook/nougat-base)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import NougatConfig, VisionEncoderDecoderModel
>>> # Initializing a Nougat configuration
>>> config = NougatConfig()
>>> # Initializing a VisionEncoderDecoder model (with random weights) from a Nougat configurations
>>> model = VisionEncoderDecoderModel(config=config)
```
#### from_encoder_decoder_configs[[transformers.NougatConfig.from_encoder_decoder_configs]]
```python
from_encoder_decoder_configs(encoder_config: PreTrainedConfig, decoder_config: PreTrainedConfig, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/configuration_nougat.py#L52)
**Mengembalikan:** [VisionEncoderDecoderConfig](/docs/transformers/v5.23.0/id/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig)
Instans dari objek konfigurasi
Instansiasi [VisionEncoderDecoderConfig](/docs/transformers/v5.23.0/id/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig) (atau kelas turunan) dari konfigurasi model encoder yang telah dilatih sebelumnya dan konfigurasi model decoder.
## NougatImageProcessor[[transformers.NougatImageProcessor]]
#### transformers.NougatImageProcessor[[transformers.NougatImageProcessor]]
```python
transformers.NougatImageProcessor(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_nougat.py#L57)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 896, 'width': 672}`): Menjelaskan dimensi input maksimum untuk model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, defaultnya `2`) : Filter resampling yang digunakan jika mengubah ukuran gambar. Ini bisa berupa salah satu enum `PILImageResampling`. Hanya berdampak jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.485, 0.456, 0.406]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.229, 0.224, 0.225]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
do_crop_margin (`bool`, *kwargs*, *opsional*, defaultnya `self.do_crop_margin`) : Apakah akan memangkas margin gambar.
do_thumbnail (`bool`, *kwargs*, *opsional*, defaultnya `self.do_thumbnail`) : Apakah akan mengubah ukuran gambar menggunakan metode thumbnail.
do_align_long_axis (`bool`, *kwargs*, *opsional*, defaultnya `self.do_align_long_axis`) : Apakah akan menyelaraskan sumbu panjang gambar dengan sumbu panjang `size` dengan memutar 90 derajat.
Membangun pemroses gambar NougatImageProcessor.
#### preprocess[[transformers.NougatImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_nougat.py#L74)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Gambar yang akan dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
do_crop_margin (`bool`, *kwargs*, *opsional*, defaultnya `self.do_crop_margin`) : Apakah akan memangkas margin gambar.
do_thumbnail (`bool`, *kwargs*, *opsional*, defaultnya `self.do_thumbnail`) : Apakah akan mengubah ukuran gambar menggunakan metode thumbnail.
do_align_long_axis (`bool`, *kwargs*, *opsional*, defaultnya `self.do_align_long_axis`) : Apakah akan menyelaraskan sumbu panjang gambar dengan sumbu panjang `size` dengan memutar 90 derajat.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
## NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
#### transformers.NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
```python
transformers.NougatImageProcessorPil(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_pil_nougat.py#L59)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 896, 'width': 672}`): Menjelaskan dimensi input maksimum untuk model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, defaultnya `2`) : Filter resampling yang digunakan jika mengubah ukuran gambar. Ini bisa berupa salah satu enum `PILImageResampling`. Hanya berdampak jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.485, 0.456, 0.406]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.229, 0.224, 0.225]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
do_crop_margin (`bool`, *kwargs*, *opsional*, defaultnya `self.do_crop_margin`) : Apakah akan memangkas margin gambar.
do_thumbnail (`bool`, *kwargs*, *opsional*, defaultnya `self.do_thumbnail`) : Apakah akan mengubah ukuran gambar menggunakan metode thumbnail.
do_align_long_axis (`bool`, *kwargs*, *opsional*, defaultnya `self.do_align_long_axis`) : Apakah akan menyelaraskan sumbu panjang gambar dengan sumbu panjang `size` dengan memutar 90 derajat.
Membangun pemroses gambar NougatImageProcessor.
#### preprocess[[transformers.NougatImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_pil_nougat.py#L76)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Gambar yang akan dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
do_crop_margin (`bool`, *kwargs*, *opsional*, defaultnya `self.do_crop_margin`) : Apakah akan memangkas margin gambar.
do_thumbnail (`bool`, *kwargs*, *opsional*, defaultnya `self.do_thumbnail`) : Apakah akan mengubah ukuran gambar menggunakan metode thumbnail.
do_align_long_axis (`bool`, *kwargs*, *opsional*, defaultnya `self.do_align_long_axis`) : Apakah akan menyelaraskan sumbu panjang gambar dengan sumbu panjang `size` dengan memutar 90 derajat.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
## NougatTokenizer[[transformers.NougatTokenizer]]
#### transformers.NougatTokenizer[[transformers.NougatTokenizer]]
```python
transformers.NougatTokenizer(errors: str = 'replace', unk_token: str = '', bos_token: str = '
', eos_token: str = '', pad_token: str = '', vocab: str | dict | list | None = None, merges: str | list | None = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L347)
**Parameter:**
vocab_file (`str`, *opsional*) : Path ke file kosakata.
merges_file (`str`, *opsional*) : Path ke file merges.
tokenizer_file (`str`, *opsional*) : file [tokenizers](https://github.com/huggingface/tokenizers) (umumnya berekstensi .json) yang berisi semua yang diperlukan untuk memuat tokenizer.
clean_up_tokenization_spaces (`str`, *opsional*, defaultnya `False`) : Apakah akan membersihkan spasi setelah decoding. Pembersihan terdiri dari menghapus artefak potensial seperti spasi berlebih.
unk_token (`str`, *opsional*, defaultnya `""`) : Token yang tidak diketahui. Token yang tidak ada dalam kosakata tidak dapat dikonversi menjadi ID dan akan diset sebagai token ini.
bos_token (`str`, *opsional*, defaultnya `""`) : Token awal urutan yang digunakan selama pra-pelatihan. Dapat digunakan sebagai token klasifikator urutan.
eos_token (`str`, *opsional*, defaultnya `""`) : Token akhir urutan.
pad_token (`str`, *opsional*, defaultnya `""`) : Token yang digunakan untuk padding, misalnya saat membatching urutan dengan panjang yang berbeda.
vocab (`str`, `dict` atau `list`, *opsional*) : Kamus kosakata kustom. Jika tidak disediakan, kosakata dimuat dari vocab_file.
merges (`str` atau `list`, *opsional*) : Daftar merges kustom. Jika tidak disediakan, merges dimuat dari merges_file.
Tokenizer untuk Nougat (didukung oleh pustaka tokenizers HuggingFace).
Tokenizer ini mewarisi dari [TokenizersBackend](/docs/transformers/v5.23.0/id/main_classes/tokenizer#transformers.TokenizersBackend) yang berisi sebagian besar metode utama. Pengguna sebaiknya merujuk ke kelas induk ini untuk informasi lebih lanjut mengenai metode-metode tersebut. Kelas ini terutama menambahkan metode-metode spesifik Nougat untuk pascapemrosesan teks yang dihasilkan.
#### correct_tables[[transformers.NougatTokenizer.correct_tables]]
```python
correct_tables(generation: str)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L493)
**Parameter:**
generation (str) : Teks yang dihasilkan untuk diproses lebih lanjut.
**Mengembalikan:** `str`
Teks yang telah diproses ulang.
Menerima string yang dihasilkan dan memperbaiki tabel/tabelar agar sesuai dengan format markdown yang diperlukan.
Contoh:
```python
correct_tables("\begin{table} \begin{tabular}{l l} & \ \end{tabular} \end{table}")
"\begin{table}
abular}{l l} & \ \end{tabular}
le}"
```
#### post_process_generation[[transformers.NougatTokenizer.post_process_generation]]
```python
post_process_generation(generation: str | list[str], fix_markdown: bool = True, num_workers: int | None = None)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L623)
**Parameter:**
generation (Union[str, list[str]]) : Teks yang dihasilkan atau daftar teks yang dihasilkan.
fix_markdown (`bool`, *opsional*, defaultnya `True`) : Apakah akan melakukan perbaikan format Markdown.
num_workers (`int`, *opsional*) : Jumlah worker opsional untuk memanfaatkan multiprocessing (memproses beberapa teks secara paralel).
**Mengembalikan:** Union[str, list[str]]
Teks yang telah diproses pascaproses atau daftar teks yang telah diproses pascaproses.
Proses pascapengolahan teks yang dihasilkan atau daftar teks yang dihasilkan.
Fungsi ini dapat digunakan untuk melakukan pascapemrosesan pada teks yang dihasilkan, seperti memperbaiki format Markdown.
Postprocessing cukup lambat sehingga disarankan untuk menggunakan multiprocessing guna mempercepat proses.
#### post_process_single[[transformers.NougatTokenizer.post_process_single]]
```python
post_process_single(generation: str, fix_markdown: bool = True)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L528)
**Parameter:**
generation (str) : Teks yang dihasilkan untuk diproses lebih lanjut.
fix_markdown (bool, opsional) : Apakah akan melakukan perbaikan format Markdown. Default adalah True.
**Mengembalikan:** `str`
Teks yang telah diproses ulang.
Memproses ulang teks yang dihasilkan secara tunggal. Ekspresi reguler yang digunakan di sini diambil langsung dari para penulis artikel Nougat. Ekspresi ini diberi komentar untuk kejelasan dan diuji secara end-to-end dalam kebanyakan kasus.
#### remove_hallucinated_references[[transformers.NougatTokenizer.remove_hallucinated_references]]
```python
remove_hallucinated_references(text: str)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L463)
**Parameter:**
text (`str`) : Teks input yang berisi referensi.
**Mengembalikan:** `str`
Teks dengan referensi halusinasi yang telah dihapus.
Hapus referensi yang halusinasi atau hilang dari teks.
Fungsi ini mengidentifikasi dan menghapus referensi yang ditandai sebagai hilang atau halusinasi dari teks masukan.
## NougatProcessor[[transformers.NougatProcessor]]
#### transformers.NougatProcessor[[transformers.NougatProcessor]]
```python
transformers.NougatProcessor(image_processor, tokenizer)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L24)
**Parameter:**
image_processor (`NougatImageProcessor`) : Pemroses gambar adalah input yang wajib.
tokenizer (`NougatTokenizer`) : Tokenizer adalah input yang wajib.
Membangun NougatProcessor yang membungkus image processor dan tokenizer menjadi satu processor.
[NougatProcessor](/docs/transformers/v5.23.0/id/model_doc/nougat#transformers.NougatProcessor) menyediakan semua fungsionalitas dari [NougatImageProcessor](/docs/transformers/v5.23.0/id/model_doc/nougat#transformers.NougatImageProcessor) dan [NougatTokenizer](/docs/transformers/v5.23.0/id/model_doc/nougat#transformers.NougatTokenizer). Lihat [~NougatImageProcessor](/docs/transformers/v5.23.0/id/model_doc/nougat#transformers.NougatImageProcessor) dan [~NougatTokenizer](/docs/transformers/v5.23.0/id/model_doc/nougat#transformers.NougatTokenizer) untuk informasi lebih lanjut.
#### __call__[[transformers.NougatProcessor.__call__]]
```python
__call__(images = None, text = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L32)
**Parameter:**
images (``) : Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, set `do_rescale=False`.
text (``) : The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, set `is_split_into_words=True` to avoid ambiguity with batched inputs.
return_tensors (`str` atau [TensorType](/docs/transformers/v5.23.0/id/internal/file_utils#transformers.TensorType), *opsional*) : Jika diatur, akan mengembalikan tensor dari framework tertentu. Nilai yang dapat diterima adalah: - `'pt'`: Mengembalikan objek `torch.Tensor` PyTorch. - `'np'`: Mengembalikan objek `np.ndarray` NumPy.
#### from_pretrained[[transformers.NougatProcessor.from_pretrained]]
```python
from_pretrained(pretrained_model_name_or_path: str | os.PathLike, cache_dir: str | os.PathLike | None = None, force_download: bool = False, local_files_only: bool = False, token: str | bool | None = None, revision: str = 'main', **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L1799)
**Parameter:**
pretrained_model_name_or_path (`str` atau `os.PathLike`) : Ini bisa berupa: - string, *model id* dari feature_extractor pretrained yang dihosting di dalam model repo di huggingface.co. - path ke *directory* yang berisi file feature extractor yang disimpan menggunakan metode [save_pretrained()](/docs/transformers/v5.23.0/id/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained), misalnya `./my_model_directory/`. - path ke file JSON feature extractor yang disimpan, *file*, misalnya `./my_model_directory/preprocessor_config.json`.
- ****kwargs** : Argumen kata kunci tambahan yang diteruskan ke [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) dan `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained`.
Instansiasi prosesor yang terkait dengan model pretrained.
Metode kelas ini hanya memanggil metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) dari feature extractor, [ImageProcessingMixin](/docs/transformers/v5.23.0/id/internal/image_processing_utils#transformers.ImageProcessingMixin) dari image processor, dan `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained` dari tokenizer. Silakan merujuk ke docstring dari metode-metode di atas untuk informasi lebih lanjut.
#### save_pretrained[[transformers.NougatProcessor.save_pretrained]]
```python
save_pretrained(save_directory, push_to_hub: bool = False, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L1182)
**Parameter:**
save_directory (`str` atau `os.PathLike`) : Direktori tempat file JSON feature extractor dan file tokenizer akan disimpan (direktori akan dibuat jika belum ada).
push_to_hub (`bool`, *opsional*, default `False`) : Apakah model akan didorong ke Hugging Face model hub setelah disimpan. Anda dapat menentukan repositori tujuan dengan `repo_id` (defaultnya adalah nama `save_directory` di namespace Anda).
kwargs (`dict[str, Any]`, *opsional*) : Argumen kata kunci tambahan yang diteruskan ke metode [push_to_hub()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.utils.PushToHubMixin.push_to_hub).
Menyimpan atribut prosesor ini (feature extractor, tokenizer...) ke dalam direktori yang ditentukan sehingga dapat dimuat ulang menggunakan metode [from_pretrained()](/docs/transformers/v5.23.0/id/model_doc/wav2vec2#transformers.Wav2Vec2Processor.from_pretrained).
Metode kelas ini hanya memanggil [save_pretrained()](/docs/transformers/v5.23.0/id/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) dan [save_pretrained()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.save_pretrained). Silakan merujuk ke docstring dari metode di atas untuk informasi lebih lanjut.
#### batch_decode[[transformers.NougatProcessor.batch_decode]]
```python
batch_decode(*args, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L2054)
Metode ini meneruskan semua argumennya ke [batch_decode()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.batch_decode) dari PreTrainedTokenizer. Silakan lihat docstring dari metode ini untuk informasi lebih lanjut.
#### decode[[transformers.NougatProcessor.decode]]
```python
decode(*args, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L2063)
Metode ini meneruskan semua argumennya ke [decode()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.decode) dari PreTrainedTokenizer. Silakan lihat docstring dari metode ini untuk informasi lebih lanjut.
#### post_process_generation[[transformers.NougatProcessor.post_process_generation]]
```python
post_process_generation(*args, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L40)
Metode ini meneruskan semua argumennya ke `~PreTrainedTokenizer.post_process_generation` dari NougatTokenizer. Silakan merujuk ke docstring metode ini untuk informasi lebih lanjut.