# X-CLIP
## 概述
X-CLIP 模型由 Bolin Ni、Houwen Peng、Minghao Chen、Songyang Zhang、Gaofeng Meng、Jianlong Fu、Shiming Xiang 和 Haibin Ling 在 [Expanding Language-Image Pretrained Models for General Video Recognition](https://huggingface.co/papers/2208.02816) 中提出。X-CLIP 是 [CLIP](clip) 针对视频的最小化扩展。该模型由文本编码器、跨帧视觉编码器、多帧整合 Transformer 以及视频专用提示生成器组成。
该论文的摘要如下:
*对比式语言-图像预训练在从网络规模数据中学习视觉-文本联合表示方面取得了巨大成功,并展现出在各种图像任务上卓越的“零样本”泛化能力。然而,如何有效地将此类新的语言-图像预训练方法扩展到视频领域仍是一个开放性问题。在本工作中,我们提出了一种简单而有效的方法,直接将预训练的语言-图像模型适配到视频识别任务中,而不是从头开始预训练一个新模型。更具体地说,为了捕获帧在时间维度上的长程依赖关系,我们提出了一种跨帧注意力机制,该机制显式地在帧之间交换信息。该模块轻量级,并且可以无缝地插入到预训练的语言-图像模型中。此外,我们提出了一种视频特定的提示方案,该方案利用视频内容信息来生成具有判别性的文本提示。大量实验表明,我们的方法是有效的,并且可以泛化到不同的视频识别场景。特别是,在全监督设置下,我们的方法在 Kinectics-400 上达到了 87.1% 的 top-1 准确率,同时与 Swin-L 和 ViViT-H 相比,使用的 FLOPs 减少了 12 倍。在零样本实验中,我们的方法在两种流行协议下的 top-1 准确率上分别超越了当前最先进方法 +7.6% 和 +14.9%。在少样本场景中,当标注数据极其有限时,我们的方法比之前最好的方法分别高出 +32.1% 和 +23.1%。*
提示:
- X-CLIP 的用法与 [CLIP](clip) 完全相同。
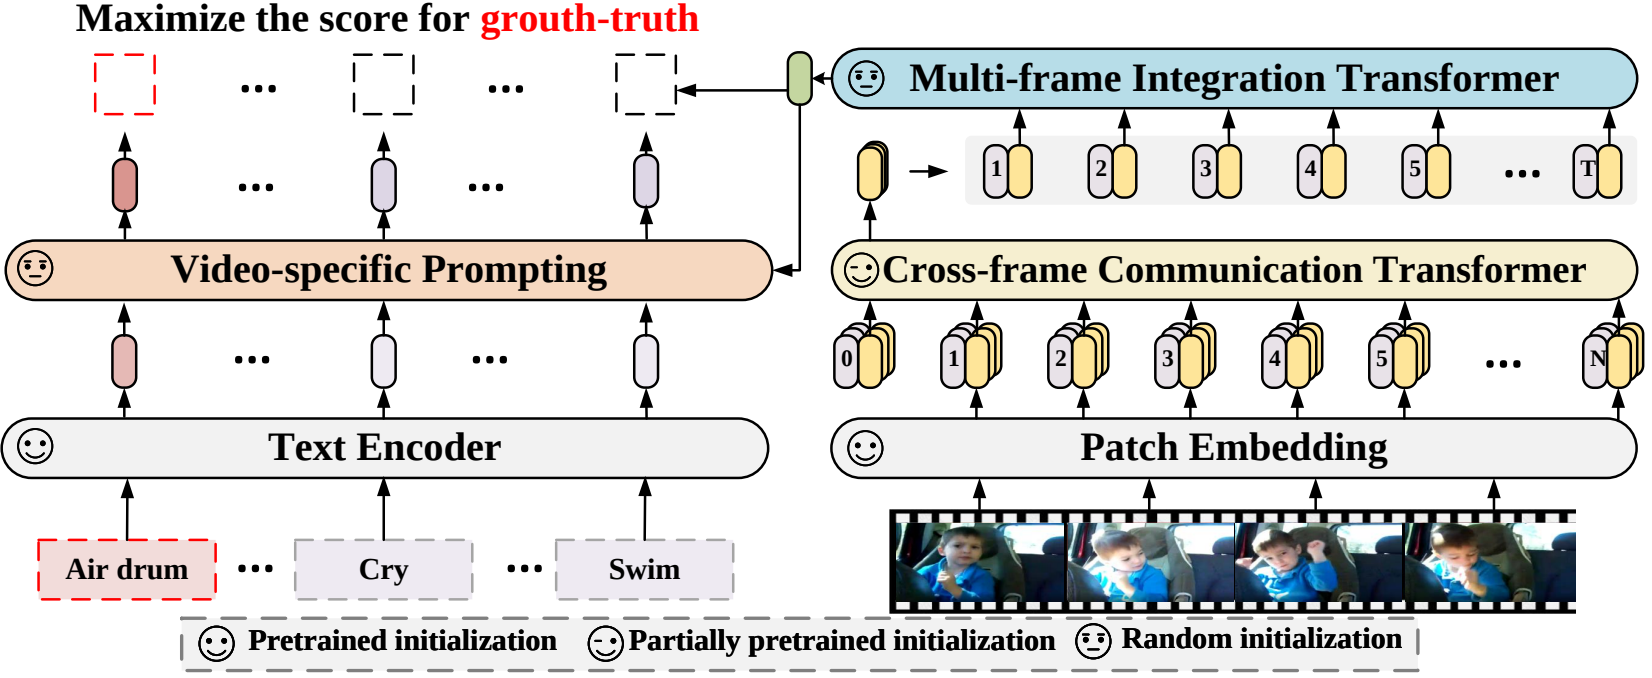 X-CLIP 架构。摘自原始论文。
该模型由 [nielsr](https://huggingface.co/nielsr) 贡献。原始代码可在[此处](https://github.com/microsoft/VideoX/tree/master/X-CLIP)找到。
## 资源
一份来自 Hugging Face 官方和社区(以 🌎 标识)的资源列表,帮助你快速上手 X-CLIP。
- X-CLIP 的演示笔记本可在[此处](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/X-CLIP)找到。
如果您有兴趣提交资源以收录在此处,请随时发起 Pull Request,我们将对其进行审核!理想情况下,该资源应展示一些新内容,而不是重复现有资源。
## XCLIPProcessor[[transformers.XCLIPProcessor]]
#### transformers.XCLIPProcessor[[transformers.XCLIPProcessor]]
```python
transformers.XCLIPProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/processing_x_clip.py#L23)
**参数:**
image_processor (`image_processor_class`):图像处理器是必需的输入。
tokenizer (`tokenizer_class`):分词器是必需的输入。
构建一个 XCLIPProcessor,它将图像处理器和分词器封装为单一处理器。
[XCLIPProcessor](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPProcessor) 提供了 `image_processor_class` 和 `tokenizer_class` 的所有功能。有关更多信息,请参阅 `~image_processor_class` 和 `~tokenizer_class`。
#### __调用__[[transformers.XCLIPProcessor.__call__]]
```python
__call__(images = None, text = None, videos = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/processing_x_clip.py#L28)
## XCLIPConfig[[transformers.XCLIPConfig]]
#### transformers.XCLIPConfig[[transformers.XCLIPConfig]]
```python
transformers.XCLIPConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, projection_dim: int = 512, prompt_layers: int = 2, prompt_alpha: float = 0.1, prompt_hidden_act: str = 'quick_gelu', prompt_num_attention_heads: int = 8, prompt_attention_dropout: float | int = 0.0, prompt_projection_dropout: float | int = 0.0, logit_scale_init_value: float = 2.6592, initializer_factor: float = 1.0)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/configuration_x_clip.py#L119)
**参数:**
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`,*可选*):文本骨干网络的配置对象或字典。
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`,*可选*):视觉骨干网络的配置对象或字典。
projection_dim (`int`,*可选*,默认值为 `512`):文本和视觉投影层的维度。
prompt_layers (`int`,*可选*,默认为 2):视频专用提示生成器中的层数。
prompt_alpha (`float`,*可选*,默认值为 0.1):在视频专用提示词生成器中使用的 Alpha 值。
prompt_hidden_act (`str` 或 `function`,*可选*,默认为 `"quick_gelu"`):视频专用提示生成器中的非线性激活函数(函数或字符串)。如果为字符串,则支持 `"gelu"`、`"relu"`、`"selu"`、`"gelu_new"` 和 `"quick_gelu"`。
prompt_num_attention_heads (`int`, *可选*,默认为 8):视频特定提示生成器中交叉注意力的注意力头数量。
prompt_attention_dropout (`float`, *可选*,默认为 0.0):视频专用提示生成器中注意力层的 dropout 概率。
prompt_projection_dropout (`float`, *可选*,默认为 0.0):视频专用提示生成器中投影层的 dropout 概率。
logit_scale_init_value (`float`,*可选*,默认值为 `2.6592`):*logit_scale* 参数的初始值。
initializer_factor (`float`, *可选*,默认为 `1.0`):用于初始化所有权重矩阵的系数(应保持为 1,内部用于初始化测试)。
这是用于存储 X ClipModel 配置的类。它根据指定的参数实例化 X Clip 模型,并定义模型架构。使用默认值实例化配置将生成与 [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32) 类似的配置。
配置对象继承自 [PreTrainedConfig](/docs/transformers/main/zh/main_classes/configuration#transformers.PreTrainedConfig),可用于控制模型输出。有关更多信息,请参阅 [PreTrainedConfig](/docs/transformers/main/zh/main_classes/configuration#transformers.PreTrainedConfig) 的文档。
## XCLIPTextConfig[[transformers.XCLIPTextConfig]]
#### transformers.XCLIPTextConfig[[transformers.XCLIPTextConfig]]
```python
transformers.XCLIPTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 77, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/configuration_x_clip.py#L27)
**参数:**
vocab_size (`int`,*可选*,默认值为 `49408`):模型的词汇表大小。定义了 `input_ids` 可以表示的不同 token 数量。
hidden_size (`int`,*可选*,默认为 `512`):隐藏表示的维度。
intermediate_size (`int`,*可选*,默认为 `2048`):MLP 表示的维度。
num_hidden_layers (`int`,*可选*,默认为 `12`):Transformer 解码器中的隐藏层数。
num_attention_heads (`int`,*可选*,默认为 `8`):Transformer 解码器中每个注意力层的注意力头数量。
max_position_embeddings (`int`,*可选*,默认值为 `77`):该模型可能使用的最大序列长度。
hidden_act (`str`,*可选*,默认为 `quick_gelu`):解码器中的非线性激活函数(函数或字符串)。例如,`"gelu"`、`"relu"`、`"silu"` 等。
layer_norm_eps (`float`,*可选*,默认为 `1e-05`):层归一化层所使用的 epsilon。
attention_dropout (`Union[float, int]`,*可选*,默认值为 `0.0`):注意力概率的 dropout 比率。
initializer_range (`float`,*可选*,默认值为 `0.02`):用于初始化所有权重矩阵的 truncated_normal_initializer 的标准差。
initializer_factor (`float`, *可选*,默认为 `1.0`):用于初始化所有权重矩阵的系数(应保持为 1,内部用于初始化测试)。
pad_token_id (`int`,*可选*,默认为 `1`):词表中用于填充的 token id。
bos_token_id (`int`,*可选*,默认为 `0`):词汇表中用于表示流开始的 token id。
eos_token_id (`Union[int, list[int]]`,*可选*,默认为 `2`):词汇表中用于表示流结束(end-of-stream)的 token id。
这是用于存储 X ClipModel 配置的类。它根据指定的参数实例化 X Clip 模型,并定义模型架构。使用默认值实例化配置将生成与 [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32) 类似的配置。
配置对象继承自 [PreTrainedConfig](/docs/transformers/main/zh/main_classes/configuration#transformers.PreTrainedConfig),可用于控制模型输出。有关更多信息,请参阅 [PreTrainedConfig](/docs/transformers/main/zh/main_classes/configuration#transformers.PreTrainedConfig) 的文档。
示例:
```python
>>> from transformers import XCLIPTextModel, XCLIPTextConfig
>>> # Initializing a XCLIPTextModel with microsoft/xclip-base-patch32 style configuration
>>> configuration = XCLIPTextConfig()
>>> # Initializing a XCLIPTextConfig from the microsoft/xclip-base-patch32 style configuration
>>> model = XCLIPTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## XCLIPVisionConfig[[transformers.XCLIPVisionConfig]]
#### transformers.XCLIPVisionConfig[[transformers.XCLIPVisionConfig]]
```python
transformers.XCLIPVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, mit_hidden_size: int = 512, mit_intermediate_size: int = 2048, mit_num_hidden_layers: int = 1, mit_num_attention_heads: int = 8, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 32, num_frames: int = 8, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, drop_path_rate: float | int = 0.0)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/configuration_x_clip.py#L65)
**参数:**
hidden_size (`int`,*可选*,默认为 `768`):隐藏表示的维度。
intermediate_size (`int`,*可选*,默认值为 `3072`):MLP 表示的维度。
num_hidden_layers (`int`,*可选*,默认为 `12`):Transformer 解码器中的隐藏层数。
num_attention_heads (`int`,*可选*,默认为 `12`):Transformer 解码器中每个注意力层的注意力头数量。
mit_hidden_size (`int`, *可选*,默认为 512):多帧集成 Transformer (MIT) 编码器层的维度。
mit_intermediate_size (`int`,*可选*,默认为 2048):多帧集成 Transformer (MIT) 中“中间”(即前馈)层的维度。
mit_num_hidden_layers (`int`,*可选*,默认为 1):多帧集成 Transformer (MIT) 中的隐藏层数。
mit_num_attention_heads (`int`, *可选*,默认为 8):多帧集成 Transformer (MIT) 中每个注意力层的注意力头数量。
num_channels (`int`,*可选*,默认为 `3`):输入通道数。
image_size (`Union[int, list[int], tuple[int, int]]`,*可选*,默认为 `224`):每张图片的尺寸(分辨率)。
patch_size (`Union[int, list[int], tuple[int, int]]`,*可选*,默认为 `32`):每个 patch 的大小(分辨率)。
num_frames (`int`,*可选*,默认为 8):每个视频中的帧数。
hidden_act (`str`,*可选*,默认为 `quick_gelu`):解码器中的非线性激活函数(函数或字符串)。例如,`"gelu"`、`"relu"`、`"silu"` 等。
layer_norm_eps (`float`,*可选*,默认为 `1e-05`):层归一化层所使用的 epsilon。
attention_dropout (`Union[float, int]`,*可选*,默认值为 `0.0`):注意力概率的 dropout 比率。
initializer_range (`float`,*可选*,默认值为 `0.02`):用于初始化所有权重矩阵的 truncated_normal_initializer 的标准差。
initializer_factor (`float`, *可选*,默认为 `1.0`):用于初始化所有权重矩阵的系数(应保持为 1,内部用于初始化测试)。
drop_path_rate (`Union[float, int]`,*可选*,默认为 `0.0`):用于 patch 融合的 drop path 比率。
这是用于存储 X ClipModel 配置的类。它根据指定的参数实例化 X Clip 模型,并定义模型架构。使用默认值实例化配置将生成与 [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32) 类似的配置。
配置对象继承自 [PreTrainedConfig](/docs/transformers/main/zh/main_classes/configuration#transformers.PreTrainedConfig),可用于控制模型输出。有关更多信息,请参阅 [PreTrainedConfig](/docs/transformers/main/zh/main_classes/configuration#transformers.PreTrainedConfig) 的文档。
示例:
```python
>>> from transformers import XCLIPVisionModel, XCLIPVisionConfig
>>> # Initializing a XCLIPVisionModel with microsoft/xclip-base-patch32 style configuration
>>> configuration = XCLIPVisionConfig()
>>> # Initializing a XCLIPVisionModel model from the microsoft/xclip-base-patch32 style configuration
>>> model = XCLIPVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## XCLIPModel[[transformers.XCLIPModel]]
#### transformers.XCLIPModel[[transformers.XCLIPModel]]
```python
transformers.XCLIPModel(config: XCLIPConfig)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L914)
**参数:**
config ([XCLIPConfig](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPConfig)):模型配置类,包含模型的所有参数。使用配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/main/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
未添加任何特定头部的裸 X Clip 模型,直接输出原始隐藏状态。
该模型继承自 [PreTrainedModel](/docs/transformers/main/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.XCLIPModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L981)
**参数:**
input_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中 token 在词汇表中的索引。默认情况下,填充(padding)将被忽略。可以使用 [AutoTokenizer](/docs/transformers/main/zh/model_doc/auto#transformers.AutoTokenizer) 获取索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/main/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/main/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`,*可选*) : 与输入图像对应的张量。可以使用 `image_processor_class` 获取像素值。有关详细信息,请参阅 `image_processor_class.__call__`(`processor_class` 使用 `image_processor_class` 处理图像)。
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
position_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中每个 token 在位置嵌入中的位置索引。取值范围为 `[0, config.n_positions - 1]`。[什么是位置 ID?](../glossary#position-ids)
return_loss (`bool`, *可选*) : 是否返回对比损失。
interpolate_pos_encoding (`bool`,*可选*,默认为 `False`):是否对预训练的位置编码进行插值。
**返回:** `XCLIPOutput` 或 `tuple(torch.Tensor)`
`XCLIPOutput` 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([XCLIPConfig](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPConfig))和输入。
[XCLIPModel](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPModel) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **loss** (`torch.Tensor`,形状为 `(1,)`,*可选*,当 `return_loss` 为 `True` 时返回) -- 用于视频-文本相似度的对比损失。
- **logits_per_text**(形状为 `(text_batch_size, video_batch_size)` 的 `torch.Tensor`)-- `text_embeds` 与 `video_embeds` 之间的缩放点积分数。这表示文本-视频相似度分数。
- **text_embeds**(形状为 `(batch_size, output_dim`) 的 `torch.Tensor`)-- 通过对 [XCLIPTextModel](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPTextModel) 的池化输出应用投影层获得的文本嵌入。
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`,*可选*) -- [XCLIPTextModel](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPTextModel) 的输出。
- **vision_model_output**(`~modeling_outputs.BaseModelOutputWithPooling`,*可选*)—— [XCLIPVisionModel](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPVisionModel) 的输出。
- **logits_per_video**(形状为 `(video_batch_size, text_batch_size)` 的 `torch.Tensor`)-- `video_embeds` 与 `text_embeds` 之间的缩放点积分数。这表示视频-文本相似度分数。
- **video_embeds** (`torch.Tensor`,形状为 `(batch_size, output_dim`) -- 通过对 [XCLIPVisionModel](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPVisionModel) 的池化输出应用投影层获得的视频嵌入。
- **mit_output** (`~modeling_outputs.BaseModelOutputWithPooling`,*可选*) -- `XCLIPMultiframeIntegrationTransformer`(简称 MIT)的输出。
示例:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, AutoModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 8 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = processor(
... text=["playing sports", "eating spaghetti", "go shopping"],
... videos=list(video),
... return_tensors="pt",
... padding=True,
... )
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> logits_per_video = outputs.logits_per_video # this is the video-text similarity score
>>> probs = logits_per_video.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(probs)
tensor([[1.9496e-04, 9.9960e-01, 2.0825e-04]])
```
#### get_text_features[[transformers.XCLIPModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L946)
**参数:**
input_ids (形状为 `(batch_size, sequence_length)` 的 `torch.Tensor`):输入序列中 token 在词汇表中的索引。默认情况下,填充(padding)将被忽略。可以使用 [AutoTokenizer](/docs/transformers/main/zh/model_doc/auto#transformers.AutoTokenizer) 获取索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/main/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/main/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
position_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中每个 token 在位置嵌入中的位置索引。取值范围为 `[0, config.n_positions - 1]`。[什么是位置 ID?](../glossary#position-ids)
**返回:** [BaseModelOutputWithPooling](/docs/transformers/main/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `tuple(torch.Tensor)`
一个 [BaseModelOutputWithPooling](/docs/transformers/main/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([XCLIPConfig](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPConfig))和输入。
- **last_hidden_state**(形状为 `(batch_size, sequence_length, hidden_size)` 的 `torch.Tensor`)-- 模型最后一层输出的隐藏状态序列。
- **pooler_output**(形状为 `(batch_size, hidden_size)` 的 `torch.Tensor`)-- 序列中第一个 token(分类 token)的最后一层隐藏状态,经过用于辅助预训练任务的层进一步处理后的结果。例如,对于 BERT 系列模型,这返回的是分类 token 经过线性层和 tanh 激活函数处理后的结果。线性层的权重是在预训练期间通过下一句预测(分类)目标训练得到的。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> import torch
>>> from transformers import AutoTokenizer, AutoModel
>>> tokenizer = AutoTokenizer.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_video_features[[transformers.XCLIPModel.get_video_features]]
```python
get_video_features(pixel_values: Tensor, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L1141)
**参数:**
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`):与输入图像对应的张量。可以使用 `image_processor_class` 获取像素值。有关详细信息,请参阅 `image_processor_class.__call__`(`processor_class` 使用 `image_processor_class` 处理图像)。
**返回:** [BaseModelOutputWithPooling](/docs/transformers/main/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `tuple(torch.Tensor)`
一个 [BaseModelOutputWithPooling](/docs/transformers/main/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([XCLIPConfig](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPConfig))和输入。
- **last_hidden_state**(形状为 `(batch_size, sequence_length, hidden_size)` 的 `torch.Tensor`)-- 模型最后一层输出的隐藏状态序列。
- **pooler_output**(形状为 `(batch_size, hidden_size)` 的 `torch.Tensor`)-- 序列中第一个 token(分类 token)的最后一层隐藏状态,经过用于辅助预训练任务的层进一步处理后的结果。例如,对于 BERT 系列模型,这返回的是分类 token 经过线性层和 tanh 激活函数处理后的结果。线性层的权重是在预训练期间通过下一句预测(分类)目标训练得到的。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, AutoModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 8 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = processor(videos=list(video), return_tensors="pt")
>>> video_features = model.get_video_features(**inputs)
```
## XCLIPTextModel[[transformers.XCLIPTextModel]]
#### transformers.XCLIPTextModel[[transformers.XCLIPTextModel]]
```python
transformers.XCLIPTextModel(config: XCLIPTextConfig)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L549)
**参数:**
config ([XCLIPTextConfig](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPTextConfig)):模型配置类,包含模型的所有参数。通过配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/main/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
XCLIP 的文本模型,顶部未添加任何分类头或投影层。
该模型继承自 [PreTrainedModel](/docs/transformers/main/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.XCLIPTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L563)
**参数:**
input_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中各个 token 在词汇表中的索引。默认情况下,填充(padding)会被忽略。可以使用 [AutoTokenizer](/docs/transformers/main/zh/model_doc/auto#transformers.AutoTokenizer) 获取这些索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/main/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/main/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
position_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中每个 token 在位置嵌入中的位置索引。取值范围为 `[0, config.n_positions - 1]`。[什么是位置 ID?](../glossary#position-ids)
**返回:** [BaseModelOutputWithPooling](/docs/transformers/main/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `tuple(torch.Tensor)`
一个 [BaseModelOutputWithPooling](/docs/transformers/main/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([XCLIPConfig](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPConfig))和输入。
[XCLIPTextModel](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPTextModel) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **last_hidden_state**(形状为 `(batch_size, sequence_length, hidden_size)` 的 `torch.Tensor`)-- 模型最后一层输出的隐藏状态序列。
- **pooler_output**(形状为 `(batch_size, hidden_size)` 的 `torch.Tensor`)-- 序列中第一个 token(分类 token)的最后一层隐藏状态,经过用于辅助预训练任务的层进一步处理后的结果。例如,对于 BERT 系列模型,这返回的是分类 token 经过线性层和 tanh 激活函数处理后的结果。线性层的权重是在预训练期间通过下一句预测(分类)目标训练得到的。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> from transformers import AutoTokenizer, XCLIPTextModel
>>> model = XCLIPTextModel.from_pretrained("microsoft/xclip-base-patch32")
>>> tokenizer = AutoTokenizer.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## XCLIPVisionModel[[transformers.XCLIPVisionModel]]
#### transformers.XCLIPVisionModel[[transformers.XCLIPVisionModel]]
```python
transformers.XCLIPVisionModel(config: XCLIPVisionConfig)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L647)
**参数:**
config ([XCLIPVisionConfig](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPVisionConfig)):模型配置类,包含模型的所有参数。通过配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/main/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
XCLIP 的视觉模型,顶部未添加任何分类头或投影层。
该模型继承自 [PreTrainedModel](/docs/transformers/main/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.XCLIPVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor], interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L663)
**参数:**
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`,*可选*) : 与输入图像对应的张量。可以使用 `image_processor_class` 获取像素值。有关详细信息,请参阅 `image_processor_class.__call__`(`processor_class` 使用 `image_processor_class` 处理图像)。
interpolate_pos_encoding (`bool`,*可选*,默认为 `False`):是否对预训练的位置编码进行插值。
**返回:** [BaseModelOutputWithPooling](/docs/transformers/main/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `tuple(torch.Tensor)`
一个 [BaseModelOutputWithPooling](/docs/transformers/main/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([XCLIPConfig](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPConfig))和输入。
[XCLIPVisionModel](/docs/transformers/main/zh/model_doc/xclip#transformers.XCLIPVisionModel) 的 forward 方法会重写 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **last_hidden_state**(形状为 `(batch_size, sequence_length, hidden_size)` 的 `torch.Tensor`)-- 模型最后一层输出的隐藏状态序列。
- **pooler_output**(形状为 `(batch_size, hidden_size)` 的 `torch.Tensor`)-- 序列中第一个 token(分类 token)的最后一层隐藏状态,经过用于辅助预训练任务的层进一步处理后的结果。例如,对于 BERT 系列模型,这返回的是分类 token 经过线性层和 tanh 激活函数处理后的结果。线性层的权重是在预训练期间通过下一句预测(分类)目标训练得到的。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, XCLIPVisionModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 16 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = XCLIPVisionModel.from_pretrained("microsoft/xclip-base-patch32")
>>> pixel_values = processor(videos=list(video), return_tensors="pt").pixel_values
>>> batch_size, num_frames, num_channels, height, width = pixel_values.shape
>>> pixel_values = pixel_values.reshape(-1, num_channels, height, width)
>>> outputs = model(pixel_values)
>>> last_hidden_state = outputs.last_hidden_state
```