# ConvNeXT
## Обзор
Модель ConvNeXT была предложена в статье [A ConvNet for the 2020s](https://huggingface.co/papers/2201.03545) Zhuang Liu, Hanzi Mao, Chao-Yuan Wu, Christoph Feichtenhofer, Trevor Darrell, Saining Xie. ConvNeXT — это чисто свёрточная модель (ConvNet), вдохновлённая архитектурой Vision Transformers, которая, по утверждению авторов, превосходит их по производительности.
Аннотация из статьи следующая:
*«Ревущие двадцатые» в области визуального распознавания начались с появлением Vision Transformers (ViT), которые быстро вытеснили ConvNets, став передовыми моделями классификации изображений. Однако «ванильный» ViT сталкивается с трудностями при применении к общим задачам компьютерного зрения, таким как обнаружение объектов и семантическая сегментация. Именно иерархические Transformers (например, Swin Transformers) вернули ряд индуктивных смещений ConvNets, сделав Transformers практически пригодными в качестве универсального визуального бэкбона и продемонстрировав выдающиеся результаты на широком спектре задач зрения. Тем не менее эффективность таких гибридных подходов по-прежнему в значительной степени приписывается внутренней превосходности Transformers, а не собственным индуктивным смещениям свёрток. В данной работе мы пересматриваем пространства проектирования и проверяем пределы возможностей, которых может достичь чистый ConvNet. Мы постепенно «модернизируем» стандартный ResNet в сторону архитектуры Vision Transformer, обнаруживая по пути несколько ключевых компонентов, которые вносят вклад в разницу производительности. Результатом этого исследования стала семья чистых ConvNet-моделей под названием ConvNeXt. Построенные исключительно из стандартных модулей ConvNet, ConvNeXt успешно конкурируют с Transformers по точности и масштабируемости, достигая точности top-1 на ImageNet 87,8% и превосходя Swin Transformers на задачах обнаружения на COCO и сегментации на ADE20K, сохраняя при этом простоту и эффективность стандартных ConvNets.*
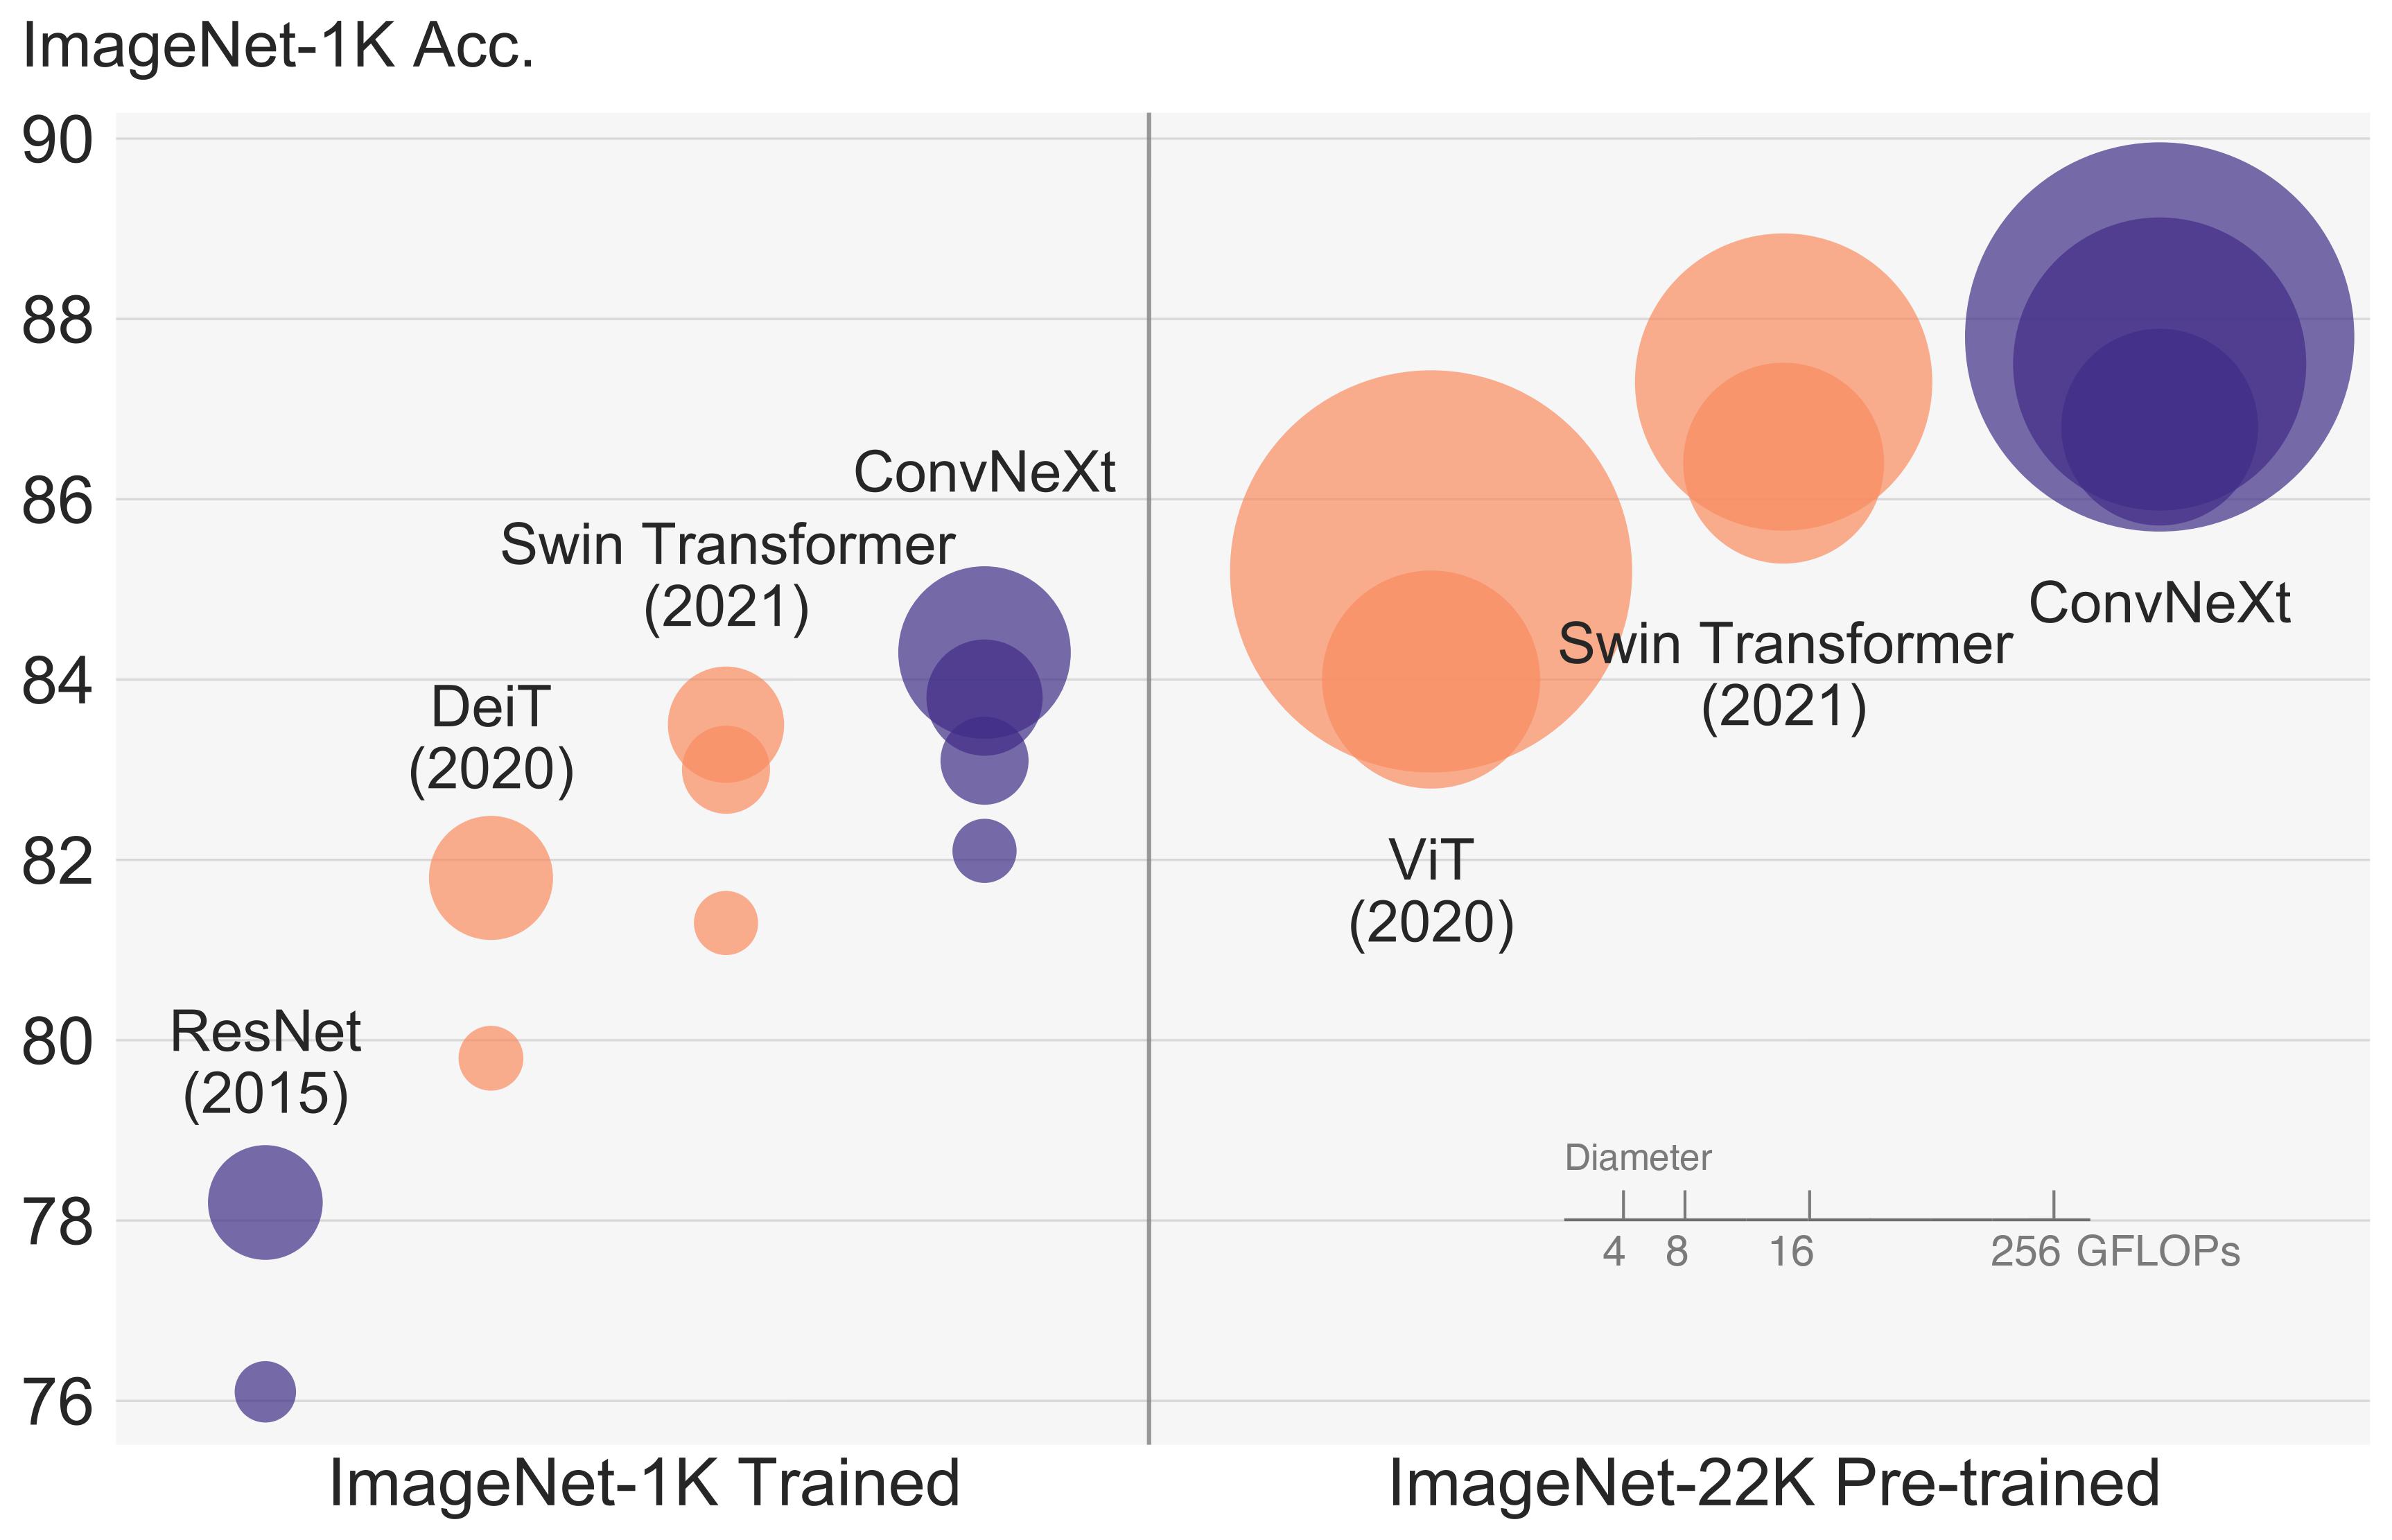 Архитектура ConvNeXT. Взята из оригинальной статьи.
Эта модель была предоставлена пользователем [nielsr](https://huggingface.co/nielsr). Исходный код можно найти [здесь](https://github.com/facebookresearch/ConvNeXt).
## Ресурсы
Список официальных ресурсов Hugging Face и сообщества (отмечены 🌎), которые помогут вам начать работу с ConvNeXT.
- [ConvNextForImageClassification](/docs/transformers/main/ru/model_doc/convnext#transformers.ConvNextForImageClassification) поддерживается в этом [ноутбуке](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb).
- См. также: [Руководство по задаче классификации изображений](../tasks/image_classification)
Если вы хотите предложить ресурс для включения в этот раздел, пожалуйста, создайте Pull Request, и мы его рассмотрим! В идеале ресурс должен демонстрировать что-то новое, а не дублировать существующие материалы.
## ConvNextConfig[[transformers.ConvNextConfig]]
#### transformers.ConvNextConfig[[transformers.ConvNextConfig]]
```python
transformers.ConvNextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, num_channels: int = 3, patch_size: int | list[int] | tuple[int, int] = 4, num_stages: int = 4, hidden_sizes: list[int] | tuple[int, ...] | None = (96, 192, 384, 768), depths: list[int] | tuple[int, ...] | None = (3, 3, 9, 3), hidden_act: str = 'gelu', initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, layer_scale_init_value: float = 1e-06, drop_path_rate: float | int = 0.0, image_size: int | list[int] | tuple[int, int] = 224, _out_features: list[str] | None = None, _out_indices: list[int] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/configuration_convnext.py#L25)
**Параметры:**
num_channels (`int`, *необязательный*, по умолчанию `3`) : Количество входных каналов.
patch_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `4`) : Размер (разрешение) каждого патча.
num_stages (`int`, *необязательный*, по умолчанию 4) : Количество стадий в модели.
hidden_sizes (`Union[list[int], tuple[int, ...]]`, *необязательный*, по умолчанию `(96, 192, 384, 768)`) : Размерность (скрытый размер) на каждом этапе модели.
depths (`Union[list[int], tuple[int, ...]]`, *необязательный*, по умолчанию `(3, 3, 9, 3)`) : Глубина каждого слоя в Transformer.
hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-12`) : Значение epsilon, используемое слоями нормализации.
layer_scale_init_value (`float`, *optional*, по умолчанию `1e-06`) : Масштаб, используемый в слоях само-внимания. 0.1 для базовых моделей, 1e-6 для крупных. Установите 0, чтобы отключить масштабирование слоя.
drop_path_rate (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Коэффициент drop path для слияния патчей.
image_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `224`) : Размер (разрешение) каждого изображения.
Это класс конфигурации для хранения настроек ConvNextModel. Он используется для создания модели Convnext в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [facebook/convnext-tiny-224](https://huggingface.co/facebook/convnext-tiny-224)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import ConvNextConfig, ConvNextModel
>>> # Initializing a ConvNext convnext-tiny-224 style configuration
>>> configuration = ConvNextConfig()
>>> # Initializing a model (with random weights) from the convnext-tiny-224 style configuration
>>> model = ConvNextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ConvNextImageProcessor[[transformers.ConvNextImageProcessor]]
#### transformers.ConvNextImageProcessor[[transformers.ConvNextImageProcessor]]
```python
transformers.ConvNextImageProcessor(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/image_processing_convnext.py#L43)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 384}`): описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `3`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Влияет только в том случае, если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Средние значения изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
crop_pct (`float`, *kwargs*, *необязательный*, по умолчанию `self.crop_pct`) : Процент изображения, который нужно обрезать. Влияет только в том случае, если size < 384.
Создаёт процессор изображений ConvNextImageProcessor.
#### preprocess[[transformers.ConvNextImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *необязательный*) : Флаг разработчика для дополнительных изображений и похожих на них входных данных, которые также будут предобработаны. Используйте этот параметр только в том случае, если передача входных данных через kwarg не работает. Например, `preprocess(images, masks=masks)` — предпочтительный вариант, но для некоторых моделей он приводит к проблемам с приоритетом аргументов. В таких случаях можно использовать `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
Предобработка изображения или пакета изображений.
## ConvNextImageProcessorPil[[transformers.ConvNextImageProcessorPil]]
#### transformers.ConvNextImageProcessorPil[[transformers.ConvNextImageProcessorPil]]
```python
transformers.ConvNextImageProcessorPil(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/image_processing_pil_convnext.py#L43)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 384}`): описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `3`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Влияет только в том случае, если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Средние значения изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
crop_pct (`float`, *kwargs*, *необязательный*, по умолчанию `self.crop_pct`) : Процент изображения, который нужно обрезать. Влияет только в том случае, если size < 384.
Создаёт процессор изображений ConvNextImageProcessor.
#### preprocess[[transformers.ConvNextImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *необязательный*) : Флаг разработчика для дополнительных изображений и похожих на них входных данных, которые также будут предобработаны. Используйте этот параметр только в том случае, если передача входных данных через kwarg не работает. Например, `preprocess(images, masks=masks)` — предпочтительный вариант, но для некоторых моделей он приводит к проблемам с приоритетом аргументов. В таких случаях можно использовать `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
Предобработка изображения или пакета изображений.
## ConvNextModel[[transformers.ConvNextModel]]
#### transformers.ConvNextModel[[transformers.ConvNextModel]]
```python
transformers.ConvNextModel(config: ConvNextConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/modeling_convnext.py#L251)
**Параметры:**
config ([ConvNextConfig](/docs/transformers/main/ru/model_doc/convnext#transformers.ConvNextConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Convnext без дополнительных слоёв, выводящая необработанные скрытые состояния.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.ConvNextModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/modeling_convnext.py#L265)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [ConvNextImageProcessor](/docs/transformers/main/ru/model_doc/convnext#transformers.ConvNextImageProcessor). Подробности см. в [ConvNextImageProcessor.__call__()](/docs/transformers/main/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) (`processor_class` использует [ConvNextImageProcessor](/docs/transformers/main/ru/model_doc/convnext#transformers.ConvNextImageProcessor) для обработки изображений).
**Возвращает:** `BaseModelOutputWithPoolingAndNoAttention` или `tuple(torch.Tensor)`
Объект `BaseModelOutputWithPoolingAndNoAttention` или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([ConvNextConfig](/docs/transformers/main/ru/model_doc/convnext#transformers.ConvNextConfig)) и входных данных.
Метод forward модели [ConvNextModel](/docs/transformers/main/ru/model_doc/convnext#transformers.ConvNextModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, num_channels, height, width)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя после операции пулинга по пространственным измерениям.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, num_channels, height, width)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
Пример:
```python
```
## ConvNextForImageClassification[[transformers.ConvNextForImageClassification]]
#### transformers.ConvNextForImageClassification[[transformers.ConvNextForImageClassification]]
```python
transformers.ConvNextForImageClassification(config: ConvNextConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/modeling_convnext.py#L293)
**Параметры:**
config ([ConvNextConfig](/docs/transformers/main/ru/model_doc/convnext#transformers.ConvNextConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель ConvNext с головой для классификации изображений (линейный слой поверх пул-функции), например, для ImageNet.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.ConvNextForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/modeling_convnext.py#L311)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [ConvNextImageProcessor](/docs/transformers/main/ru/model_doc/convnext#transformers.ConvNextImageProcessor). Подробности см. в [ConvNextImageProcessor.__call__()](/docs/transformers/main/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) (`processor_class` использует [ConvNextImageProcessor](/docs/transformers/main/ru/model_doc/convnext#transformers.ConvNextImageProcessor) для обработки изображений).
labels (`torch.LongTensor` формы `(batch_size,)`, *необязательный*) : Метки для вычисления потерь классификации/регрессии изображений. Индексы должны находиться в диапазоне `[0, ..., config.num_labels - 1]`. Если `config.num_labels == 1`, вычисляется потеря регрессии (среднеквадратичная потеря), если `config.num_labels > 1`, вычисляется потеря классификации (кросс-энтропия).
**Возвращает:** [ImageClassifierOutputWithNoAttention](/docs/transformers/main/ru/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) или `tuple(torch.Tensor)`
Объект [ImageClassifierOutputWithNoAttention](/docs/transformers/main/ru/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([ConvNextConfig](/docs/transformers/main/ru/model_doc/convnext#transformers.ConvNextConfig)) и входных данных.
Метод forward класса [ConvNextForImageClassification](/docs/transformers/main/ru/model_doc/convnext#transformers.ConvNextForImageClassification) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери классификации (или регрессии, если config.num_labels==1).
- **logits** (`torch.Tensor` формы `(batch_size, config.num_labels)`) — Оценки классификации (или регрессии, если config.num_labels==1) до применения SoftMax.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или при `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого этапа) формы `(batch_size, num_channels, height, width)`. Скрытые состояния (также называемые картами признаков) модели на выходе каждого этапа.
Пример:
```python
>>> from transformers import AutoImageProcessor, ConvNextForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/convnext-tiny-224")
>>> model = ConvNextForImageClassification.from_pretrained("facebook/convnext-tiny-224")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```