
Hub documentation
Редактирование наборов данных
Редактирование наборов данных
Hub позволяет совместно курировать наборы данных сообщества и исследовательские данные. Мы рекомендуем вам изучать доступные на Hub наборы данных и вносить вклад в их улучшение, чтобы помочь развитию ML-сообщества и ускорить прогресс для всех. Все вклады приветствуются!
Для начала создайте аккаунт Hugging Face Hub, если у вас его еще нет.
Редактирование с помощью интерфейса Hub
Пока эта функция доступна только для наборов данных в форматах CSV, TSV и Parquet.
Веб-интерфейс Hub позволяет пользователям без технических навыков редактировать набор данных.
Откройте страницу набора данных и перейдите на вкладку Data Studio, чтобы начать редактирование.


Нажмите Toggle edit mode, чтобы включить редактирование набора данных.
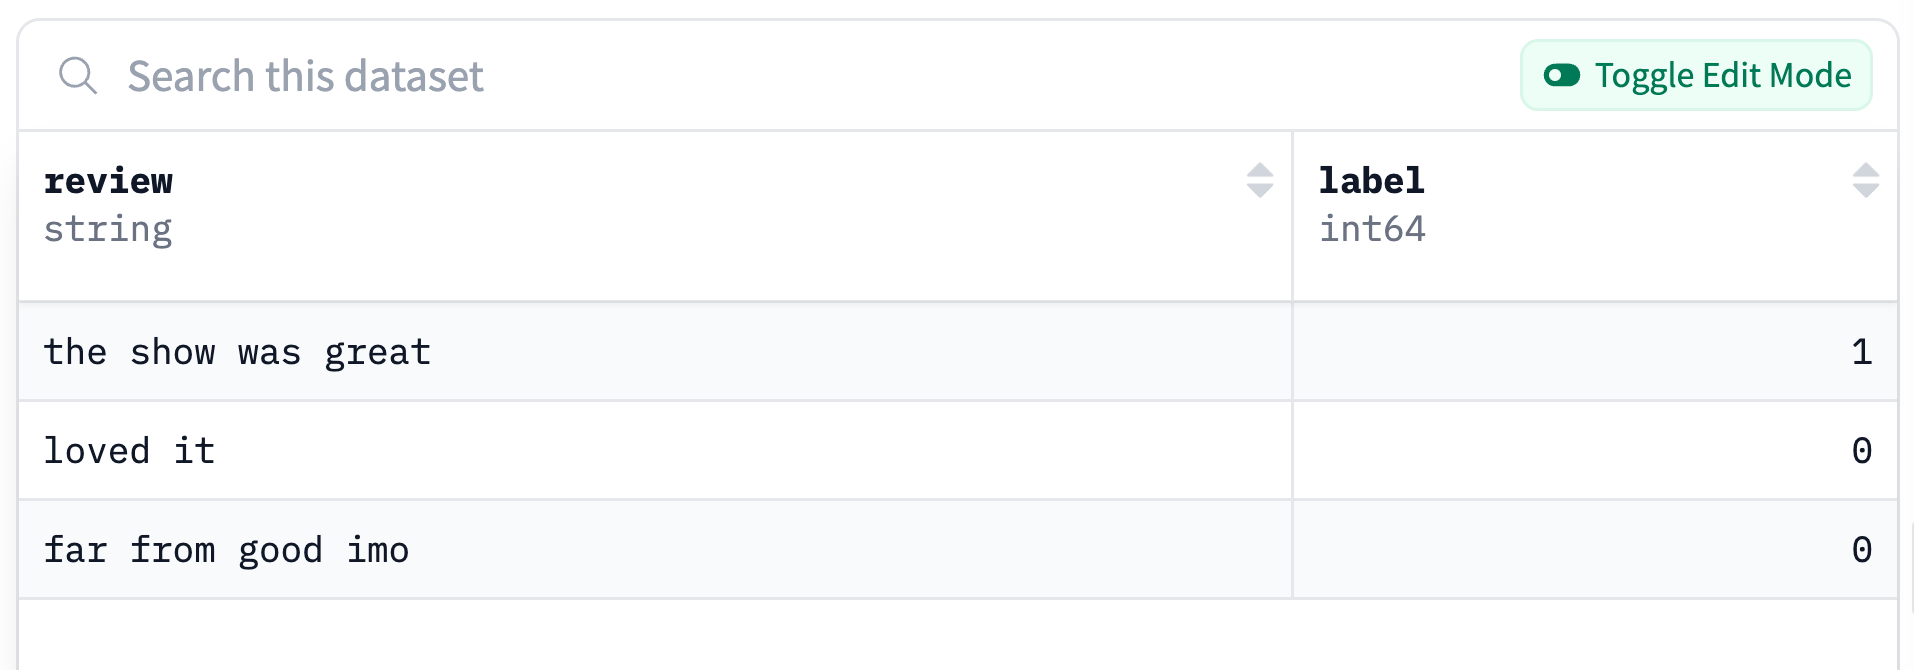


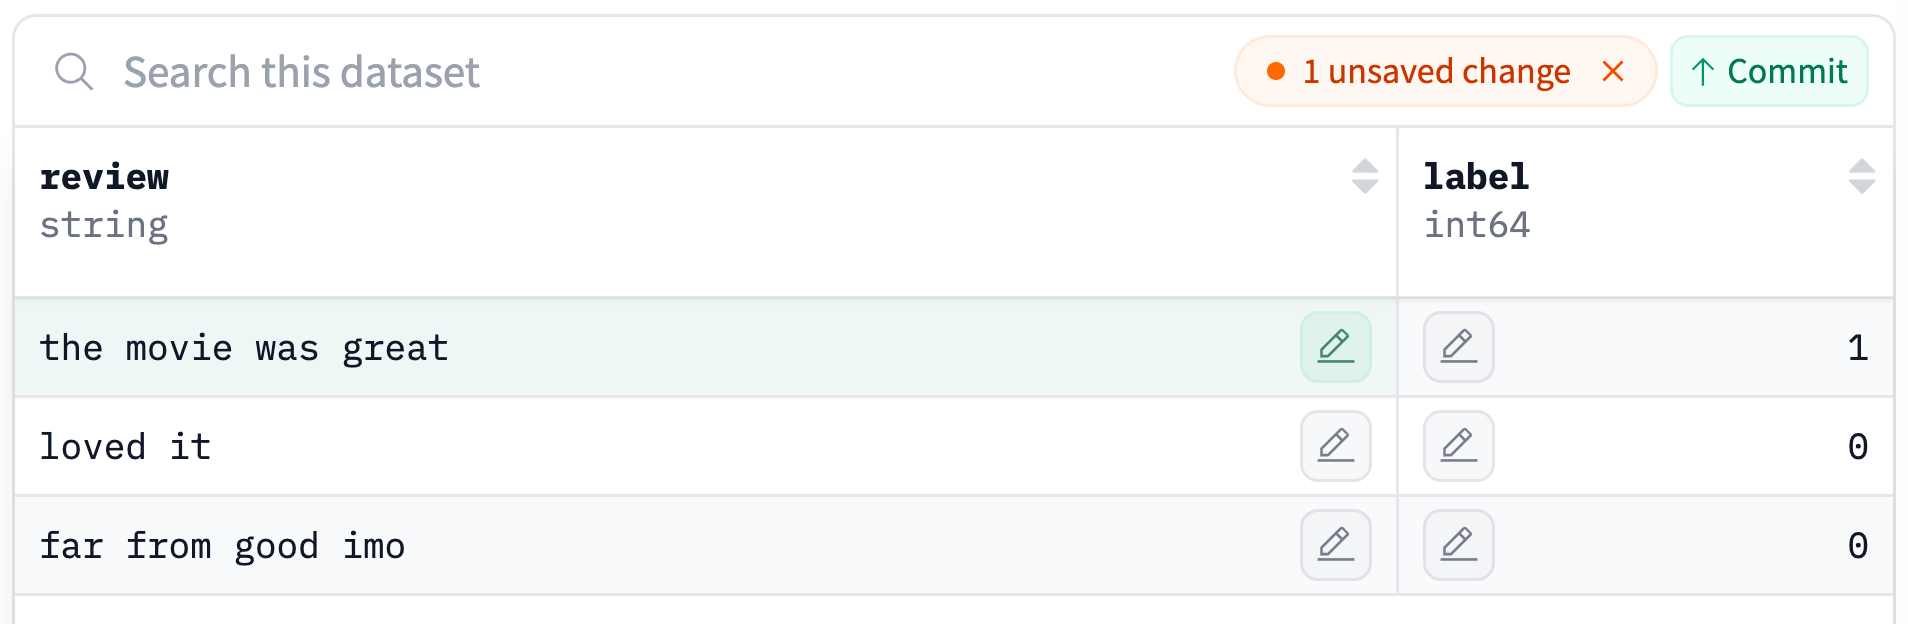
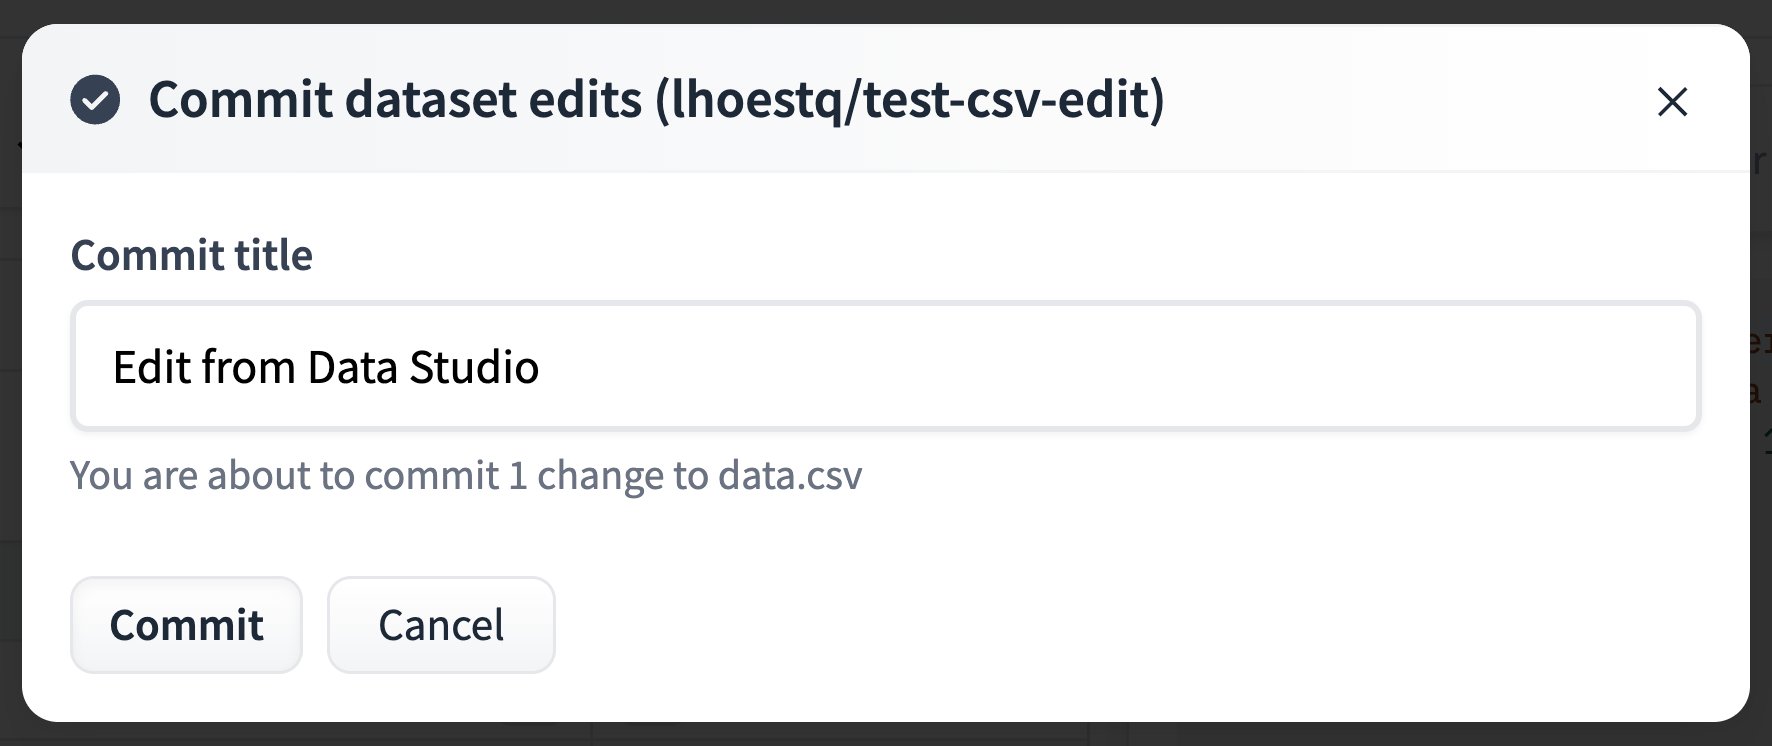
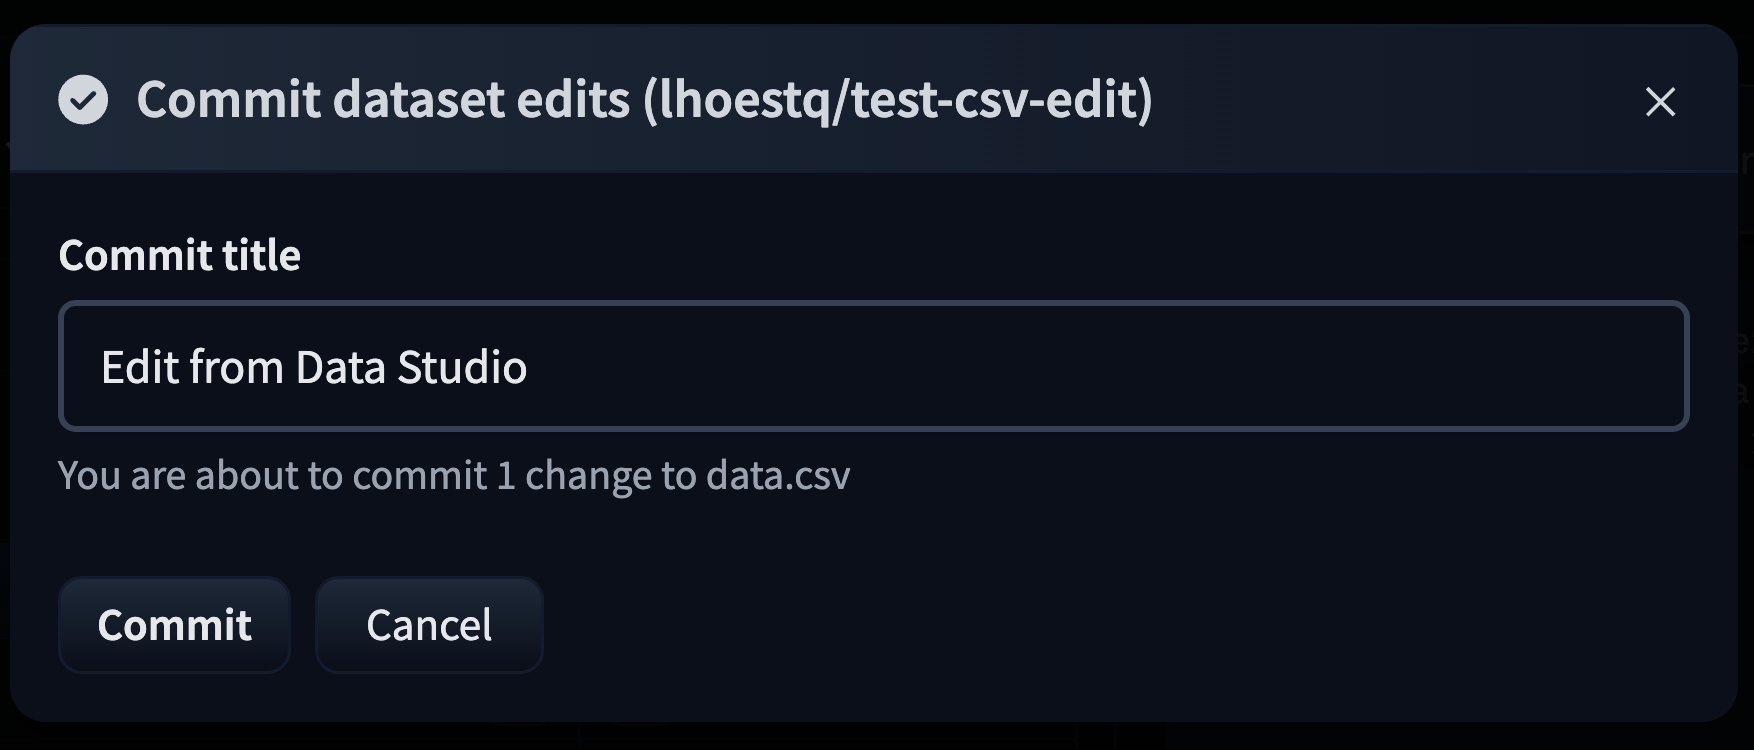
Отредактируйте столько ячеек, сколько хотите, и в конце нажмите Commit, чтобы зафиксировать изменения и оставить сообщение коммита.
Использование клиентской библиотеки huggingface_hub
Библиотека huggingface_hub позволяет управлять репозиториями Hub, включая редактирование наборов данных.
Например, вот как отредактировать файл CSV с помощью Hugging Face FileSystem API:
from huggingface_hub import hffs

path = f"datasets/{repo_id}/data.csv"

with hffs.open(path, "r") as f:
    content = f.read()
edited_content = content.replace("foo", "bar")
with hffs.open(path, "w") as f:
    f.write(edited_content)
Вы также можете внести изменения локально на вашем диске и зафиксировать их:
from huggingface_hub import hf_hub_download, upload_file

local_path = hf_hub_download(repo_id=repo_id, path_in_repo= "data.csv", repo_type="dataset")

with open(path, "r") as f:
    content = f.read()
edited_content = content.replace("foo", "bar")
with open(path, "w") as f:
    f.write(edited_content)

upload_file(repo_id=repo_id, path_in_repo=local_path, repo_type="dataset")
Чтобы иметь локально весь репозиторий датасета и редактировать множество файлов одновременно, используйте
snapshot_downloadиupload_folderвместоhf_hub_downloadиupload_file
Ознакомьтесь с документацией клиентской библиотеки, чтобы узнать больше.
Интегрированные библиотеки
Если набор данных на Hub совместим с поддерживаемой библиотекой, загрузка, редактирование и публикация набора данных занимают всего несколько строк.
Вот как редактировать файл CSV с помощью Pandas:
import pandas as pd

# Load the dataset
df = pd.read_csv(f"hf://datasets/{repo_id}/data.csv")

# Edit
df = df.apply(...)

# Commit the changes
df.to_csv(f"hf://datasets/{repo_id}/data.csv")
Библиотеки, такие как Polars и DuckDB, также реализуют протокол hf:// для чтения, редактирования и записи файлов на Hugging Face. А другие библиотеки полезны для редактирования наборов данных, состоящих из множества файлов, например Spark, Dask или 🤗 Datasets. Полный список поддерживаемых библиотек — здесь
Чтобы узнать, как получить доступ к набору данных на сайте, нажмите кнопку «Use this dataset» на странице набора данных.
Например, samsum показывает, как это сделать с помощью 🤗 Datasets ниже.



Загружайте только новые данные
Хранилище Hugging Face работает на базе Xet, который использует дедупликацию чанков для повышения эффективности загрузки. В отличие от традиционного облачного хранилища, Xet не требует повторной загрузки всего набора данных для фиксации изменений. Вместо этого он автоматически определяет, какие части набора данных были изменены, и указывает клиентской библиотеке загрузить только обновлённые части. Для этого Xet использует умный алгоритм для поиска чанков размером 64 КБ, которые уже существуют на Hugging Face.
Рассмотрим наш предыдущий пример с Pandas:
import pandas as pd

# Load the dataset
df = pd.read_csv(f"hf://datasets/{repo_id}/data.csv")

# Edit part of the dataset
df = df.apply(...)

# Commit the changes
df.to_csv(f"hf://datasets/{repo_id}/data.csv")
Этот код сначала загружает набор данных, а затем вносит в него изменения.
После завершения правок to_csv() материализует файл в памяти, разбивает его на блоки, запрашивает у Xet информацию о том, какие блоки уже находятся на Hugging Face, а какие были изменены, и затем загружает только новые данные.
Оптимизированное редактирование Parquet
Объем данных для загрузки зависит от внесенных изменений и структуры файлов.
Формат Parquet является колоночным и сжимается на уровне страниц (страницы имеют размер около ~1 МБ). Мы оптимизировали Parquet для Xet с помощью Parquet Content Defined Chunking, что обеспечивает сохранение неизменности страниц при неизменности данных.
Например, этот код загружает содержимое df, а затем для edited_df загрузка происходит быстрее, так как загружаются только изменённые блоки:
import pandas as pd

df.to_parquet(
    "hf://datasets/username/my_dataset/imdb.parquet",
    # Optimize for Xet
    use_content_defined_chunking=True,
    write_page_index=True,
)

edited_df = ...  # e.g. with added/modified/removed rows or columns

edited_df.to_parquet(
    "hf://datasets/username/my_dataset/imdb.parquet",
    # Optimize for Xet
    use_content_defined_chunking=True,
    write_page_index=True,
)
Размер чанков составляет ~64 КБ, а Parquet сохраняет данные по столбцам, поэтому на практике при редактировании файла Optimized Parquet происходит следующее:
- добавить новый столбец -> загружаются только фрагменты нового столбца
- добавление/редактирование/удаление строки -> загружается один чанк на столбец
Кроме того, загружаются и фрагменты подвала Parquet, содержащие метаданные.
Проверьте, поддерживает ли ваша библиотека Optimized Parquet, на странице поддерживаемые библиотеки.
Потоковая передача
Для больших наборов данных рекомендуются библиотеки с поддержкой потоковой обработки данных для сквозных потоковых конвейеров. В этом случае обработка набора данных выполняется постепенно по мере поступления старых данных и загрузки новых данных в Hub.
Проверьте, поддерживает ли ваша библиотека потоковую передачу, на странице поддерживаемые библиотеки.
Update on GitHub