# 使用 AnimateDiff 进行文本到视频生成
## 概述
Yuwei Guo、Ceyuan Yang、Anyi Rao、Yaohui Wang、Yu Qiao、Dahua Lin、Bo Dai 的 [AnimateDiff:无需特定调优即可为您的个性化文本到图像扩散模型添加动画](https://huggingface.co/papers/2307.04725)
该论文的摘要如下:
*随着文生图模型(例如 Stable Diffusion)以及 DreamBooth 和 LoRA 等相应个性化技术的进步,每个人都能以可承受的成本将想象力转化为高质量图像。随后,业界对图像动画技术产生了巨大需求,以便将生成的静态图像与运动动态进一步结合。在本报告中,我们提出了一个实用框架,能够一劳永逸地为大多数现有的个性化文生图模型添加动画能力,从而省去针对特定模型的调优工作。该框架的核心在于向冻结的文生图模型中插入一个新初始化的运动建模模块,并在视频片段上对其进行训练,以蒸馏出合理的运动先验。训练完成后,只需注入该运动建模模块,从同一基础 T2I 模型派生的所有个性化版本即可轻松转变为文本驱动模型,生成多样化且个性化的动画图像。我们在多个公开的、具有代表性的个性化文生图模型上进行了评估,涵盖动漫图片和写实照片,并证明我们提出的框架有助于这些模型生成时间上平滑的动画片段,同时保持其输出的领域特征和多样性。代码和预训练权重将在 [this https URL](https://animatediff.github.io/) 公开提供。*
## 可用流水线
| 流水线 | 任务 | 演示
|---|---|:---:|
| [AnimateDiffPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py) | *使用 AnimateDiff 进行文本到视频生成* |
| [AnimateDiffControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py) | *使用 ControlNet 通过 AnimateDiff 实现可控的视频到视频生成* |
| [AnimateDiffSparseControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py) | *使用 SparseCtrl 通过 AnimateDiff 实现可控的视频到视频生成* |
| [AnimateDiffSDXLPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py) | *使用 AnimateDiff 进行视频到视频生成* |
| [AnimateDiffVideoToVideoPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py) | *使用 AnimateDiff 进行视频到视频生成* |
| [AnimateDiffVideoToVideoControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py) | *使用 ControlNet 和 AnimateDiff 进行视频到视频生成* |
## 可用的检查点
Motion Adapter 检查点可以在 [guoyww](https://huggingface.co/guoyww/) 下找到。这些检查点旨在与任何基于 Stable Diffusion 1.4/1.5 的模型配合使用。
## 使用示例
### AnimateDiffPipeline
AnimateDiff 需要配合 MotionAdapter 检查点和 Stable Diffusion 模型检查点使用。MotionAdapter 是一组 Motion Modules 的集合,负责在图像帧之间添加连贯的运动。这些模块应用于 Stable Diffusion UNet 中的 Resnet 和 Attention 块之后。
以下示例演示了如何使用 *MotionAdapter* 检查点,基于 StableDiffusion-1.4/1.5 在 Diffusers 中进行推理。
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
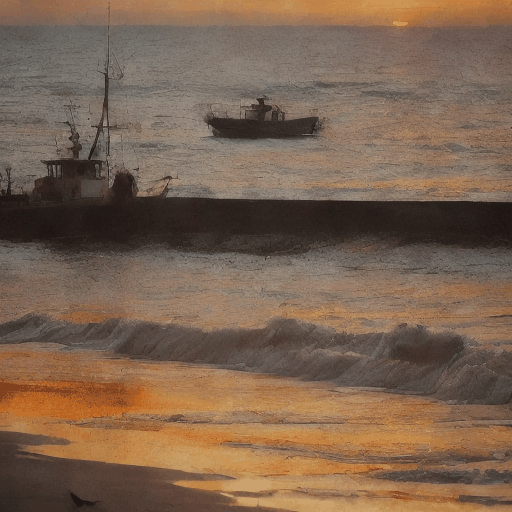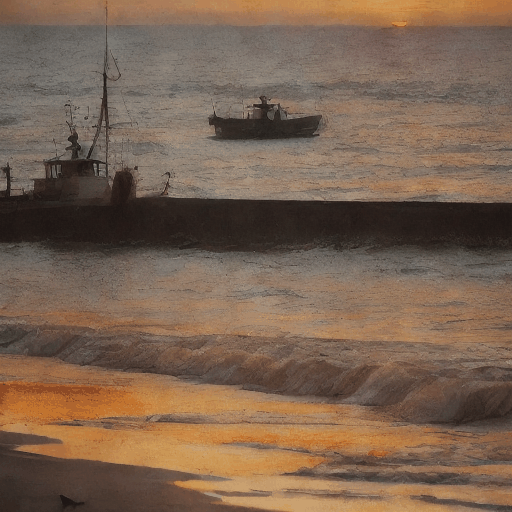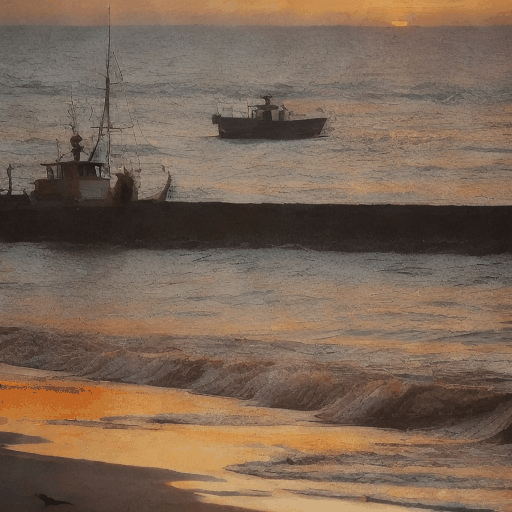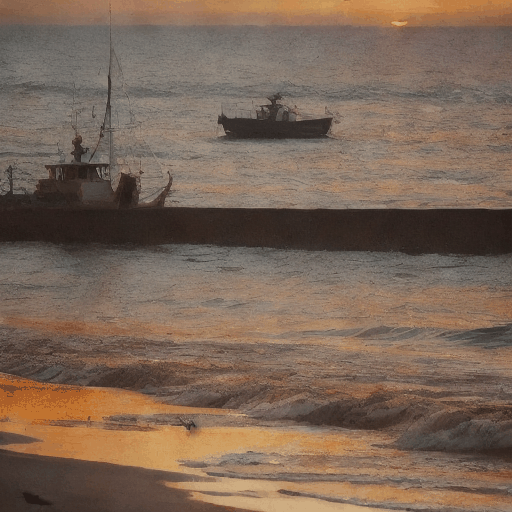
以下是一些示例输出:
杰作,最高质量,日落。
 > [!TIP]
> AnimateDiff 在使用经过微调的 Stable Diffusion 模型时通常表现更好。如果你计划使用能够裁剪样本的调度器,请通过在调度器中设置 `clip_sample=False` 来禁用该功能,因为这同样会对生成的样本产生不利影响。此外,AnimateDiff 的检查点对调度器的 beta 调度较为敏感。我们建议将其设置为 `linear`。
### AnimateDiffControlNetPipeline
AnimateDiff 也可以与 ControlNet 配合使用。ControlNet 由 Lvmin Zhang、Anyi Rao 和 Maneesh Agrawala 在 [Adding Conditional Control to Text-to-Image Diffusion Models](https://huggingface.co/papers/2302.05543) 中提出。借助 ControlNet 模型,您可以提供额外的控制图像,以调节并控制 Stable Diffusion 的生成过程。例如,如果您提供深度图,ControlNet 模型将生成保留深度图中空间信息的视频。这是一种更灵活、更精确地控制视频生成过程的方式。
```python
import torch
from diffusers import AnimateDiffControlNetPipeline, AutoencoderKL, ControlNetModel, MotionAdapter, LCMScheduler
from diffusers.utils import export_to_gif, load_video
# Additionally, you will need a preprocess videos before they can be used with the ControlNet
# HF maintains just the right package for it: `pip install controlnet_aux`
from controlnet_aux.processor import ZoeDetector
# Download controlnets from https://huggingface.co/lllyasviel/ControlNet-v1-1 to use .from_single_file
# Download Diffusers-format controlnets, such as https://huggingface.co/lllyasviel/sd-controlnet-depth, to use .from_pretrained()
controlnet = ControlNetModel.from_single_file("control_v11f1p_sd15_depth.pth", dtype=torch.float16)
# We use AnimateLCM for this example but one can use the original motion adapters as well (for example, https://huggingface.co/guoyww/animatediff-motion-adapter-v1-5-3)
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=torch.float16)
pipe: AnimateDiffControlNetPipeline = AnimateDiffControlNetPipeline.from_pretrained(
"SG161222/Realistic_Vision_V5.1_noVAE",
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
).to(device="cuda", dtype=torch.float16) # or "mps", "xpu", "cpu"
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm-lora")
pipe.set_adapters(["lcm-lora"], [0.8])
depth_detector = ZoeDetector.from_pretrained("lllyasviel/Annotators").to("cuda")
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-vid2vid-input-1.gif")
conditioning_frames = []
with pipe.progress_bar(total=len(video)) as progress_bar:
for frame in video:
conditioning_frames.append(depth_detector(frame))
progress_bar.update()
prompt = "a panda, playing a guitar, sitting in a pink boat, in the ocean, mountains in background, realistic, high quality"
negative_prompt = "bad quality, worst quality"
video = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_frames=len(video),
num_inference_steps=10,
guidance_scale=2.0,
conditioning_frames=conditioning_frames,
generator=torch.Generator().manual_seed(42),
).frames[0]
export_to_gif(video, "animatediff_controlnet.gif", fps=8)
```
以下是一些示例输出:
源视频 输出视频
浣熊弹吉他
一只熊猫,正在弹吉他,坐在一艘粉色的小船上,在海洋中,背景是山脉,写实风格,高质量
### AnimateDiffSparseControlNetPipeline
Yuwei Guo、Ceyuan Yang、Anyi Rao、Maneesh Agrawala、Dahua Lin 和 Bo Dai 提出的 [SparseCtrl: Adding Sparse Controls to Text-to-Video Diffusion Models](https://huggingface.co/papers/2311.16933),旨在为文本到视频扩散模型实现受控生成。
该论文的摘要如下:
*近年来,文本生成视频(T2V)技术,即根据给定的文本提示生成视频,取得了显著进展。然而,仅依赖文本提示往往会导致空间不确定性,从而造成模糊的帧构图。因此,研究界利用密集的结构信号(例如逐帧的深度/边缘序列)来增强可控性,但这相应地增加了推理的负担。在本工作中,我们提出了 SparseCtrl,它通过时间上稀疏的信号实现灵活的结构控制,仅需一个或少数几个输入,如图 1 所示。该方法引入一个额外的条件编码器来处理这些稀疏信号,同时保持预训练的 T2V 模型不变。所提出的方法兼容多种模态,包括草图、深度图和 RGB 图像,为视频生成提供了更实用的控制,并促进了分镜设计、深度渲染、关键帧动画和插值等应用。大量实验证明了 SparseCtrl 在原始和个性化 T2V 生成器上的泛化能力。代码和模型将在 [this https URL](https://guoyww.github.io/projects/SparseCtrl) 公开。*
SparseCtrl 引入了以下检查点,用于可控的文本到视频生成:
- [SparseCtrl Scribble](https://huggingface.co/guoyww/animatediff-sparsectrl-scribble)
- [SparseCtrl RGB](https://huggingface.co/guoyww/animatediff-sparsectrl-rgb)
#### 使用 SparseCtrl Scribble
```python
import torch
from diffusers import AnimateDiffSparseControlNetPipeline
from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
from diffusers.schedulers import DPMSolverMultistepScheduler
from diffusers.utils import export_to_gif, load_image
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
controlnet_id = "guoyww/animatediff-sparsectrl-scribble"
lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
vae_id = "stabilityai/sd-vae-ft-mse"
device = "cuda" # or "mps", "xpu", "cpu"
motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, dtype=torch.float16).to(device)
controlnet = SparseControlNetModel.from_pretrained(controlnet_id, dtype=torch.float16).to(device)
vae = AutoencoderKL.from_pretrained(vae_id, dtype=torch.float16).to(device)
scheduler = DPMSolverMultistepScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
algorithm_type="dpmsolver++",
use_karras_sigmas=True,
)
pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
model_id,
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
scheduler=scheduler,
dtype=torch.float16,
).to(device)
pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
pipe.fuse_lora(lora_scale=1.0)
prompt = "an aerial view of a cyberpunk city, night time, neon lights, masterpiece, high quality"
negative_prompt = "low quality, worst quality, letterboxed"
image_files = [
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-1.png",
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-2.png",
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-3.png"
]
condition_frame_indices = [0, 8, 15]
conditioning_frames = [load_image(img_file) for img_file in image_files]
video = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_inference_steps=25,
conditioning_frames=conditioning_frames,
controlnet_conditioning_scale=1.0,
controlnet_frame_indices=condition_frame_indices,
generator=torch.Generator().manual_seed(1337),
).frames[0]
export_to_gif(video, "output.gif")
```
以下是一些示例输出:
赛博朋克城市的鸟瞰图,夜晚,霓虹灯,杰作,高质量
#### 使用 SparseCtrl RGB
```python
import torch
from diffusers import AnimateDiffSparseControlNetPipeline
from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
from diffusers.schedulers import DPMSolverMultistepScheduler
from diffusers.utils import export_to_gif, load_image
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
controlnet_id = "guoyww/animatediff-sparsectrl-rgb"
lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
vae_id = "stabilityai/sd-vae-ft-mse"
device = "cuda" # or "mps", "xpu", "cpu"
motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, dtype=torch.float16).to(device)
controlnet = SparseControlNetModel.from_pretrained(controlnet_id, dtype=torch.float16).to(device)
vae = AutoencoderKL.from_pretrained(vae_id, dtype=torch.float16).to(device)
scheduler = DPMSolverMultistepScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
algorithm_type="dpmsolver++",
use_karras_sigmas=True,
)
pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
model_id,
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
scheduler=scheduler,
dtype=torch.float16,
).to(device)
pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-firework.png")
video = pipe(
prompt="closeup face photo of man in black clothes, night city street, bokeh, fireworks in background",
negative_prompt="low quality, worst quality",
num_inference_steps=25,
conditioning_frames=image,
controlnet_frame_indices=[0],
controlnet_conditioning_scale=1.0,
generator=torch.Generator().manual_seed(42),
).frames[0]
export_to_gif(video, "output.gif")
```
以下是一些示例输出:
身穿黑色衣服的男子面部特写照片,夜晚的城市街道,散景效果,背景中有烟花
### AnimateDiffSDXLPipeline
AnimateDiff 也可以与 SDXL 模型一起使用。目前这仍是一项实验性功能,因为运动适配器检查点仅提供了 beta 版本。
```python
import torch
from diffusers.models import MotionAdapter
from diffusers import AnimateDiffSDXLPipeline, DDIMScheduler
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-sdxl-beta", dtype=torch.float16)
model_id = "stabilityai/stable-diffusion-xl-base-1.0"
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe = AnimateDiffSDXLPipeline.from_pretrained(
model_id,
motion_adapter=adapter,
scheduler=scheduler,
dtype=torch.float16,
variant="fp16",
).to("cuda") # or "mps", "xpu", "cpu"
# enable memory savings
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()
output = pipe(
prompt="a panda surfing in the ocean, realistic, high quality",
negative_prompt="low quality, worst quality",
num_inference_steps=20,
guidance_scale=8,
width=1024,
height=1024,
num_frames=16,
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
### AnimateDiffVideoToVideoPipeline
AnimateDiff 还可以用于生成视觉上相似的视频,或基于初始视频实现风格、角色、背景或其他方面的编辑,从而让你无缝探索各种创意可能性。
```python
import imageio
import requests
import torch
from diffusers import AnimateDiffVideoToVideoPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
from io import BytesIO
from PIL import Image
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffVideoToVideoPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
# helper function to load videos
def load_video(file_path: str):
images = []
if file_path.startswith(('http://', 'https://')):
# If the file_path is a URL
response = requests.get(file_path)
response.raise_for_status()
content = BytesIO(response.content)
vid = imageio.get_reader(content)
else:
# Assuming it's a local file path
vid = imageio.get_reader(file_path)
for frame in vid:
pil_image = Image.fromarray(frame)
images.append(pil_image)
return images
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-vid2vid-input-1.gif")
output = pipe(
video = video,
prompt="panda playing a guitar, on a boat, in the ocean, high quality",
negative_prompt="bad quality, worse quality",
guidance_scale=7.5,
num_inference_steps=25,
strength=0.5,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
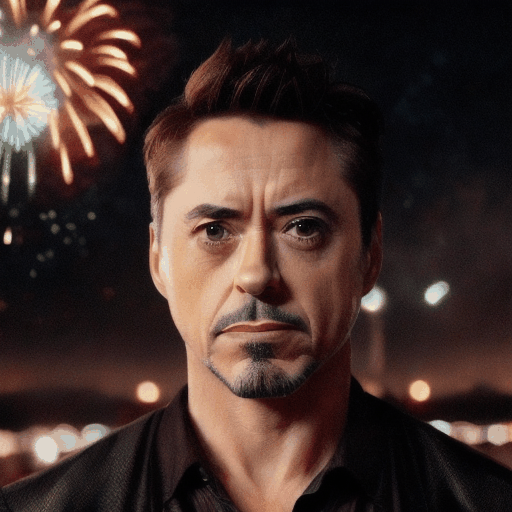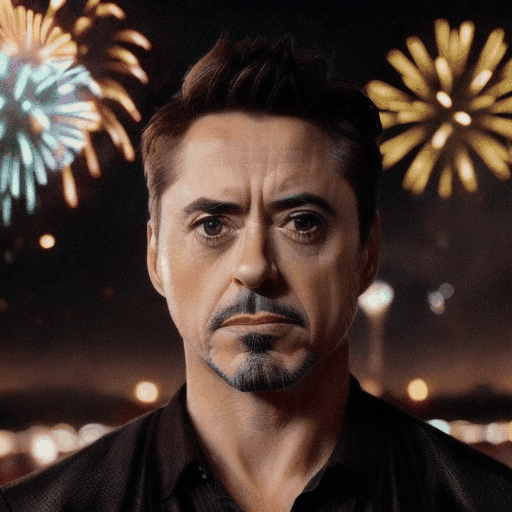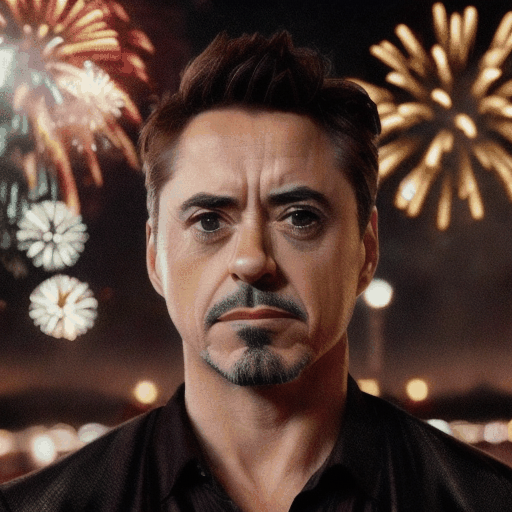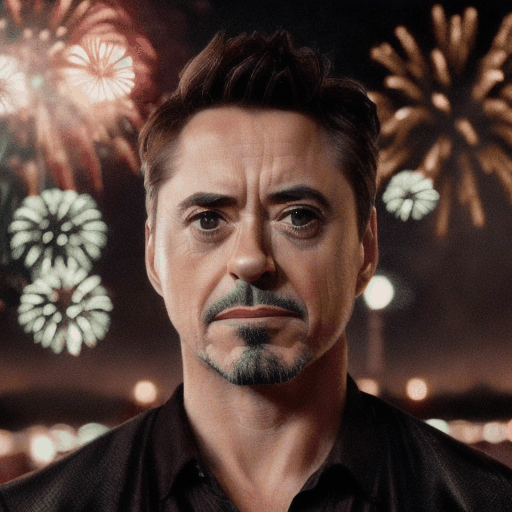
以下是一些示例输出:
源视频 输出视频
浣熊弹吉他
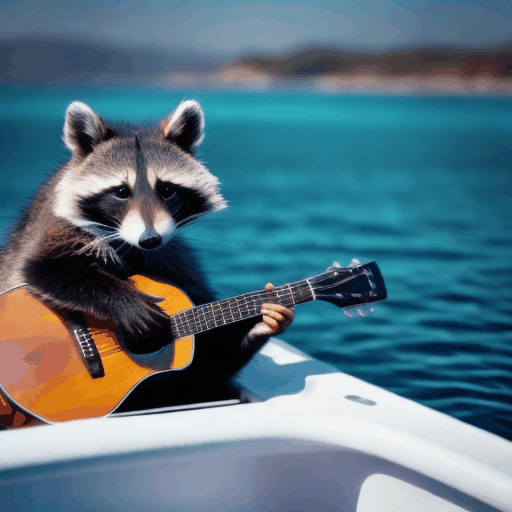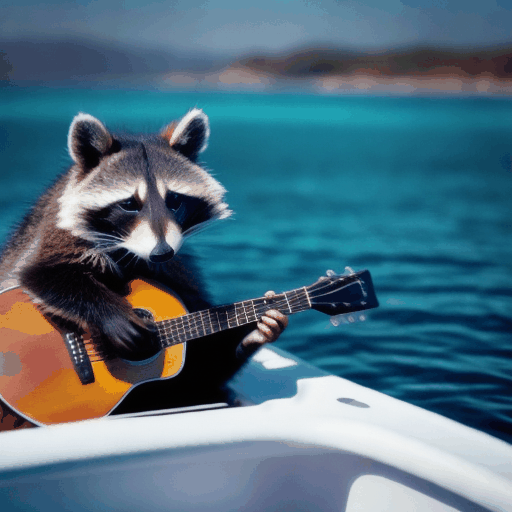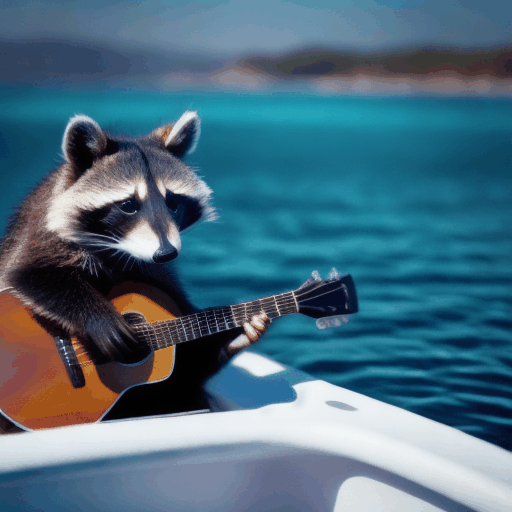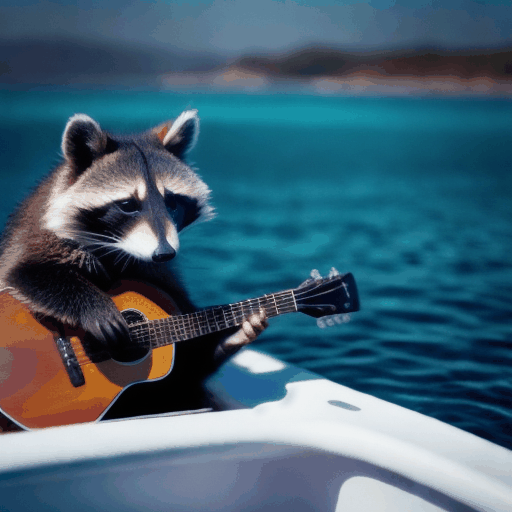 弹吉他的熊猫
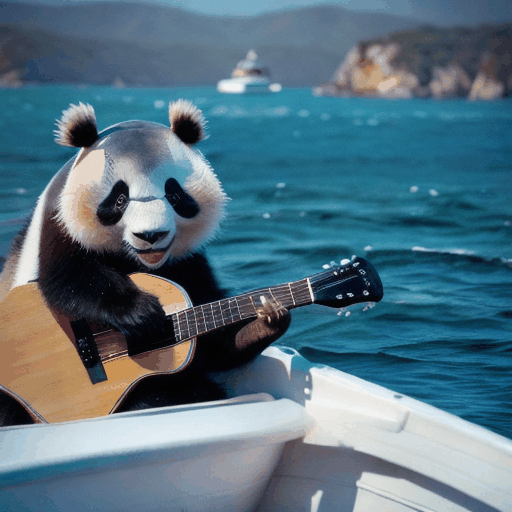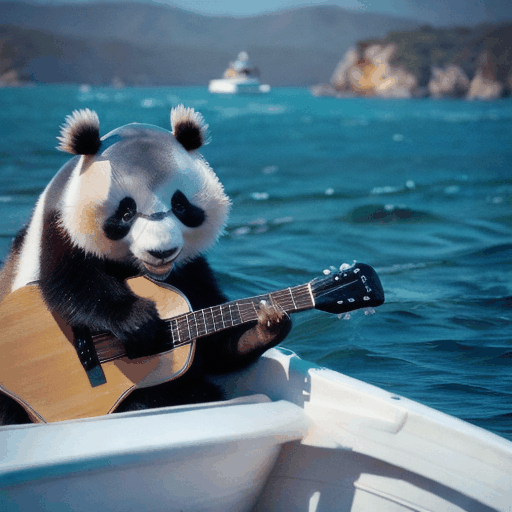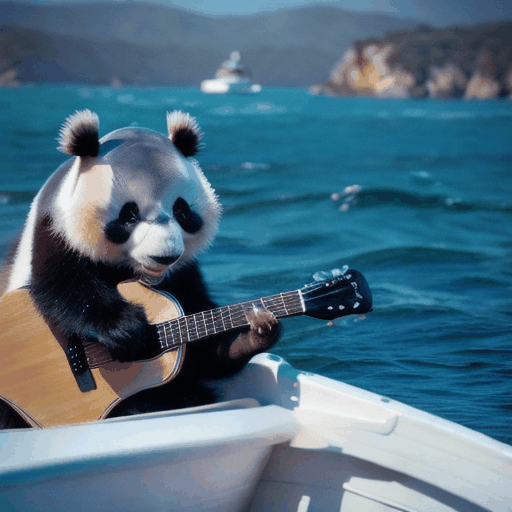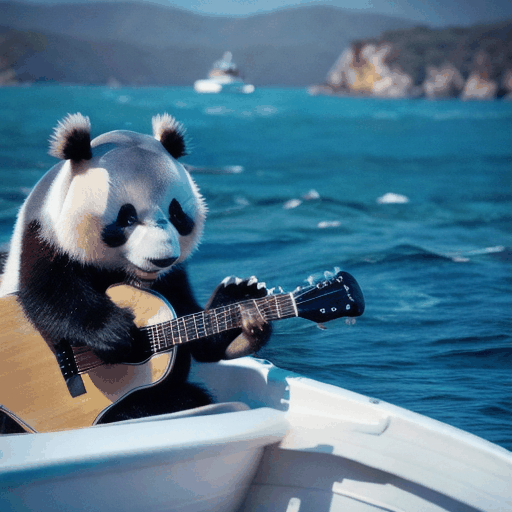 玛格特·罗比的特写,背景是烟花,高质量
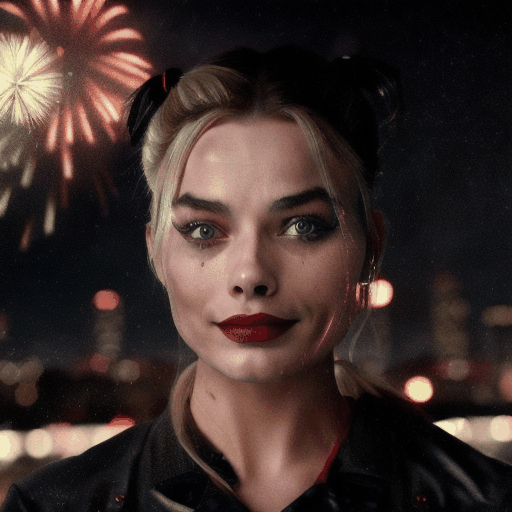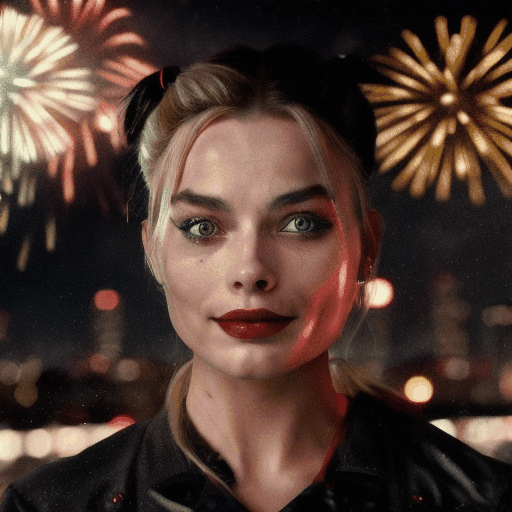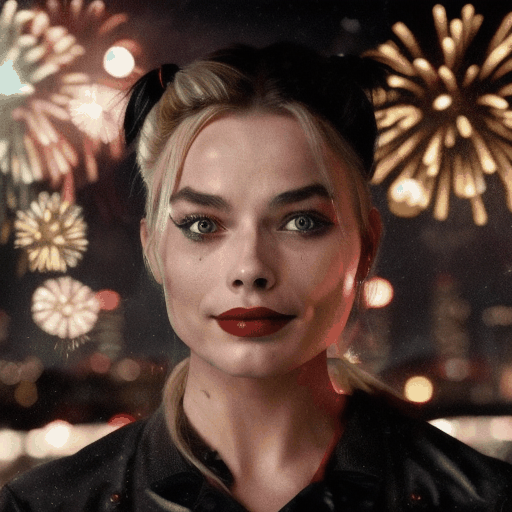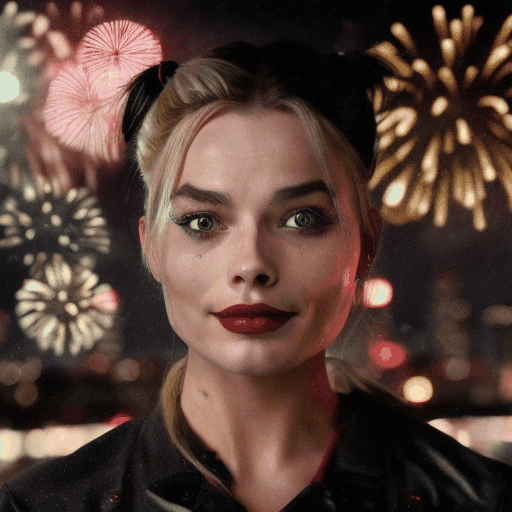 托尼·斯塔克、小罗伯特·唐尼的特写,烟花
 ### AnimateDiffVideoToVideoControlNetPipeline
AnimateDiff 可以与 ControlNet 配合使用,通过允许对输出进行精确控制来增强视频到视频的生成。ControlNet 由 Lvmin Zhang、Anyi Rao 和 Maneesh Agrawala 在 [Adding Conditional Control to Text-to-Image Diffusion Models](https://huggingface.co/papers/2302.05543) 中提出,它允许使用额外的控制图像对 Stable Diffusion 进行条件约束,以确保空间信息在整个视频中得以保留。
该流水线允许您同时基于原始视频和一系列控制图像来条件化您的生成过程。
```python
import torch
from PIL import Image
from tqdm.auto import tqdm
from controlnet_aux.processor import OpenposeDetector
from diffusers import AnimateDiffVideoToVideoControlNetPipeline
from diffusers.utils import export_to_gif, load_video
from diffusers import AutoencoderKL, ControlNetModel, MotionAdapter, LCMScheduler
# Load the ControlNet
controlnet = ControlNetModel.from_pretrained("lllyasviel/sd-controlnet-openpose", dtype=torch.float16)
# Load the motion adapter
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
# Load SD 1.5 based finetuned model
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=torch.float16)
pipe = AnimateDiffVideoToVideoControlNetPipeline.from_pretrained(
"SG161222/Realistic_Vision_V5.1_noVAE",
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
).to(device="cuda", dtype=torch.float16) # or "mps", "xpu", "cpu"
# Enable LCM to speed up inference
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm-lora")
pipe.set_adapters(["lcm-lora"], [0.8])
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/dance.gif")
video = [frame.convert("RGB") for frame in video]
prompt = "astronaut in space, dancing"
negative_prompt = "bad quality, worst quality, jpeg artifacts, ugly"
# Create controlnet preprocessor
open_pose = OpenposeDetector.from_pretrained("lllyasviel/Annotators").to("cuda")
# Preprocess controlnet images
conditioning_frames = []
for frame in tqdm(video):
conditioning_frames.append(open_pose(frame))
strength = 0.8
with torch.inference_mode():
video = pipe(
video=video,
prompt=prompt,
negative_prompt=negative_prompt,
num_inference_steps=10,
guidance_scale=2.0,
controlnet_conditioning_scale=0.75,
conditioning_frames=conditioning_frames,
strength=strength,
generator=torch.Generator().manual_seed(42),
).frames[0]
video = [frame.resize(conditioning_frames[0].size) for frame in video]
export_to_gif(video, f"animatediff_vid2vid_controlnet.gif", fps=8)
```
以下是一些示例输出:
源视频 输出视频
动漫女孩,跳舞
太空中的宇航员,正在跳舞
**灯光和构图是从源视频迁移过来的。**
## 使用 Motion LoRA
Motion LoRA 是一组与 `guoyww/animatediff-motion-adapter-v1-5-2` 检查点配合使用的 LoRA。这些 LoRA 负责为动画添加特定类型的运动。
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
pipe.load_lora_weights(
"guoyww/animatediff-motion-lora-zoom-out", adapter_name="zoom-out"
)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
beta_schedule="linear",
timestep_spacing="linspace",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
杰作,最高质量,日落。
 ## 使用 Motion LoRA 与 PEFT
您还可以利用 [PEFT](https://github.com/huggingface/peft) 后端来组合多个 Motion LoRA,从而创建更复杂的动画。
首先使用
```shell
pip install peft
```
然后,您可以使用以下代码来组合 Motion LoRA。
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
pipe.load_lora_weights(
"diffusers/animatediff-motion-lora-zoom-out", adapter_name="zoom-out",
)
pipe.load_lora_weights(
"diffusers/animatediff-motion-lora-pan-left", adapter_name="pan-left",
)
pipe.set_adapters(["zoom-out", "pan-left"], adapter_weights=[1.0, 1.0])
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
杰作,最高质量,日落。
 ## 使用 FreeInit
[FreeInit:弥合视频扩散模型中的初始化差距](https://huggingface.co/papers/2312.07537),作者:Tianxing Wu、Chenyang Si、Yuming Jiang、Ziqi Huang、Ziwei Liu。
FreeInit 是一种有效的方法,无需任何额外训练即可提升使用 video-diffusion-models 生成的视频的时间一致性和整体质量。它可以在推理阶段无缝地应用于 AnimateDiff、ModelScope、VideoCrafter 以及其他多种视频生成模型,其工作原理是迭代地优化潜在初始化噪声。更多详细信息请参阅该论文。
以下示例演示了 FreeInit 的使用方法。
```python
import torch
from diffusers import MotionAdapter, AnimateDiffPipeline, DDIMScheduler
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2")
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16).to("cuda") # or "mps", "xpu", "cpu"
pipe.scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
clip_sample=False,
timestep_spacing="linspace",
steps_offset=1
)
# enable memory savings
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()
# enable FreeInit
# Refer to the enable_free_init documentation for a full list of configurable parameters
pipe.enable_free_init(method="butterworth", use_fast_sampling=True)
# run inference
output = pipe(
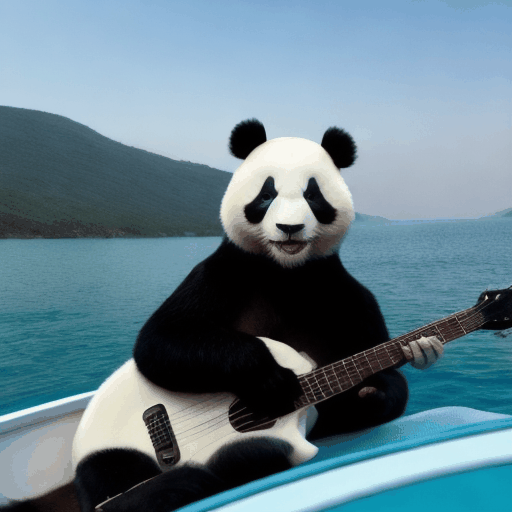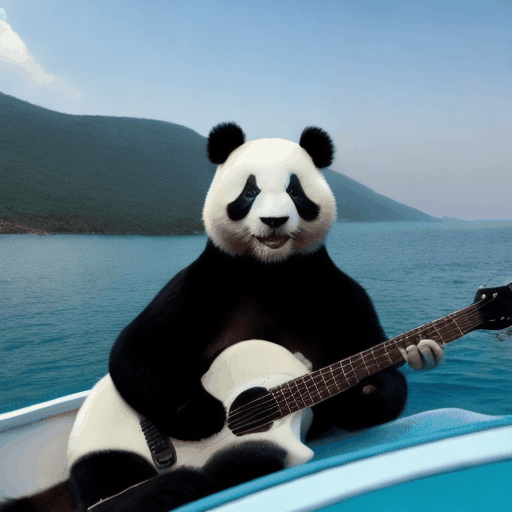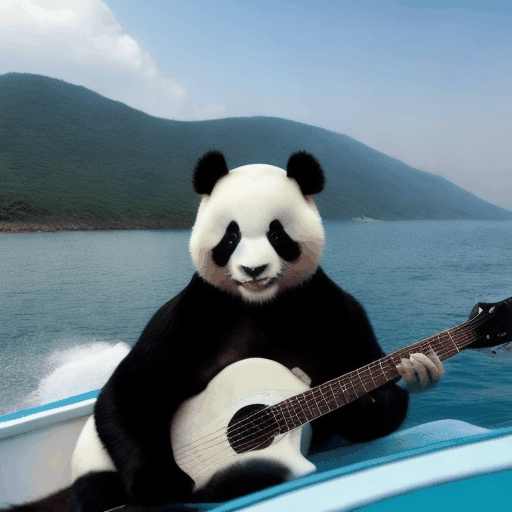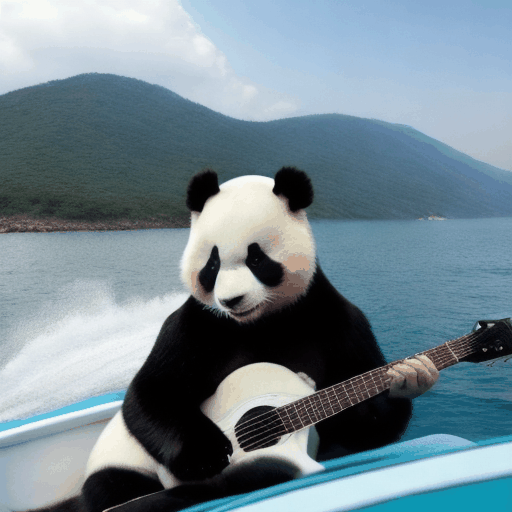
prompt="a panda playing a guitar, on a boat, in the ocean, high quality",
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=20,
generator=torch.Generator("cpu").manual_seed(666),
)
# disable FreeInit
pipe.disable_free_init()
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
> [!WARNING]
> FreeInit 并非真正“免费”——质量的提升是以额外的计算开销为代价的。启用该功能时,需要根据 `num_iters` 参数进行若干次额外的采样。将 `use_fast_sampling` 参数设置为 `True` 可以提升整体性能(与 `use_fast_sampling=False` 相比,质量会有所降低,但仍优于普通的视频生成模型)。
> [!TIP]
> 请务必参阅 [调度器指南](../../using-diffusers/schedulers),了解如何探索调度器速度与质量之间的权衡,并查看 [跨流水线复用组件](../../using-diffusers/loading#reusing-models-in-multiple-pipelines) 部分,了解如何高效地将相同组件加载到多个流水线中。
未启用 FreeInit 时 启用 FreeInit 后
弹吉他的熊猫
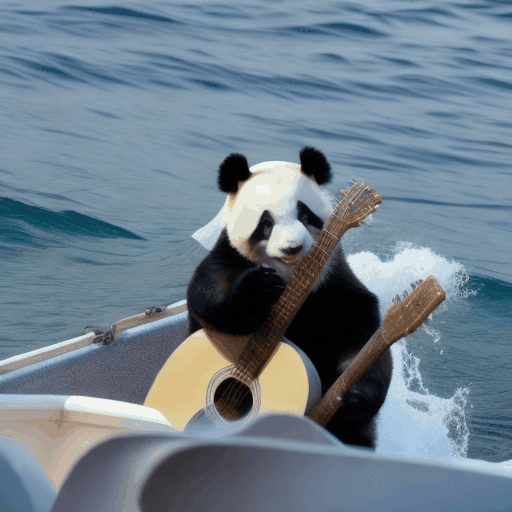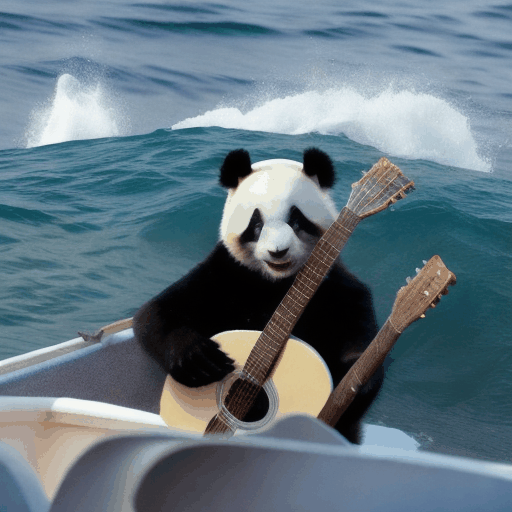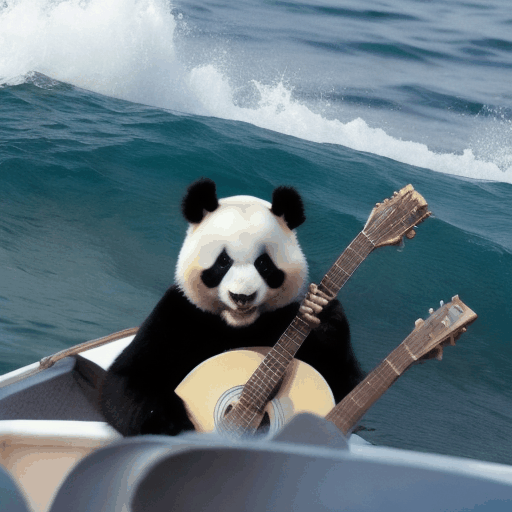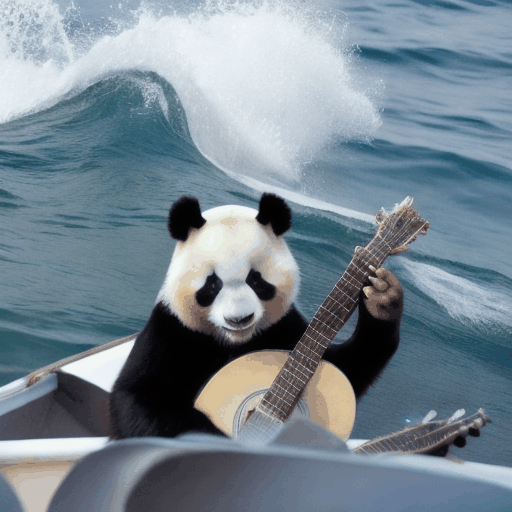 弹吉他的熊猫
 ## 使用 AnimateLCM
[AnimateLCM](https://animatelcm.github.io/) 是一个运动模块检查点和一个 [LCM LoRA](https://huggingface.co/docs/diffusers/using-diffusers/inference_with_lcm_lora),它们采用了一种一致性学习策略创建,该策略将图像生成先验与运动生成先验的蒸馏过程解耦。
```python
import torch
from diffusers import AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="sd15_lora_beta.safetensors", adapter_name="lcm-lora")
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt="A space rocket with trails of smoke behind it launching into space from the desert, 4k, high resolution",
negative_prompt="bad quality, worse quality, low resolution",
num_frames=16,
guidance_scale=1.5,
num_inference_steps=6,
generator=torch.Generator("cpu").manual_seed(0),
)
frames = output.frames[0]
export_to_gif(frames, "animatelcm.gif")
```
一枚太空火箭,4K。
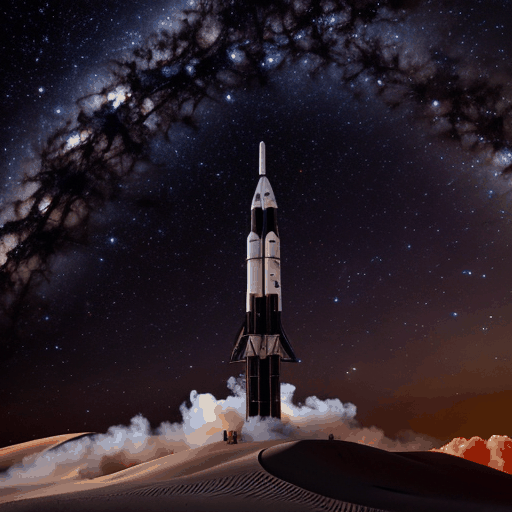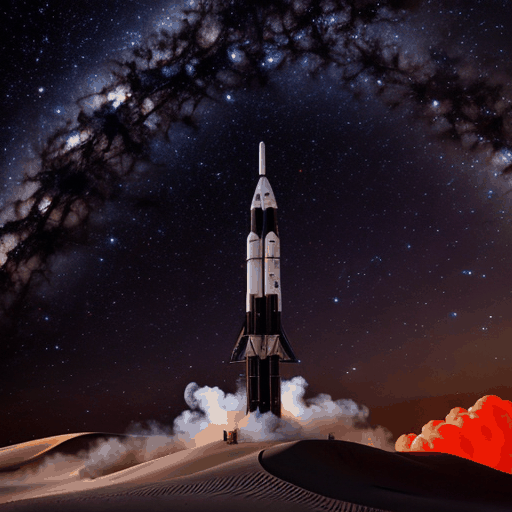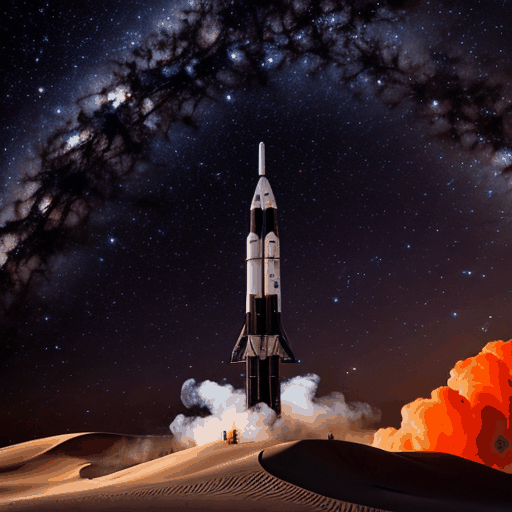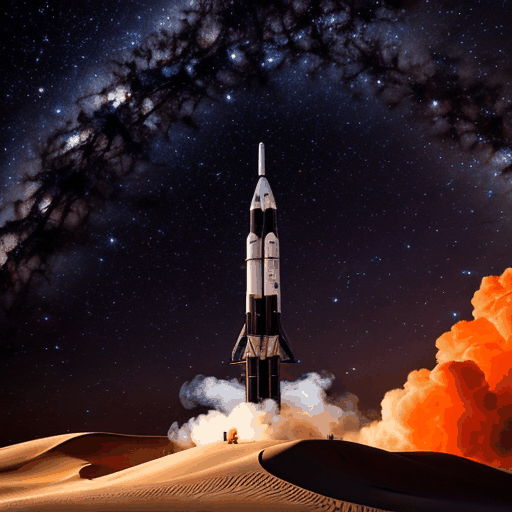 AnimateLCM 也兼容现有的 [Motion LoRAs](https://huggingface.co/collections/dn6/animatediff-motion-loras-654cb8ad732b9e3cf4d3c17e)。
```python
import torch
from diffusers import AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="sd15_lora_beta.safetensors", adapter_name="lcm-lora")
pipe.load_lora_weights("guoyww/animatediff-motion-lora-tilt-up", adapter_name="tilt-up")
pipe.set_adapters(["lcm-lora", "tilt-up"], [1.0, 0.8])
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt="A space rocket with trails of smoke behind it launching into space from the desert, 4k, high resolution",
negative_prompt="bad quality, worse quality, low resolution",
num_frames=16,
guidance_scale=1.5,
num_inference_steps=6,
generator=torch.Generator("cpu").manual_seed(0),
)
frames = output.frames[0]
export_to_gif(frames, "animatelcm-motion-lora.gif")
```
一枚太空火箭,4K。
 ## 使用 FreeNoise
[FreeNoise:通过噪声重调度实现免调优的更长视频扩散](https://huggingface.co/papers/2310.15169),作者:Haonan Qiu、Menghan Xia、Yong Zhang、Yingqing He、Xintao Wang、Ying Shan、Ziwei Liu。
FreeNoise 是一种采样机制,它通过采用噪声重调度、基于滑动窗口的时间注意力以及潜在帧的加权平均,能够利用短视频生成模型生成长视频。此外,它还可以结合多个提示词使用,以实现插值视频生成。更多详细信息请参阅相关论文。
目前支持且可与 FreeNoise 一起使用的 AnimateDiff 流水线包括:
- [AnimateDiffPipeline](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.AnimateDiffPipeline)
- [AnimateDiffControlNetPipeline](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.AnimateDiffControlNetPipeline)
- [AnimateDiffVideoToVideoPipeline](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.AnimateDiffVideoToVideoPipeline)
- [AnimateDiffVideoToVideoControlNetPipeline](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.AnimateDiffVideoToVideoControlNetPipeline)
要在推理代码中使用 FreeNoise,只需在加载流水线之后添加一行代码即可。
```diff
+ pipe.enable_free_noise()
```
在此之后,您可以使用单个提示,也可以将多个提示作为整数-字符串对的字典传入。字典中的整数键对应于该提示影响达到最大值的帧索引。每个帧索引应映射到一个字符串提示。对于未在字典中传入的中间帧索引,其提示将通过在已传入的帧提示之间进行插值来生成。默认情况下,使用简单的线性插值。不过,您可以在启用 FreeNoise 时,通过为 `prompt_interpolation_callback` 参数设置回调来自定义此行为。
完整示例:
```python
import torch
from diffusers import AutoencoderKL, AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_video, load_image
# Load pipeline
dtype = torch.float16
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM", dtype=dtype)
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=dtype)
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=motion_adapter, vae=vae, dtype=dtype)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights(
"wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm_lora"
)
pipe.set_adapters(["lcm_lora"], [0.8])
# Enable FreeNoise for long prompt generation
pipe.enable_free_noise(context_length=16, context_stride=4)
pipe.to("cuda") # or "mps", "xpu", "cpu"
# Can be a single prompt, or a dictionary with frame timesteps
prompt = {
0: "A caterpillar on a leaf, high quality, photorealistic",
40: "A caterpillar transforming into a cocoon, on a leaf, near flowers, photorealistic",
80: "A cocoon on a leaf, flowers in the background, photorealistic",
120: "A cocoon maturing and a butterfly being born, flowers and leaves visible in the background, photorealistic",
160: "A beautiful butterfly, vibrant colors, sitting on a leaf, flowers in the background, photorealistic",
200: "A beautiful butterfly, flying away in a forest, photorealistic",
240: "A cyberpunk butterfly, neon lights, glowing",
}
negative_prompt = "bad quality, worst quality, jpeg artifacts"
# Run inference
output = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_frames=256,
guidance_scale=2.5,
num_inference_steps=10,
generator=torch.Generator("cpu").manual_seed(0),
)
# Save video
frames = output.frames[0]
export_to_video(frames, "output.mp4", fps=16)
```
### FreeNoise 内存节省
由于 FreeNoise 会同时处理多个帧,模型中的某些部分所需的显存会超出普通消费级 GPU 的可用容量。我们识别出的主要显存瓶颈包括空间和时间注意力块、上采样和下采样块、resnet 块以及前馈层。由于这些块实际上主要仅在通道/嵌入维度上操作,因此可以沿批次维度执行分块推理。在 AnimateDiff 中,批次维度在本质上要么是空间的(`[B x F, H x W, C]`),要么是时间的(`B x H x W, F, C`)(请注意,这看起来可能有些反直觉,但这里的批次维度是正确的,因为空间块沿 `B x F` 维度进行处理,而时间块沿 `B x H x W` 维度进行处理)。我们引入了 `SplitInferenceModule`,以便更容易地沿任意维度进行分块并执行推理。这可以节省大量显存,但代价是推理所需的时间会增加。
```diff
# Load pipeline and adapters
# ...
+ pipe.enable_free_noise_split_inference()
+ pipe.unet.enable_forward_chunking(16)
```
对 `pipe.enable_free_noise_split_inference` 方法的调用接受两个参数:`spatial_split_size`(默认为 `256`)和 `temporal_split_size`(默认为 `16`)。这些参数可以根据可用的 VRAM 进行配置。较小的分割大小会降低内存使用量,但推理速度会变慢;而较大的分割大小会加快推理速度,但会消耗更多内存。
## 使用 `from_single_file` 与 MotionAdapter
`diffusers>=0.30.0` 支持通过 `from_single_file` 以原始格式将 AnimateDiff 检查点加载到 `MotionAdapter` 中。
```python
from diffusers import MotionAdapter
ckpt_path = "https://huggingface.co/Lightricks/LongAnimateDiff/blob/main/lt_long_mm_32_frames.ckpt"
adapter = MotionAdapter.from_single_file(ckpt_path, dtype=torch.float16)
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
```
## AnimateDiffPipeline[[diffusers.AnimateDiffPipeline]]
#### diffusers.AnimateDiffPipeline[[diffusers.AnimateDiffPipeline]]
```python
diffusers.AnimateDiffPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L78)
**参数:**
vae ([AutoencoderKL](/docs/diffusers/v0.43.0/zh/api/models/autoencoderkl#diffusers.AutoencoderKL)):变分自编码器(VAE)模型,用于将图像编码为潜在表示,并从潜在表示解码回图像。
text_encoder (`CLIPTextModel`):冻结的文本编码器([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14))。
tokenizer (`CLIPTokenizer`):一个用于对文本进行分词的 [CLIPTokenizer](https://huggingface.co/docs/transformers/v5.22.2/en/model_doc/clip#transformers.CLIPTokenizer)。
unet ([UNet2DConditionModel](/docs/diffusers/v0.43.0/zh/api/models/unet2d-cond#diffusers.UNet2DConditionModel)):用于创建 UNetMotionModel 以对编码后的视频潜变量进行去噪的 [UNet2DConditionModel](/docs/diffusers/v0.43.0/zh/api/models/unet2d-cond#diffusers.UNet2DConditionModel)。
motion_adapter (`MotionAdapter`):一个 `MotionAdapter`,与 `unet` 配合使用,以对编码后的视频潜变量进行去噪。
scheduler ([SchedulerMixin](/docs/diffusers/v0.43.0/zh/api/schedulers/overview#diffusers.SchedulerMixin)):用于与 `unet` 配合以去除编码后的图像潜变量噪声的调度器。可以是 [DDIMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/ddim#diffusers.DDIMScheduler)、[LMSDiscreteScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) 或 [PNDMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/pndm#diffusers.PNDMScheduler) 之一。
用于文本到视频生成的 Pipeline。
该模型继承自 [DiffusionPipeline](/docs/diffusers/v0.43.0/zh/api/pipelines/overview#diffusers.DiffusionPipeline)。有关为所有流水线实现的通用方法(下载、保存、在特定设备上运行等),请参阅父类文档。
该 pipeline 还继承了以下加载方法:
- 用于加载文本反转嵌入的 [load_textual_inversion()](/docs/diffusers/v0.43.0/zh/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion)
- 用于加载 LoRA 权重的 [load_lora_weights()](/docs/diffusers/v0.43.0/zh/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights)
- 用于保存 LoRA 权重的 [save_lora_weights()](/docs/diffusers/v0.43.0/zh/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights)
- 用于加载 IP Adapter 的 [load_ip_adapter()](/docs/diffusers/v0.43.0/zh/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter)
#### __调用__[[diffusers.AnimateDiffPipeline.__call__]]
```python
__call__(prompt: str | list[str] | None = None, num_frames: int | None = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'], decode_chunk_size: int = 16, **kwargs)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L571)
**参数:**
prompt (`str` 或 `list[str]`,*可选*):用于引导图像生成的提示词或提示词列表。如果未定义,则需要传入 `prompt_embeds`。
height (`int`,*可选*,默认为 `self.unet.config.sample_size * self.vae_scale_factor`):生成视频的高度(以像素为单位)。
width (`int`,*可选*,默认为 `self.unet.config.sample_size * self.vae_scale_factor`):生成视频的像素宽度。
num_frames (`int`,*可选*,默认为 16):生成的视频帧数。默认为 16 帧,按每秒 8 帧计算,相当于 2 秒的视频。
num_inference_steps (`int`,*可选*,默认值为 50):去噪步数。更多的去噪步数通常能生成更高质量的视频,但代价是推理速度变慢。
guidance_scale (`float`, *可选*,默认值为 7.5):较高的 guidance scale 值会促使模型生成与文本 `prompt` 紧密相关的图像,但代价是图像质量降低。当 `guidance_scale > 1` 时,guidance scale 生效。
negative_prompt (`str` 或 `list[str]`,*可选*):用于指导图像生成中不应包含的内容的提示词或提示词列表。如果未定义,则需要改为传入 `negative_prompt_embeds`。在未使用引导(`guidance_scale < 1`)时将被忽略。
num_videos_per_prompt (`int`,*可选*,默认为 1):每个提示词生成的视频数量。
eta (`float`,*可选*,默认值为 0.0):对应 [DDIM](https://huggingface.co/papers/2010.02502) 论文中的参数 eta (η)。仅适用于 [DDIMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/ddim#diffusers.DDIMScheduler),在其他调度器中会被忽略。
generator (`torch.Generator` 或 `list[torch.Generator]`,*可选*):用于使生成过程确定性的 [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html)。
latents (`torch.Tensor`, *可选*) : 从高斯分布中采样的预生成噪声潜变量,用作视频生成的输入。可用于使用不同的提示词对同一生成过程进行微调。如果未提供,则使用提供的随机`generator`进行采样来生成潜变量张量。潜变量的形状应为`(batch_size, num_channel, num_frames, height, width)`。
prompt_embeds (`torch.Tensor`, *可选*) : 预生成的文本嵌入。可用于轻松调整文本输入(提示词权重)。如果未提供,则从 `prompt` 输入参数生成文本嵌入。
negative_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的负向文本嵌入。可用于轻松调整文本输入(提示词权重)。如果未提供,`negative_prompt_embeds` 将从 `negative_prompt` 输入参数生成。
ip_adapter_image : (`PipelineImageInput`,*可选*):用于配合 IP Adapter 使用的可选图像输入。
ip_adapter_image_embeds (`list[torch.Tensor]`,*可选*):用于 IP-Adapter 的预生成图像嵌入。它应是一个列表,长度与 IP-Adapter 的数量相同。每个元素应为形状为 `(batch_size, num_images, emb_dim)` 的张量。如果 `do_classifier_free_guidance` 设置为 `True`,则应包含负向图像嵌入。如果未提供,嵌入将从 `ip_adapter_image` 输入参数计算得出。
output_type (`str`,*可选*,默认为 `"pil"`):生成视频的输出格式。可选 `torch.Tensor`、`PIL.Image` 或 `np.array`。
return_dict (`bool`,*可选*,默认为 `True`):是否返回 `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` 而不是普通元组。
cross_attention_kwargs (`dict`, *可选*) : 一个 kwargs 字典,如果指定,将作为 [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py) 中定义的 `AttentionProcessor` 的参数传递。
clip_skip (`int`, *可选*) : 在计算提示嵌入时,从 CLIP 中跳过的层数。值为 1 表示将使用倒数第二层的输出来计算提示嵌入。
callback_on_step_end (`Callable`,*可选*):一个在推理过程中每个去噪步骤结束时调用的函数。该函数以以下参数被调用:`callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`。`callback_kwargs` 将包含由 `callback_on_step_end_tensor_inputs` 指定的所有张量列表。
callback_on_step_end_tensor_inputs (`list`,*可选*):`callback_on_step_end` 函数的张量输入列表。列表中指定的张量将作为 `callback_kwargs` 参数传递。您只能包含流水线类的 `._callback_tensor_inputs` 属性中列出的变量。
decode_chunk_size (`int`,默认为 `16`):调用 `decode_latents` 方法时,每次解码的帧数。
**返回:** [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) 或 `tuple`
如果 `return_dict` 为 `True`,则返回 [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput);否则返回一个 `tuple`,其中第一个元素是包含生成帧的列表。
用于生成的 pipeline 的调用函数。
示例:
```py
>>> import torch
>>> from diffusers import MotionAdapter, AnimateDiffPipeline, DDIMScheduler
>>> from diffusers.utils import export_to_gif
>>> adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2")
>>> pipe = AnimateDiffPipeline.from_pretrained("frankjoshua/toonyou_beta6", motion_adapter=adapter)
>>> pipe.scheduler = DDIMScheduler(beta_schedule="linear", steps_offset=1, clip_sample=False)
>>> output = pipe(prompt="A corgi walking in the park")
>>> frames = output.frames[0]
>>> export_to_gif(frames, "animation.gif")
```
#### encode_prompt[[diffusers.AnimateDiffPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L154)
**参数:**
prompt (`str` 或 `list[str]`,*可选*):要编码的提示
device : (`torch.device`): torch 设备
num_images_per_prompt (`int`) : 每个提示词应生成的图像数量
do_classifier_free_guidance (`bool`) : 是否使用 classifier free guidance
negative_prompt (`str` 或 `list[str]`,*可选*):用于引导图像生成的负面提示词。如果未定义,则必须传入 `negative_prompt_embeds`。当不使用引导时(即 `guidance_scale` 小于 `1` 时),此参数将被忽略。
prompt_embeds (`torch.Tensor`, *可选*) : 预生成的文本嵌入。可用于轻松调整文本输入,*例如* 提示词加权。如果未提供,文本嵌入将从 `prompt` 输入参数生成。
negative_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的负向文本嵌入。可用于轻松调整文本输入,*例如* 提示词权重。如果未提供,negative_prompt_embeds 将从 `negative_prompt` 输入参数生成。
lora_scale (`float`, *可选*) : 如果加载了 LoRA 层,将应用于文本编码器所有 LoRA 层的 LoRA 缩放系数。
clip_skip (`int`, *可选*) : 在计算提示嵌入时,从 CLIP 中跳过的层数。值为 1 表示将使用倒数第二层的输出来计算提示嵌入。
将提示词编码为文本编码器的隐藏状态。
## AnimateDiffControlNetPipeline[[diffusers.AnimateDiffControlNetPipeline]]
#### diffusers.AnimateDiffControlNetPipeline[[diffusers.AnimateDiffControlNetPipeline]]
```python
diffusers.AnimateDiffControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: diffusers.models.controlnets.controlnet.ControlNetModel | list[diffusers.models.controlnets.controlnet.ControlNetModel] | tuple[diffusers.models.controlnets.controlnet.ControlNetModel] | diffusers.models.controlnets.multicontrolnet.MultiControlNetModel, scheduler: KarrasDiffusionSchedulers, feature_extractor: transformers.models.clip.image_processing_pil_clip.CLIPImageProcessorPil | None = None, image_encoder: transformers.models.clip.modeling_clip.CLIPVisionModelWithProjection | None = None)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L120)
**参数:**
vae ([AutoencoderKL](/docs/diffusers/v0.43.0/zh/api/models/autoencoderkl#diffusers.AutoencoderKL)):变分自编码器(VAE)模型,用于将图像编码为潜在表示,并从潜在表示解码回图像。
text_encoder (`CLIPTextModel`):冻结的文本编码器([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14))。
tokenizer (`CLIPTokenizer`):一个用于对文本进行分词的 [CLIPTokenizer](https://huggingface.co/docs/transformers/v5.22.2/en/model_doc/clip#transformers.CLIPTokenizer)。
unet ([UNet2DConditionModel](/docs/diffusers/v0.43.0/zh/api/models/unet2d-cond#diffusers.UNet2DConditionModel)):用于创建 UNetMotionModel 以对编码后的视频潜变量进行去噪的 [UNet2DConditionModel](/docs/diffusers/v0.43.0/zh/api/models/unet2d-cond#diffusers.UNet2DConditionModel)。
motion_adapter (`MotionAdapter`):一个 `MotionAdapter`,与 `unet` 配合使用,以对编码后的视频潜变量进行去噪。
scheduler ([SchedulerMixin](/docs/diffusers/v0.43.0/zh/api/schedulers/overview#diffusers.SchedulerMixin)):用于与 `unet` 配合以去除编码后的图像潜变量噪声的调度器。可以是 [DDIMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/ddim#diffusers.DDIMScheduler)、[LMSDiscreteScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) 或 [PNDMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/pndm#diffusers.PNDMScheduler) 之一。
用于在 ControlNet 引导下进行文本到视频生成的 Pipeline。
该模型继承自 [DiffusionPipeline](/docs/diffusers/v0.43.0/zh/api/pipelines/overview#diffusers.DiffusionPipeline)。有关为所有流水线实现的通用方法(下载、保存、在特定设备上运行等),请参阅父类文档。
该 pipeline 还继承了以下加载方法:
- 用于加载文本反转嵌入的 [load_textual_inversion()](/docs/diffusers/v0.43.0/zh/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion)
- 用于加载 LoRA 权重的 [load_lora_weights()](/docs/diffusers/v0.43.0/zh/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights)
- 用于保存 LoRA 权重的 [save_lora_weights()](/docs/diffusers/v0.43.0/zh/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights)
- 用于加载 IP Adapter 的 [load_ip_adapter()](/docs/diffusers/v0.43.0/zh/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter)
#### __调用__[[diffusers.AnimateDiffControlNetPipeline.__call__]]
```python
__call__(prompt: str | list[str] = None, num_frames: int | None = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, guess_mode: bool = False, control_guidance_start: float | list[float] = 0.0, control_guidance_end: float | list[float] = 1.0, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'], decode_chunk_size: int = 16)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L721)
**参数:**
prompt (`str` 或 `list[str]`,*可选*):用于引导图像生成的提示词或提示词列表。如果未定义,则需要传入 `prompt_embeds`。
height (`int`,*可选*,默认为 `self.unet.config.sample_size * self.vae_scale_factor`):生成视频的高度(以像素为单位)。
width (`int`,*可选*,默认为 `self.unet.config.sample_size * self.vae_scale_factor`):生成视频的像素宽度。
num_frames (`int`,*可选*,默认为 16):生成的视频帧数。默认为 16 帧,按每秒 8 帧计算,相当于 2 秒的视频。
num_inference_steps (`int`,*可选*,默认值为 50):去噪步数。更多的去噪步数通常能生成更高质量的视频,但代价是推理速度变慢。
guidance_scale (`float`, *可选*,默认值为 7.5):较高的 guidance scale 值会促使模型生成与文本 `prompt` 紧密相关的图像,但代价是图像质量降低。当 `guidance_scale > 1` 时,guidance scale 生效。
negative_prompt (`str` 或 `list[str]`,*可选*):用于指导图像生成中不应包含的内容的提示词或提示词列表。如果未定义,则需要改为传入 `negative_prompt_embeds`。在未使用引导(`guidance_scale < 1`)时将被忽略。
num_videos_per_prompt (`int`,*可选*,默认为 1):每个提示词生成的视频数量。
eta (`float`,*可选*,默认值为 0.0):对应 [DDIM](https://huggingface.co/papers/2010.02502) 论文中的参数 eta (η)。仅适用于 [DDIMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/ddim#diffusers.DDIMScheduler),在其他调度器中会被忽略。
generator (`torch.Generator` 或 `list[torch.Generator]`,*可选*):用于使生成过程确定性的 [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html)。
latents (`torch.Tensor`, *可选*) : 从高斯分布中采样的预生成噪声潜变量,用作视频生成的输入。可用于使用不同的提示词对同一生成过程进行微调。如果未提供,则使用提供的随机`generator`进行采样来生成潜变量张量。潜变量的形状应为`(batch_size, num_channel, num_frames, height, width)`。
prompt_embeds (`torch.Tensor`, *可选*) : 预生成的文本嵌入。可用于轻松调整文本输入(提示词权重)。如果未提供,则从 `prompt` 输入参数生成文本嵌入。
negative_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的负向文本嵌入。可用于轻松调整文本输入(提示词权重)。如果未提供,`negative_prompt_embeds` 将从 `negative_prompt` 输入参数生成。
ip_adapter_image (`PipelineImageInput`,*可选*):用于配合 IP Adapter 使用的可选图像输入。
ip_adapter_image_embeds (`list[torch.Tensor]`,*可选*):用于 IP-Adapter 的预生成图像嵌入。它应是一个列表,长度与 IP-Adapter 的数量相同。每个元素应为形状为 `(batch_size, num_images, emb_dim)` 的张量。如果 `do_classifier_free_guidance` 设置为 `True`,则应包含负向图像嵌入。如果未提供,嵌入将从 `ip_adapter_image` 输入参数计算得出。
conditioning_frames (`list[PipelineImageInput]`,*可选*):用于为 `unet` 提供生成引导的 ControlNet 输入条件。如果指定了多个 ControlNet,必须以列表形式传入图像,以便列表中的每个元素都能被正确批处理,作为单个 ControlNet 的输入。
output_type (`str`,*可选*,默认为 `"pil"`):生成视频的输出格式。可选 `torch.Tensor`、`PIL.Image` 或 `np.array`。
return_dict (`bool`,*可选*,默认为 `True`):是否返回 `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` 而不是普通元组。
cross_attention_kwargs (`dict`, *可选*) : 一个 kwargs 字典,如果指定,将作为 [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py) 中定义的 `AttentionProcessor` 的参数传递。
controlnet_conditioning_scale (`float` 或 `list[float]`,*可选*,默认为 1.0) : ControlNet 的输出在加到原始 `unet` 的残差之前,会先乘以 `controlnet_conditioning_scale`。如果在 `init` 中指定了多个 ControlNet,可以将对应的 scale 设置为列表。
guess_mode (`bool`,*可选*,默认为 `False`):即使移除所有提示词,ControlNet 编码器也会尝试识别输入图像的内容。建议将 `guidance_scale` 的值设置在 3.0 到 5.0 之间。
control_guidance_start (`float` 或 `list[float]`,*可选*,默认为 0.0):ControlNet 开始生效的总步数百分比。
control_guidance_end (`float` 或 `list[float]`,*可选*,默认为 1.0):ControlNet 停止应用时的总步数百分比。
clip_skip (`int`, *可选*) : 在计算提示嵌入时,从 CLIP 中跳过的层数。值为 1 表示将使用倒数第二层的输出来计算提示嵌入。
callback_on_step_end (`Callable`,*可选*):一个在推理过程中每个去噪步骤结束时调用的函数。该函数以以下参数被调用:`callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`。`callback_kwargs` 将包含由 `callback_on_step_end_tensor_inputs` 指定的所有张量列表。
callback_on_step_end_tensor_inputs (`list`,*可选*):`callback_on_step_end` 函数的张量输入列表。列表中指定的张量将作为 `callback_kwargs` 参数传递。您只能包含流水线类的 `._callback_tensor_inputs` 属性中列出的变量。
decode_chunk_size (`int`,默认为 `16`):调用 `decode_latents` 方法时,每次解码的帧数。
**返回:** [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) 或 `tuple`
如果 `return_dict` 为 `True`,则返回 [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput);否则返回一个 `tuple`,其中第一个元素是包含生成帧的列表。
用于生成的 pipeline 的调用函数。
示例:
#### encode_prompt[[diffusers.AnimateDiffControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L199)
**参数:**
prompt (`str` 或 `list[str]`,*可选*):要编码的提示
device : (`torch.device`): torch 设备
num_images_per_prompt (`int`) : 每个提示词应生成的图像数量
do_classifier_free_guidance (`bool`) : 是否使用 classifier free guidance
negative_prompt (`str` 或 `list[str]`,*可选*):用于引导图像生成的负面提示词。如果未定义,则必须传入 `negative_prompt_embeds`。当不使用引导时(即 `guidance_scale` 小于 `1` 时),此参数将被忽略。
prompt_embeds (`torch.Tensor`, *可选*) : 预生成的文本嵌入。可用于轻松调整文本输入,*例如* 提示词加权。如果未提供,文本嵌入将从 `prompt` 输入参数生成。
negative_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的负向文本嵌入。可用于轻松调整文本输入,*例如* 提示词权重。如果未提供,negative_prompt_embeds 将从 `negative_prompt` 输入参数生成。
lora_scale (`float`, *可选*) : 如果加载了 LoRA 层,将应用于文本编码器所有 LoRA 层的 LoRA 缩放系数。
clip_skip (`int`, *可选*) : 在计算提示嵌入时,从 CLIP 中跳过的层数。值为 1 表示将使用倒数第二层的输出来计算提示嵌入。
将提示词编码为文本编码器的隐藏状态。
## AnimateDiffSparseControlNetPipeline[[diffusers.AnimateDiffSparseControlNetPipeline]]
#### diffusers.AnimateDiffSparseControlNetPipeline[[diffusers.AnimateDiffSparseControlNetPipeline]]
```python
diffusers.AnimateDiffSparseControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: SparseControlNetModel, scheduler: KarrasDiffusionSchedulers, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L132)
**参数:**
vae ([AutoencoderKL](/docs/diffusers/v0.43.0/zh/api/models/autoencoderkl#diffusers.AutoencoderKL)):变分自编码器(VAE)模型,用于将图像编码为潜在表示,并从潜在表示解码回图像。
text_encoder (`CLIPTextModel`):冻结的文本编码器([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14))。
tokenizer (`CLIPTokenizer`):一个用于对文本进行分词的 [CLIPTokenizer](https://huggingface.co/docs/transformers/v5.22.2/en/model_doc/clip#transformers.CLIPTokenizer)。
unet ([UNet2DConditionModel](/docs/diffusers/v0.43.0/zh/api/models/unet2d-cond#diffusers.UNet2DConditionModel)):用于创建 UNetMotionModel 以对编码后的视频潜变量进行去噪的 [UNet2DConditionModel](/docs/diffusers/v0.43.0/zh/api/models/unet2d-cond#diffusers.UNet2DConditionModel)。
motion_adapter (`MotionAdapter`):一个 `MotionAdapter`,与 `unet` 配合使用,以对编码后的视频潜变量进行去噪。
scheduler ([SchedulerMixin](/docs/diffusers/v0.43.0/zh/api/schedulers/overview#diffusers.SchedulerMixin)):用于与 `unet` 配合以去除编码后的图像潜变量噪声的调度器。可以是 [DDIMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/ddim#diffusers.DDIMScheduler)、[LMSDiscreteScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) 或 [PNDMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/pndm#diffusers.PNDMScheduler) 之一。
使用[SparseCtrl:为文本到视频扩散模型添加稀疏控制](https://huggingface.co/papers/2311.16933)中描述的方法,用于受控文本到视频生成的 Pipeline。
该模型继承自 [DiffusionPipeline](/docs/diffusers/v0.43.0/zh/api/pipelines/overview#diffusers.DiffusionPipeline)。有关为所有流水线实现的通用方法(下载、保存、在特定设备上运行等),请参阅父类文档。
该 pipeline 还继承了以下加载方法:
- 用于加载文本反转嵌入的 [load_textual_inversion()](/docs/diffusers/v0.43.0/zh/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion)
- 用于加载 LoRA 权重的 [load_lora_weights()](/docs/diffusers/v0.43.0/zh/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights)
- 用于保存 LoRA 权重的 [save_lora_weights()](/docs/diffusers/v0.43.0/zh/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights)
- 用于加载 IP Adapter 的 [load_ip_adapter()](/docs/diffusers/v0.43.0/zh/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter)
#### __调用__[[diffusers.AnimateDiffSparseControlNetPipeline.__call__]]
```python
__call__(prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_frames: int = 16, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, controlnet_frame_indices: list[int] = [0], guess_mode: bool = False, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'])
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L712)
**参数:**
prompt (`str` 或 `list[str]`,*可选*):用于引导图像生成的提示词或提示词列表。如果未定义,则需要传入 `prompt_embeds`。
height (`int`,*可选*,默认为 `self.unet.config.sample_size * self.vae_scale_factor`):生成视频的高度(以像素为单位)。
width (`int`,*可选*,默认为 `self.unet.config.sample_size * self.vae_scale_factor`):生成视频的像素宽度。
num_frames (`int`,*可选*,默认为 16):生成的视频帧数。默认为 16 帧,按每秒 8 帧计算,相当于 2 秒的视频。
num_inference_steps (`int`,*可选*,默认值为 50):去噪步数。更多的去噪步数通常能生成更高质量的视频,但代价是推理速度变慢。
guidance_scale (`float`, *可选*,默认值为 7.5):较高的 guidance scale 值会促使模型生成与文本 `prompt` 紧密相关的图像,但代价是图像质量降低。当 `guidance_scale > 1` 时,guidance scale 生效。
negative_prompt (`str` 或 `list[str]`,*可选*):用于指导图像生成中不应包含的内容的提示词或提示词列表。如果未定义,则需要改为传入 `negative_prompt_embeds`。在未使用引导(`guidance_scale < 1`)时将被忽略。
num_videos_per_prompt (`int`,*可选*,默认为 1):每个提示词生成的视频数量。
eta (`float`,*可选*,默认值为 0.0):对应 [DDIM](https://huggingface.co/papers/2010.02502) 论文中的参数 eta (η)。仅适用于 [DDIMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/ddim#diffusers.DDIMScheduler),在其他调度器中会被忽略。
generator (`torch.Generator` 或 `list[torch.Generator]`,*可选*):用于使生成过程确定性的 [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html)。
latents (`torch.Tensor`, *可选*) : 从高斯分布中采样的预生成噪声潜变量,用作视频生成的输入。可用于使用不同的提示词对同一生成过程进行微调。如果未提供,则使用提供的随机`generator`进行采样来生成潜变量张量。潜变量的形状应为`(batch_size, num_channel, num_frames, height, width)`。
prompt_embeds (`torch.Tensor`, *可选*) : 预生成的文本嵌入。可用于轻松调整文本输入(提示词权重)。如果未提供,则从 `prompt` 输入参数生成文本嵌入。
negative_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的负向文本嵌入。可用于轻松调整文本输入(提示词权重)。如果未提供,`negative_prompt_embeds` 将从 `negative_prompt` 输入参数生成。
ip_adapter_image : (`PipelineImageInput`,*可选*):用于配合 IP Adapter 使用的可选图像输入。
ip_adapter_image_embeds (`list[torch.Tensor]`,*可选*):用于 IP-Adapter 的预生成图像嵌入。它应是一个列表,长度与 IP-Adapter 的数量相同。每个元素应为形状为 `(batch_size, num_images, emb_dim)` 的张量。如果 `do_classifier_free_guidance` 设置为 `True`,则应包含负向图像嵌入。如果未提供,嵌入将从 `ip_adapter_image` 输入参数计算得出。
conditioning_frames (`list[PipelineImageInput]`,*可选*):用于为 `unet` 提供生成引导的 SparseControlNet 输入。
output_type (`str`,*可选*,默认为 `"pil"`):生成视频的输出格式。可选 `torch.Tensor`、`PIL.Image` 或 `np.array`。
return_dict (`bool`,*可选*,默认为 `True`):是否返回 `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` 而不是普通元组。
cross_attention_kwargs (`dict`, *可选*) : 一个 kwargs 字典,如果指定,将作为 [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py) 中定义的 `AttentionProcessor` 的参数传递。
controlnet_conditioning_scale (`float` 或 `list[float]`,*可选*,默认为 1.0) : ControlNet 的输出在加到原始 `unet` 的残差之前,会先乘以 `controlnet_conditioning_scale`。如果在 `init` 中指定了多个 ControlNet,可以将对应的 scale 设置为列表。
controlnet_frame_indices (`list[int]`) : 在生成过程中必须应用条件帧的索引位置。可以提供多个帧来引导模型生成具有相似结构的输出,此时 `unet` 可以为插值视频执行“填补空白”操作;也可以仅提供单个帧来表示预期的通用结构。其长度必须与 `conditioning_frames` 相同。
guess_mode (`bool`,*可选*,默认为 `False`):即使移除所有提示词,ControlNet 编码器也会尝试识别输入图像的内容。建议将 `guidance_scale` 的值设置在 3.0 到 5.0 之间。
clip_skip (`int`, *可选*) : 在计算提示嵌入时,从 CLIP 中跳过的层数。值为 1 表示将使用倒数第二层的输出来计算提示嵌入。
callback_on_step_end (`Callable`,*可选*):一个在推理过程中每个去噪步骤结束时调用的函数。该函数以以下参数被调用:`callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`。`callback_kwargs` 将包含由 `callback_on_step_end_tensor_inputs` 指定的所有张量列表。
callback_on_step_end_tensor_inputs (`list`,*可选*):`callback_on_step_end` 函数的张量输入列表。列表中指定的张量将作为 `callback_kwargs` 参数传递。您只能包含流水线类的 `._callback_tensor_inputs` 属性中列出的变量。
**返回:** [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) 或 `tuple`
如果 `return_dict` 为 `True`,则返回 [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput);否则返回一个 `tuple`,其中第一个元素是包含生成帧的列表。
用于生成的 pipeline 的调用函数。
示例:
```python
>>> import torch
>>> from diffusers import AnimateDiffSparseControlNetPipeline
>>> from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
>>> from diffusers.schedulers import DPMSolverMultistepScheduler
>>> from diffusers.utils import export_to_gif, load_image
>>> model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
>>> motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
>>> controlnet_id = "guoyww/animatediff-sparsectrl-scribble"
>>> lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
>>> vae_id = "stabilityai/sd-vae-ft-mse"
>>> device = "cuda"
>>> motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, torch_dtype=torch.float16).to(device)
>>> controlnet = SparseControlNetModel.from_pretrained(controlnet_id, torch_dtype=torch.float16).to(device)
>>> vae = AutoencoderKL.from_pretrained(vae_id, torch_dtype=torch.float16).to(device)
>>> scheduler = DPMSolverMultistepScheduler.from_pretrained(
... model_id,
... subfolder="scheduler",
... beta_schedule="linear",
... algorithm_type="dpmsolver++",
... use_karras_sigmas=True,
... )
>>> pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
... model_id,
... motion_adapter=motion_adapter,
... controlnet=controlnet,
... vae=vae,
... scheduler=scheduler,
... torch_dtype=torch.float16,
... ).to(device)
>>> pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
>>> pipe.fuse_lora(lora_scale=1.0)
>>> prompt = "an aerial view of a cyberpunk city, night time, neon lights, masterpiece, high quality"
>>> negative_prompt = "low quality, worst quality, letterboxed"
>>> image_files = [
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-1.png",
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-2.png",
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-3.png",
... ]
>>> condition_frame_indices = [0, 8, 15]
>>> conditioning_frames = [load_image(img_file) for img_file in image_files]
>>> video = pipe(
... prompt=prompt,
... negative_prompt=negative_prompt,
... num_inference_steps=25,
... conditioning_frames=conditioning_frames,
... controlnet_conditioning_scale=1.0,
... controlnet_frame_indices=condition_frame_indices,
... generator=torch.Generator().manual_seed(1337),
... ).frames[0]
>>> export_to_gif(video, "output.gif")
```
#### encode_prompt[[diffusers.AnimateDiffSparseControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L208)
**参数:**
prompt (`str` 或 `list[str]`,*可选*):要编码的提示
device : (`torch.device`): torch 设备
num_images_per_prompt (`int`) : 每个提示词应生成的图像数量
do_classifier_free_guidance (`bool`) : 是否使用 classifier free guidance
negative_prompt (`str` 或 `list[str]`,*可选*):用于引导图像生成的负面提示词。如果未定义,则必须传入 `negative_prompt_embeds`。当不使用引导时(即 `guidance_scale` 小于 `1` 时),此参数将被忽略。
prompt_embeds (`torch.Tensor`, *可选*) : 预生成的文本嵌入。可用于轻松调整文本输入,*例如* 提示词加权。如果未提供,文本嵌入将从 `prompt` 输入参数生成。
negative_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的负向文本嵌入。可用于轻松调整文本输入,*例如* 提示词权重。如果未提供,negative_prompt_embeds 将从 `negative_prompt` 输入参数生成。
lora_scale (`float`, *可选*) : 如果加载了 LoRA 层,将应用于文本编码器所有 LoRA 层的 LoRA 缩放系数。
clip_skip (`int`, *可选*) : 在计算提示嵌入时,从 CLIP 中跳过的层数。值为 1 表示将使用倒数第二层的输出来计算提示嵌入。
将提示词编码为文本编码器的隐藏状态。
## AnimateDiffSDXLPipeline[[diffusers.AnimateDiffSDXLPipeline]]
#### diffusers.AnimateDiffSDXLPipeline[[diffusers.AnimateDiffSDXLPipeline]]
```python
diffusers.AnimateDiffSDXLPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, text_encoder_2: CLIPTextModelWithProjection, tokenizer: CLIPTokenizer, tokenizer_2: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, image_encoder: CLIPVisionModelWithProjection = None, feature_extractor: CLIPImageProcessorPil = None, force_zeros_for_empty_prompt: bool = True)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L210)
**参数:**
vae ([AutoencoderKL](/docs/diffusers/v0.43.0/zh/api/models/autoencoderkl#diffusers.AutoencoderKL)):变分自编码器(VAE)模型,用于将图像编码为潜在表示,并从潜在表示解码回图像。
text_encoder (`CLIPTextModel`):冻结的文本编码器。Stable Diffusion XL 使用 [CLIP](https://huggingface.co/docs/transformers/model_doc/clip#transformers.CLIPTextModel) 的文本部分,具体为 [clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14) 变体。
text_encoder_2 (` CLIPTextModelWithProjection`):第二个冻结的文本编码器。Stable Diffusion XL 使用 [CLIP](https://huggingface.co/docs/transformers/model_doc/clip#transformers.CLIPTextModelWithProjection) 的文本和池化部分,具体为 [laion/CLIP-ViT-bigG-14-laion2B-39B-b160k](https://huggingface.co/laion/CLIP-ViT-bigG-14-laion2B-39B-b160k) 变体。
tokenizer (`CLIPTokenizer`):[CLIPTokenizer](https://huggingface.co/docs/transformers/v4.21.0/en/model_doc/clip#transformers.CLIPTokenizer) 类的分词器。
tokenizer_2 (`CLIPTokenizer`):第二个 [CLIPTokenizer](https://huggingface.co/docs/transformers/v4.21.0/en/model_doc/clip#transformers.CLIPTokenizer) 类的 Tokenizer。
unet ([UNet2DConditionModel](/docs/diffusers/v0.43.0/zh/api/models/unet2d-cond#diffusers.UNet2DConditionModel)):用于对编码后的图像潜变量进行去噪的条件 U-Net 架构。
scheduler ([SchedulerMixin](/docs/diffusers/v0.43.0/zh/api/schedulers/overview#diffusers.SchedulerMixin)):用于与 `unet` 配合以去除编码后的图像潜变量噪声的调度器。可以是 [DDIMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/ddim#diffusers.DDIMScheduler)、[LMSDiscreteScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) 或 [PNDMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/pndm#diffusers.PNDMScheduler) 之一。
force_zeros_for_empty_prompt (`bool`,*可选*,默认为 `"True"`):是否强制将负提示嵌入始终设置为 0。另请参阅 `stabilityai/stable-diffusion-xl-base-1-0` 的配置。
使用 Stable Diffusion XL 进行文本到视频生成的 Pipeline。
该模型继承自 [DiffusionPipeline](/docs/diffusers/v0.43.0/zh/api/pipelines/overview#diffusers.DiffusionPipeline)。请查阅父类文档,了解该库为所有 pipeline 实现的通用方法(例如下载或保存、在特定设备上运行等)。
该 pipeline 还继承了以下加载方法:
- 用于加载文本反转嵌入的 [load_textual_inversion()](/docs/diffusers/v0.43.0/zh/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion)
- 用于加载 `.ckpt` 文件的 [from_single_file()](/docs/diffusers/v0.43.0/zh/api/loaders/single_file#diffusers.loaders.FromSingleFileMixin.from_single_file)
- 用于加载 LoRA 权重的 [load_lora_weights()](/docs/diffusers/v0.43.0/zh/api/loaders/lora#diffusers.loaders.StableDiffusionXLLoraLoaderMixin.load_lora_weights)
- 用于保存 LoRA 权重的 [save_lora_weights()](/docs/diffusers/v0.43.0/zh/api/loaders/lora#diffusers.loaders.StableDiffusionXLLoraLoaderMixin.save_lora_weights)
- 用于加载 IP Adapter 的 [load_ip_adapter()](/docs/diffusers/v0.43.0/zh/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter)
#### __调用__[[diffusers.AnimateDiffSDXLPipeline.__call__]]
```python
__call__(prompt: str | list[str] = None, prompt_2: str | list[str] | None = None, num_frames: int = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, timesteps: list[int] = None, sigmas: list[float] = None, denoising_end: float | None = None, guidance_scale: float = 5.0, negative_prompt: str | list[str] | None = None, negative_prompt_2: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, negative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, guidance_rescale: float = 0.0, original_size: tuple[int, int] | None = None, crops_coords_top_left: tuple[int, int] = (0, 0), target_size: tuple[int, int] | None = None, negative_original_size: tuple[int, int] | None = None, negative_crops_coords_top_left: tuple[int, int] = (0, 0), negative_target_size: tuple[int, int] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'])
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L869)
**参数:**
prompt (`str` 或 `list[str]`,*可选*):用于引导视频生成的提示词或提示词列表。如果未定义,则必须改为传入 `prompt_embeds`。
prompt_2 (`str` 或 `list[str]`,*可选*):要发送给 `tokenizer_2` 和 `text_encoder_2` 的提示词或提示词列表。如果未定义,则两个文本编码器均使用 `prompt`。
num_frames : 生成的视频帧数。默认为 16 帧,按每秒 8 帧计算,相当于 2 秒的视频。
height (`int`, *可选*,默认为 self.unet.config.sample_size * self.vae_scale_factor):生成视频的高度(以像素为单位)。默认设置为 1024 以获得最佳效果。对于 [stabilityai/stable-diffusion-xl-base-1.0](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0) 以及未在低分辨率上专门微调的检查点,低于 512 像素的效果不佳。
width (`int`,*可选*,默认为 self.unet.config.sample_size * self.vae_scale_factor):生成视频的像素宽度。默认设置为 1024 以获得最佳效果。对于 [stabilityai/stable-diffusion-xl-base-1.0](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0) 以及未在低分辨率上专门微调的检查点,低于 512 像素的宽度效果不佳。
num_inference_steps (`int`, *可选*,默认为 50):去噪步数。更多的去噪步数通常能带来更高质量的视频,但代价是推理速度变慢。
timesteps (`list[int]`,*可选*):用于在支持 `set_timesteps` 方法中 `timesteps` 参数的调度器中,指定去噪过程所使用的自定义时间步。如果未定义,则使用传入 `num_inference_steps` 时的默认行为。必须按降序排列。
sigmas (`list[float]`, *可选*) : 用于支持在 `set_timesteps` 方法中接受 `sigmas` 参数的调度器的去噪过程的自定义 sigmas。如果未定义,将使用传入 `num_inference_steps` 时的默认行为。
denoising_end (`float`, *可选*) : 指定时,确定在有意提前终止之前,总去噪过程需要完成的比例(介于 0.0 和 1.0 之间)。因此,返回的样本仍将保留相当多的噪声,具体程度由调度器选择的离散时间步决定。当此管道作为“去噪器混合”多管道设置的一部分时,应理想地使用 denoising_end 参数,如 [**优化图像输出**](https://huggingface.co/docs/diffusers/api/pipelines/stable_diffusion/stable_diffusion_xl#refining-the-image-output) 中所述。
guidance_scale (`float`,*可选*,默认值为 5.0):如[Classifier-Free Diffusion Guidance](https://huggingface.co/papers/2207.12598)中定义的引导尺度。`guidance_scale` 定义为[Imagen Paper](https://huggingface.co/papers/2205.11487)中公式 2 的 `w`。通过设置 `guidance_scale > 1` 来启用引导尺度。较高的引导尺度会促使生成与文本 `prompt` 紧密关联的图像,通常以牺牲视频质量为代价。
negative_prompt (`str` 或 `list[str]`,*可选*):用于引导视频生成的负面提示词或提示词列表。如果未定义,则必须传入 `negative_prompt_embeds`。在未使用引导时(即 `guidance_scale` 小于 `1` 时)将被忽略。
negative_prompt_2 (`str` 或 `list[str]`,*可选*):要发送给 `tokenizer_2` 和 `text_encoder_2` 的、用于引导视频生成的提示词或提示词列表。如果未定义,则两个文本编码器都会使用 `negative_prompt`。
num_videos_per_prompt (`int`,*可选*,默认为 1):每个提示词生成的视频数量。
eta (`float`,*可选*,默认值为 0.0):对应 DDIM 论文中的参数 eta (η):https://huggingface.co/papers/2010.02502。仅适用于 [schedulers.DDIMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/ddim#diffusers.DDIMScheduler),对其他调度器将被忽略。
generator (`torch.Generator` 或 `list[torch.Generator]`,*可选*):一个或一组 [torch 生成器](https://pytorch.org/docs/stable/generated/torch.Generator.html),用于使生成过程具有确定性。
latents (`torch.Tensor`, *可选*) : 预生成的噪声潜变量,从高斯分布中采样得到,用作视频生成的输入。可用于以不同的提示词微调同一生成过程。如果未提供,将通过使用提供的随机`generator`进行采样来生成潜变量张量。
prompt_embeds (`torch.Tensor`, *可选*) : 预生成的文本嵌入。可用于轻松调整文本输入,*例如* 提示词加权。如果未提供,文本嵌入将从 `prompt` 输入参数生成。
negative_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的负向文本嵌入。可用于轻松调整文本输入,*例如* 提示词权重。如果未提供,negative_prompt_embeds 将从 `negative_prompt` 输入参数生成。
pooled_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的池化文本嵌入。可用于轻松调整文本输入,*例如* 提示词加权。如果未提供,将从 `prompt` 输入参数生成池化文本嵌入。
negative_pooled_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的负向池化文本嵌入。可用于轻松调整文本输入,*例如* 提示词权重。如果未提供,将从 `negative_prompt` 输入参数生成 pooled negative_prompt_embeds。
ip_adapter_image : (`PipelineImageInput`,*可选*):用于配合 IP Adapter 使用的可选图像输入。
ip_adapter_image_embeds (`list[torch.Tensor]`, *可选*) : 为 IP-Adapter 预生成的图像嵌入。如果未提供,则从 `ip_adapter_image` 输入参数计算嵌入。
output_type (`str`,*可选*,默认为 `"pil"`):生成视频的输出格式。在 [PIL](https://pillow.readthedocs.io/en/stable/):`PIL.Image.Image` 或 `np.array` 之间选择。
return_dict (`bool`,*可选*,默认为 `True`):是否返回 `~pipelines.stable_diffusion_xl.AnimateDiffPipelineOutput` 而不是普通元组。
cross_attention_kwargs (`dict`, *可选*) : 一个 kwargs 字典,如果指定,将作为参数传递给 [diffusers.models.attention_processor](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py) 中 `self.processor` 下定义的 `AttentionProcessor`。
guidance_rescale (`float`, *optional*, defaults to 0.0) : Guidance rescale factor proposed by [Common Diffusion Noise Schedules and Sample Steps are Flawed](https://huggingface.co/papers/2305.08891) `guidance_scale` is defined as `φ` in equation 16. of [Common Diffusion Noise Schedules and Sample Steps are Flawed](https://huggingface.co/papers/2305.08891). Guidance rescale factor should fix overexposure when using zero terminal SNR.
original_size (`tuple[int]`,*可选*,默认为 (1024, 1024)):如果 `original_size` 与 `target_size` 不同,图像将看起来像是被下采样或上采样了。如果未指定,`original_size` 默认为 `(height, width)`。这是 SDXL 微条件的一部分,如 [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952) 第 2.2 节所述。
crops_coords_top_left (`tuple[int]`,*可选*,默认值为 (0, 0)):`crops_coords_top_left` 可用于生成一张看似从 `crops_coords_top_left` 位置向下裁剪的图像。通常将 `crops_coords_top_left` 设置为 (0, 0) 即可获得构图良好、居中效果佳的图像。这是 SDXL 微条件的一部分,详见 [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952) 中的第 2.2 节。
target_size (`tuple[int]`,*可选*,默认值为 (1024, 1024)):在大多数情况下,应将 `target_size` 设置为生成图像所需的宽度和高度。如果未指定,则默认为 `(height, width)`。这是 [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952) 第 2.2 节中所述 SDXL 微条件化的一部分。
negative_original_size (`tuple[int]`,*可选*,默认为 (1024, 1024)):用于基于特定的图像分辨率对生成过程进行负向条件控制。这是 SDXL 微条件化的一部分,如 [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952) 第 2.2 节所述。更多信息请参阅此 issue 讨论:https://github.com/huggingface/diffusers/issues/4208。
negative_crops_coords_top_left (`tuple[int]`,*可选*,默认值为 (0, 0)):用于根据特定的裁剪坐标对生成过程施加负向条件。这是 SDXL 微条件的一部分,详见 [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952) 中的第 2.2 节。更多信息请参阅此 issue 讨论:https://github.com/huggingface/diffusers/issues/4208。
negative_target_size (`tuple[int]`,*可选*,默认值为 (1024, 1024)):用于根据目标图像分辨率对生成过程施加负向条件。在大多数情况下,它应与 `target_size` 相同。这是 SDXL 微条件的一部分,如 [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952) 第 2.2 节所述。更多信息,请参阅此 issue 讨论:https://github.com/huggingface/diffusers/issues/4208。
clip_skip (`int`, *可选*) : 在计算提示嵌入时,从 CLIP 中跳过的层数。值为 1 表示将使用倒数第二层的输出来计算提示嵌入。
callback_on_step_end (`Callable`,*可选*):一个在推理过程中每个去噪步骤结束时调用的函数。该函数以以下参数被调用:`callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`。`callback_kwargs` 将包含由 `callback_on_step_end_tensor_inputs` 指定的所有张量列表。
callback_on_step_end_tensor_inputs (`list`,*可选*):`callback_on_step_end` 函数的张量输入列表。列表中指定的张量将作为 `callback_kwargs` 参数传递。您只能包含流水线类的 `._callback_tensor_inputs` 属性中列出的变量。
**返回:** [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) 或 `tuple`
如果 `return_dict` 为 `True`,则返回 [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput);否则返回一个 `tuple`,其中第一个元素是包含生成帧的列表。
调用生成 pipeline 时调用的函数。
示例:
```py
>>> import torch
>>> from diffusers.models import MotionAdapter
>>> from diffusers import AnimateDiffSDXLPipeline, DDIMScheduler
>>> from diffusers.utils import export_to_gif
>>> adapter = MotionAdapter.from_pretrained(
... "a-r-r-o-w/animatediff-motion-adapter-sdxl-beta", torch_dtype=torch.float16
... )
>>> model_id = "stabilityai/stable-diffusion-xl-base-1.0"
>>> scheduler = DDIMScheduler.from_pretrained(
... model_id,
... subfolder="scheduler",
... clip_sample=False,
... timestep_spacing="linspace",
... beta_schedule="linear",
... steps_offset=1,
... )
>>> pipe = AnimateDiffSDXLPipeline.from_pretrained(
... model_id,
... motion_adapter=adapter,
... scheduler=scheduler,
... torch_dtype=torch.float16,
... variant="fp16",
... ).to("cuda")
>>> # enable memory savings
>>> pipe.vae.enable_slicing()
>>> pipe.vae.enable_tiling()
>>> output = pipe(
... prompt="a panda surfing in the ocean, realistic, high quality",
... negative_prompt="low quality, worst quality",
... num_inference_steps=20,
... guidance_scale=8,
... width=1024,
... height=1024,
... num_frames=16,
... )
>>> frames = output.frames[0]
>>> export_to_gif(frames, "animation.gif")
```
#### encode_prompt[[diffusers.AnimateDiffSDXLPipeline.encode_prompt]]
```python
encode_prompt(prompt: str, prompt_2: str | None = None, device: typing.Optional[torch.device] = None, num_videos_per_prompt: int = 1, do_classifier_free_guidance: bool = True, negative_prompt: str | None = None, negative_prompt_2: str | None = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, negative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L327)
**参数:**
prompt (`str` 或 `list[str]`,*可选*):要编码的提示
prompt_2 (`str` 或 `list[str]`,*可选*):要发送给 `tokenizer_2` 和 `text_encoder_2` 的提示词或提示词列表。如果未定义,则两个文本编码器均使用 `prompt`。
device : (`torch.device`): torch 设备
num_videos_per_prompt (`int`) : 每个提示词应生成的图像数量
do_classifier_free_guidance (`bool`) : 是否使用 classifier free guidance
negative_prompt (`str` 或 `list[str]`,*可选*):用于引导图像生成的负面提示词。如果未定义,则必须传入 `negative_prompt_embeds`。当不使用引导时(即 `guidance_scale` 小于 `1` 时),此参数将被忽略。
negative_prompt_2 (`str` 或 `list[str]`,*可选*):要发送给 `tokenizer_2` 和 `text_encoder_2` 的提示词或提示词列表,用于引导图像生成。如果未定义,则两个文本编码器都会使用 `negative_prompt`。
prompt_embeds (`torch.Tensor`, *可选*) : 预生成的文本嵌入。可用于轻松调整文本输入,*例如* 提示词加权。如果未提供,文本嵌入将从 `prompt` 输入参数生成。
negative_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的负向文本嵌入。可用于轻松调整文本输入,*例如* 提示词权重。如果未提供,negative_prompt_embeds 将从 `negative_prompt` 输入参数生成。
pooled_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的池化文本嵌入。可用于轻松调整文本输入,*例如* 提示词加权。如果未提供,将从 `prompt` 输入参数生成池化文本嵌入。
negative_pooled_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的负向池化文本嵌入。可用于轻松调整文本输入,*例如* 提示词权重。如果未提供,将从 `negative_prompt` 输入参数生成 pooled negative_prompt_embeds。
lora_scale (`float`, *可选*) : 如果加载了 LoRA 层,将应用于文本编码器所有 LoRA 层的 LoRA 缩放系数。
clip_skip (`int`, *可选*) : 在计算提示嵌入时,从 CLIP 中跳过的层数。值为 1 表示将使用倒数第二层的输出来计算提示嵌入。
将提示词编码为文本编码器的隐藏状态。
#### get_guidance_scale_embedding[[diffusers.AnimateDiffSDXLPipeline.get_guidance_scale_embedding]]
```python
get_guidance_scale_embedding(w: Tensor, embedding_dim: int = 512, dtype: dtype = torch.float32)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L804)
**参数:**
w (`torch.Tensor`) : 生成具有指定 guidance scale 的嵌入向量,以用于后续丰富时间步嵌入。
embedding_dim (`int`,*可选*,默认值为 512):要生成的嵌入的维度。
dtype (`torch.dtype`,*可选*,默认为 `torch.float32`):生成嵌入的数据类型。
**返回:** `torch.Tensor`
形状为 `(len(w), embedding_dim)` 的嵌入向量。
参见 https://github.com/google-research/vdm/blob/dc27b98a554f65cdc654b800da5aa1846545d41b/model_vdm.py#L298
## AnimateDiffVideoToVideoPipeline[[diffusers.AnimateDiffVideoToVideoPipeline]]
#### diffusers.AnimateDiffVideoToVideoPipeline[[diffusers.AnimateDiffVideoToVideoPipeline]]
```python
diffusers.AnimateDiffVideoToVideoPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L181)
**参数:**
vae ([AutoencoderKL](/docs/diffusers/v0.43.0/zh/api/models/autoencoderkl#diffusers.AutoencoderKL)):变分自编码器(VAE)模型,用于将图像编码为潜在表示,并从潜在表示解码回图像。
text_encoder (`CLIPTextModel`):冻结的文本编码器([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14))。
tokenizer (`CLIPTokenizer`):一个用于对文本进行分词的 [CLIPTokenizer](https://huggingface.co/docs/transformers/v5.22.2/en/model_doc/clip#transformers.CLIPTokenizer)。
unet ([UNet2DConditionModel](/docs/diffusers/v0.43.0/zh/api/models/unet2d-cond#diffusers.UNet2DConditionModel)):用于创建 UNetMotionModel 以对编码后的视频潜变量进行去噪的 [UNet2DConditionModel](/docs/diffusers/v0.43.0/zh/api/models/unet2d-cond#diffusers.UNet2DConditionModel)。
motion_adapter (`MotionAdapter`):一个 `MotionAdapter`,与 `unet` 配合使用,以对编码后的视频潜变量进行去噪。
scheduler ([SchedulerMixin](/docs/diffusers/v0.43.0/zh/api/schedulers/overview#diffusers.SchedulerMixin)):用于与 `unet` 配合以去除编码后的图像潜变量噪声的调度器。可以是 [DDIMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/ddim#diffusers.DDIMScheduler)、[LMSDiscreteScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) 或 [PNDMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/pndm#diffusers.PNDMScheduler) 之一。
用于视频到视频生成的 Pipeline。
该模型继承自 [DiffusionPipeline](/docs/diffusers/v0.43.0/zh/api/pipelines/overview#diffusers.DiffusionPipeline)。有关为所有流水线实现的通用方法(下载、保存、在特定设备上运行等),请参阅父类文档。
该 pipeline 还继承了以下加载方法:
- 用于加载文本反转嵌入的 [load_textual_inversion()](/docs/diffusers/v0.43.0/zh/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion)
- 用于加载 LoRA 权重的 [load_lora_weights()](/docs/diffusers/v0.43.0/zh/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights)
- 用于保存 LoRA 权重的 [save_lora_weights()](/docs/diffusers/v0.43.0/zh/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights)
- 用于加载 IP Adapter 的 [load_ip_adapter()](/docs/diffusers/v0.43.0/zh/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter)
#### __调用__[[diffusers.AnimateDiffVideoToVideoPipeline.__call__]]
```python
__call__(video: list[list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]]] = None, prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, enforce_inference_steps: bool = False, timesteps: list[int] | None = None, sigmas: list[float] | None = None, guidance_scale: float = 7.5, strength: float = 0.8, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'], decode_chunk_size: int = 16)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L744)
**参数:**
video (`list[PipelineImageInput]`) : 用于条件生成的输入视频。必须是一个包含视频图像/帧的列表。
prompt (`str` 或 `list[str]`,*可选*):用于引导图像生成的提示词或提示词列表。如果未定义,则需要传入 `prompt_embeds`。
height (`int`,*可选*,默认为 `self.unet.config.sample_size * self.vae_scale_factor`):生成视频的高度(以像素为单位)。
width (`int`,*可选*,默认为 `self.unet.config.sample_size * self.vae_scale_factor`):生成视频的像素宽度。
num_inference_steps (`int`,*可选*,默认值为 50):去噪步数。更多的去噪步数通常能生成更高质量的视频,但代价是推理速度变慢。
enforce_inference_steps (`bool`,*可选*,默认为 `False`):是否强制使用 `num_inference_steps` 个去噪步骤,而不受 `strength` 参数的影响。当设置为 `False` 时,实际推理步数会根据 `strength` 进行缩减。
timesteps (`list[int]`,*可选*):用于在支持 `set_timesteps` 方法中 `timesteps` 参数的调度器中,指定去噪过程所使用的自定义时间步。如果未定义,则使用传入 `num_inference_steps` 时的默认行为。必须按降序排列。
sigmas (`list[float]`, *可选*) : 用于支持在 `set_timesteps` 方法中接受 `sigmas` 参数的调度器的去噪过程的自定义 sigmas。如果未定义,将使用传入 `num_inference_steps` 时的默认行为。
strength (`float`,*可选*,默认值为 0.8):强度越高,原始视频与生成视频之间的差异越大。
guidance_scale (`float`, *可选*,默认值为 7.5):较高的 guidance scale 值会促使模型生成与文本 `prompt` 紧密相关的图像,但代价是图像质量降低。当 `guidance_scale > 1` 时,guidance scale 生效。
negative_prompt (`str` 或 `list[str]`,*可选*):用于指导图像生成中不应包含的内容的提示词或提示词列表。如果未定义,则需要改为传入 `negative_prompt_embeds`。在未使用引导(`guidance_scale < 1`)时将被忽略。
num_videos_per_prompt (`int`,*可选*,默认为 1):每个提示词生成的视频数量。
eta (`float`,*可选*,默认值为 0.0):对应 [DDIM](https://huggingface.co/papers/2010.02502) 论文中的参数 eta (η)。仅适用于 [DDIMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/ddim#diffusers.DDIMScheduler),在其他调度器中会被忽略。
generator (`torch.Generator` 或 `list[torch.Generator]`,*可选*):用于使生成过程确定性的 [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html)。
latents (`torch.Tensor`, *可选*) : 从高斯分布中采样的预生成噪声潜变量,用作视频生成的输入。可用于使用不同的提示词对同一生成过程进行微调。如果未提供,则使用提供的随机`generator`进行采样来生成潜变量张量。潜变量的形状应为`(batch_size, num_channel, num_frames, height, width)`。
prompt_embeds (`torch.Tensor`, *可选*) : 预生成的文本嵌入。可用于轻松调整文本输入(提示词权重)。如果未提供,则从 `prompt` 输入参数生成文本嵌入。
negative_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的负向文本嵌入。可用于轻松调整文本输入(提示词权重)。如果未提供,`negative_prompt_embeds` 将从 `negative_prompt` 输入参数生成。
ip_adapter_image : (`PipelineImageInput`,*可选*):用于配合 IP Adapter 使用的可选图像输入。
ip_adapter_image_embeds (`list[torch.Tensor]`,*可选*):用于 IP-Adapter 的预生成图像嵌入。它应是一个列表,长度与 IP-Adapter 的数量相同。每个元素应为形状为 `(batch_size, num_images, emb_dim)` 的张量。如果 `do_classifier_free_guidance` 设置为 `True`,则应包含负向图像嵌入。如果未提供,嵌入将从 `ip_adapter_image` 输入参数计算得出。
output_type (`str`,*可选*,默认为 `"pil"`):生成视频的输出格式。可选 `torch.Tensor`、`PIL.Image` 或 `np.array`。
return_dict (`bool`,*可选*,默认为 `True`):是否返回 `AnimateDiffPipelineOutput` 而不是普通元组。
cross_attention_kwargs (`dict`, *可选*) : 一个 kwargs 字典,如果指定,将作为 [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py) 中定义的 `AttentionProcessor` 的参数传递。
clip_skip (`int`, *可选*) : 在计算提示嵌入时,从 CLIP 中跳过的层数。值为 1 表示将使用倒数第二层的输出来计算提示嵌入。
callback_on_step_end (`Callable`,*可选*):一个在推理过程中每个去噪步骤结束时调用的函数。该函数以以下参数被调用:`callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`。`callback_kwargs` 将包含由 `callback_on_step_end_tensor_inputs` 指定的所有张量列表。
callback_on_step_end_tensor_inputs (`list`,*可选*):`callback_on_step_end` 函数的张量输入列表。列表中指定的张量将作为 `callback_kwargs` 参数传递。您只能包含流水线类的 `._callback_tensor_inputs` 属性中列出的变量。
decode_chunk_size (`int`,默认为 `16`):调用 `decode_latents` 方法时,每次解码的帧数。
**返回:** [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) 或 `tuple`
如果 `return_dict` 为 `True`,则返回 [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput);否则返回一个 `tuple`,其中第一个元素是包含生成帧的列表。
用于生成的 pipeline 的调用函数。
示例:
#### encode_prompt[[diffusers.AnimateDiffVideoToVideoPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L256)
**参数:**
prompt (`str` 或 `list[str]`,*可选*):要编码的提示
device : (`torch.device`): torch 设备
num_images_per_prompt (`int`) : 每个提示词应生成的图像数量
do_classifier_free_guidance (`bool`) : 是否使用 classifier free guidance
negative_prompt (`str` 或 `list[str]`,*可选*):用于引导图像生成的负面提示词。如果未定义,则必须传入 `negative_prompt_embeds`。当不使用引导时(即 `guidance_scale` 小于 `1` 时),此参数将被忽略。
prompt_embeds (`torch.Tensor`, *可选*) : 预生成的文本嵌入。可用于轻松调整文本输入,*例如* 提示词加权。如果未提供,文本嵌入将从 `prompt` 输入参数生成。
negative_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的负向文本嵌入。可用于轻松调整文本输入,*例如* 提示词权重。如果未提供,negative_prompt_embeds 将从 `negative_prompt` 输入参数生成。
lora_scale (`float`, *可选*) : 如果加载了 LoRA 层,将应用于文本编码器所有 LoRA 层的 LoRA 缩放系数。
clip_skip (`int`, *可选*) : 在计算提示嵌入时,从 CLIP 中跳过的层数。值为 1 表示将使用倒数第二层的输出来计算提示嵌入。
将提示词编码为文本编码器的隐藏状态。
## AnimateDiffVideoToVideoControlNetPipeline[[diffusers.AnimateDiffVideoToVideoControlNetPipeline]]
#### diffusers.AnimateDiffVideoToVideoControlNetPipeline[[diffusers.AnimateDiffVideoToVideoControlNetPipeline]]
```python
diffusers.AnimateDiffVideoToVideoControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: diffusers.models.controlnets.controlnet.ControlNetModel | list[diffusers.models.controlnets.controlnet.ControlNetModel] | tuple[diffusers.models.controlnets.controlnet.ControlNetModel] | diffusers.models.controlnets.multicontrolnet.MultiControlNetModel, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L199)
**参数:**
vae ([AutoencoderKL](/docs/diffusers/v0.43.0/zh/api/models/autoencoderkl#diffusers.AutoencoderKL)):变分自编码器(VAE)模型,用于将图像编码为潜在表示,并从潜在表示解码回图像。
text_encoder (`CLIPTextModel`):冻结的文本编码器([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14))。
tokenizer (`CLIPTokenizer`):一个用于对文本进行分词的 [CLIPTokenizer](https://huggingface.co/docs/transformers/v5.22.2/en/model_doc/clip#transformers.CLIPTokenizer)。
unet ([UNet2DConditionModel](/docs/diffusers/v0.43.0/zh/api/models/unet2d-cond#diffusers.UNet2DConditionModel)):用于创建 UNetMotionModel 以对编码后的视频潜变量进行去噪的 [UNet2DConditionModel](/docs/diffusers/v0.43.0/zh/api/models/unet2d-cond#diffusers.UNet2DConditionModel)。
motion_adapter (`MotionAdapter`):一个 `MotionAdapter`,与 `unet` 配合使用,以对编码后的视频潜变量进行去噪。
controlnet ([ControlNetModel](/docs/diffusers/v0.43.0/zh/api/models/controlnet#diffusers.ControlNetModel) 或 `list[ControlNetModel]` 或 `tuple[ControlNetModel]` 或 `MultiControlNetModel`):在去噪过程中为 `unet` 提供额外的条件输入。如果以列表形式设置多个 ControlNet,则会将每个 ControlNet 的输出相加,以生成一个合并的额外条件输入。
scheduler ([SchedulerMixin](/docs/diffusers/v0.43.0/zh/api/schedulers/overview#diffusers.SchedulerMixin)):用于与 `unet` 配合以去除编码后的图像潜变量噪声的调度器。可以是 [DDIMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/ddim#diffusers.DDIMScheduler)、[LMSDiscreteScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) 或 [PNDMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/pndm#diffusers.PNDMScheduler) 之一。
用于在 ControlNet 引导下进行视频到视频生成的 Pipeline。
该模型继承自 [DiffusionPipeline](/docs/diffusers/v0.43.0/zh/api/pipelines/overview#diffusers.DiffusionPipeline)。有关为所有流水线实现的通用方法(下载、保存、在特定设备上运行等),请参阅父类文档。
该 pipeline 还继承了以下加载方法:
- 用于加载文本反转嵌入的 [load_textual_inversion()](/docs/diffusers/v0.43.0/zh/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion)
- 用于加载 LoRA 权重的 [load_lora_weights()](/docs/diffusers/v0.43.0/zh/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights)
- 用于保存 LoRA 权重的 [save_lora_weights()](/docs/diffusers/v0.43.0/zh/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights)
- 用于加载 IP Adapter 的 [load_ip_adapter()](/docs/diffusers/v0.43.0/zh/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter)
#### __调用__[[diffusers.AnimateDiffVideoToVideoControlNetPipeline.__call__]]
```python
__call__(video: list[list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]]] = None, prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, enforce_inference_steps: bool = False, timesteps: list[int] | None = None, sigmas: list[float] | None = None, guidance_scale: float = 7.5, strength: float = 0.8, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, guess_mode: bool = False, control_guidance_start: float | list[float] = 0.0, control_guidance_end: float | list[float] = 1.0, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'], decode_chunk_size: int = 16)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L909)
**参数:**
video (`list[PipelineImageInput]`) : 用于条件生成的输入视频。必须是一个包含视频图像/帧的列表。
prompt (`str` 或 `list[str]`,*可选*):用于引导图像生成的提示词或提示词列表。如果未定义,则需要传入 `prompt_embeds`。
height (`int`,*可选*,默认为 `self.unet.config.sample_size * self.vae_scale_factor`):生成视频的高度(以像素为单位)。
width (`int`,*可选*,默认为 `self.unet.config.sample_size * self.vae_scale_factor`):生成视频的像素宽度。
num_inference_steps (`int`,*可选*,默认值为 50):去噪步数。更多的去噪步数通常能生成更高质量的视频,但代价是推理速度变慢。
enforce_inference_steps (`bool`,*可选*,默认为 `False`):是否强制使用 `num_inference_steps` 个去噪步骤,而不受 `strength` 参数的影响。当设置为 `False` 时,实际推理步数会根据 `strength` 进行缩减。
timesteps (`list[int]`,*可选*):用于在支持 `set_timesteps` 方法中 `timesteps` 参数的调度器中,指定去噪过程所使用的自定义时间步。如果未定义,则使用传入 `num_inference_steps` 时的默认行为。必须按降序排列。
sigmas (`list[float]`, *可选*) : 用于支持在 `set_timesteps` 方法中接受 `sigmas` 参数的调度器的去噪过程的自定义 sigmas。如果未定义,将使用传入 `num_inference_steps` 时的默认行为。
strength (`float`,*可选*,默认值为 0.8):强度越高,原始视频与生成视频之间的差异越大。
guidance_scale (`float`, *可选*,默认值为 7.5):较高的 guidance scale 值会促使模型生成与文本 `prompt` 紧密相关的图像,但代价是图像质量降低。当 `guidance_scale > 1` 时,guidance scale 生效。
negative_prompt (`str` 或 `list[str]`,*可选*):用于指导图像生成中不应包含的内容的提示词或提示词列表。如果未定义,则需要改为传入 `negative_prompt_embeds`。在未使用引导(`guidance_scale < 1`)时将被忽略。
num_videos_per_prompt (`int`,*可选*,默认为 1):每个提示词生成的视频数量。
eta (`float`,*可选*,默认值为 0.0):对应 [DDIM](https://huggingface.co/papers/2010.02502) 论文中的参数 eta (η)。仅适用于 [DDIMScheduler](/docs/diffusers/v0.43.0/zh/api/schedulers/ddim#diffusers.DDIMScheduler),在其他调度器中会被忽略。
generator (`torch.Generator` 或 `list[torch.Generator]`,*可选*):用于使生成过程确定性的 [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html)。
latents (`torch.Tensor`, *可选*) : 从高斯分布中采样的预生成噪声潜变量,用作视频生成的输入。可用于使用不同的提示词对同一生成过程进行微调。如果未提供,则使用提供的随机`generator`进行采样来生成潜变量张量。潜变量的形状应为`(batch_size, num_channel, num_frames, height, width)`。
prompt_embeds (`torch.Tensor`, *可选*) : 预生成的文本嵌入。可用于轻松调整文本输入(提示词权重)。如果未提供,则从 `prompt` 输入参数生成文本嵌入。
negative_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的负向文本嵌入。可用于轻松调整文本输入(提示词权重)。如果未提供,`negative_prompt_embeds` 将从 `negative_prompt` 输入参数生成。
ip_adapter_image : (`PipelineImageInput`,*可选*):用于配合 IP Adapter 使用的可选图像输入。
ip_adapter_image_embeds (`list[torch.Tensor]`,*可选*):用于 IP-Adapter 的预生成图像嵌入。它应是一个列表,长度与 IP-Adapter 的数量相同。每个元素应为形状为 `(batch_size, num_images, emb_dim)` 的张量。如果 `do_classifier_free_guidance` 设置为 `True`,则应包含负向图像嵌入。如果未提供,嵌入将从 `ip_adapter_image` 输入参数计算得出。
conditioning_frames (`list[PipelineImageInput]`,*可选*):用于为 `unet` 提供生成引导的 ControlNet 输入条件。如果指定了多个 ControlNet,必须以列表形式传入图像,以便列表中的每个元素都能被正确批处理,作为单个 ControlNet 的输入。
output_type (`str`,*可选*,默认为 `"pil"`):生成视频的输出格式。可选 `torch.Tensor`、`PIL.Image` 或 `np.array`。
return_dict (`bool`,*可选*,默认为 `True`):是否返回 `AnimateDiffPipelineOutput` 而不是普通元组。
cross_attention_kwargs (`dict`, *可选*) : 一个 kwargs 字典,如果指定,将作为 [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py) 中定义的 `AttentionProcessor` 的参数传递。
controlnet_conditioning_scale (`float` 或 `list[float]`,*可选*,默认为 1.0) : ControlNet 的输出在加到原始 `unet` 的残差之前,会先乘以 `controlnet_conditioning_scale`。如果在 `init` 中指定了多个 ControlNet,可以将对应的 scale 设置为列表。
guess_mode (`bool`,*可选*,默认为 `False`):即使移除所有提示词,ControlNet 编码器也会尝试识别输入图像的内容。建议将 `guidance_scale` 的值设置在 3.0 到 5.0 之间。
control_guidance_start (`float` 或 `list[float]`,*可选*,默认为 0.0):ControlNet 开始生效的总步数百分比。
control_guidance_end (`float` 或 `list[float]`,*可选*,默认为 1.0):ControlNet 停止应用时的总步数百分比。
clip_skip (`int`, *可选*) : 在计算提示嵌入时,从 CLIP 中跳过的层数。值为 1 表示将使用倒数第二层的输出来计算提示嵌入。
callback_on_step_end (`Callable`,*可选*):一个在推理过程中每个去噪步骤结束时调用的函数。该函数以以下参数被调用:`callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`。`callback_kwargs` 将包含由 `callback_on_step_end_tensor_inputs` 指定的所有张量列表。
callback_on_step_end_tensor_inputs (`list`,*可选*):`callback_on_step_end` 函数的张量输入列表。列表中指定的张量将作为 `callback_kwargs` 参数传递。您只能包含流水线类的 `._callback_tensor_inputs` 属性中列出的变量。
decode_chunk_size (`int`,默认为 `16`):调用 `decode_latents` 方法时,每次解码的帧数。
**返回:** [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) 或 `tuple`
如果 `return_dict` 为 `True`,则返回 [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/zh/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput);否则返回一个 `tuple`,其中第一个元素是包含生成帧的列表。
用于生成的 pipeline 的调用函数。
示例:
#### encode_prompt[[diffusers.AnimateDiffVideoToVideoControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L287)
**参数:**
prompt (`str` 或 `list[str]`,*可选*):要编码的提示
device : (`torch.device`): torch 设备
num_images_per_prompt (`int`) : 每个提示词应生成的图像数量
do_classifier_free_guidance (`bool`) : 是否使用 classifier free guidance
negative_prompt (`str` 或 `list[str]`,*可选*):用于引导图像生成的负面提示词。如果未定义,则必须传入 `negative_prompt_embeds`。当不使用引导时(即 `guidance_scale` 小于 `1` 时),此参数将被忽略。
prompt_embeds (`torch.Tensor`, *可选*) : 预生成的文本嵌入。可用于轻松调整文本输入,*例如* 提示词加权。如果未提供,文本嵌入将从 `prompt` 输入参数生成。
negative_prompt_embeds (`torch.Tensor`, *可选*) : 预生成的负向文本嵌入。可用于轻松调整文本输入,*例如* 提示词权重。如果未提供,negative_prompt_embeds 将从 `negative_prompt` 输入参数生成。
lora_scale (`float`, *可选*) : 如果加载了 LoRA 层,将应用于文本编码器所有 LoRA 层的 LoRA 缩放系数。
clip_skip (`int`, *可选*) : 在计算提示嵌入时,从 CLIP 中跳过的层数。值为 1 表示将使用倒数第二层的输出来计算提示嵌入。
将提示词编码为文本编码器的隐藏状态。
## AnimateDiffPipelineOutput[[diffusers.pipelines.animatediff.AnimateDiffPipelineOutput]]
#### diffusers.pipelines.animatediff.AnimateDiffPipelineOutput[[diffusers.pipelines.animatediff.AnimateDiffPipelineOutput]]
```python
diffusers.pipelines.animatediff.AnimateDiffPipelineOutput(frames: typing.Union[torch.Tensor, numpy.ndarray, list[list[PIL.Image.Image]]])
```
[源代码](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_output.py#L11)
**参数:**
frames (`torch.Tensor`、`np.ndarray` 或 list[list[PIL.Image.Image]]) : 视频输出列表 - 它可以是一个长度为 `batch_size,` 的嵌套列表,其中每个子列表包含去噪后的
AnimateDiff 管线的输出类。
长度为 `num_frames.` 的 PIL 图像序列。它也可以是形状为 `(batch_size, num_frames, channels, height, width)` 的 NumPy 数组或 Torch 张量